介绍
到目前为止,Web 上的音频功能一直相当基础,而且直到
最近还必须通过 Flash 和
QuickTime 等插件来提供。HTML5 中引入
audio
元素
非常重要,它允许进行基本的流式音频播放。但是,它
的功能还不足以处理更复杂的音频应用程序。对于
复杂的基于 Web 的游戏或交互式应用程序,需要另一种
解决方案。本规范的目标是包含
现代游戏音频引擎中的功能,以及现代
桌面音频制作应用程序中的一些
混音、处理和滤波任务。
这些 API 的设计考虑了各种各样的用例 [webaudio-usecases]。理想情况下,它 应该能够支持 任何能够合理地通过由脚本控制并在浏览器中运行的 优化 C++ 引擎实现的用例。话虽如此,现代桌面音频软件 可以具有非常高级的 功能,其中有些功能很难甚至不可能使用 此系统构建。Apple 的 Logic Audio 就是这样一种应用程序,它 支持外部 MIDI 控制器、任意插件音频效果 和合成器、高度优化的直接磁盘音频文件 读写、紧密集成的时间拉伸等等。 尽管如此,所提议的系统将完全能够支持 大量相当复杂的游戏和交互式应用程序, 包括音乐类应用程序。而且它可以很好地补充 WebGL 所提供的更高级图形功能。该 API 的 设计使得将来可以添加更高级的功能。
特性
该 API 支持以下主要特性:
-
用于简单或复杂 混音/效果架构的模块化路由。
-
高动态范围,内部处理使用 32 位浮点数。
-
采样精确的计划声音播放, 为鼓机和音序器等 要求极高节奏精度的音乐应用程序提供低延迟。 这还包括 动态创建效果的可能性。
-
音频参数自动化,用于包络、淡入 / 淡出、粒子效果、滤波器扫描、LFO 等。
-
灵活处理音频流中的声道,允许 拆分和合并声道。
-
使用来自
MediaStream的实时音频输入, 该getUserMedia()获取。 -
与 WebRTC 集成
-
使用
MediaStreamTrackAudioSourceNode和 [webrtc] 处理从远程对等端接收的音频。 -
使用
MediaStreamAudioDestinationNode和 [webrtc] 将生成或处理后的音频流发送到远程 对等端。
-
-
直接 使用脚本进行音频流合成和处理。
-
支持各种 3D 游戏和沉浸式环境的空间化音频:
-
声像定位模型:equalpower、HRTF、直通
-
距离衰减
-
声音锥体
-
阻挡 / 遮蔽
-
基于声源 / 监听者
-
-
用于各种 线性效果的卷积引擎,尤其适用于高质量房间效果。 以下是一些可能的效果示例:
-
小型 / 大型房间
-
大教堂
-
音乐厅
-
洞穴
-
隧道
-
走廊
-
森林
-
圆形剧场
-
透过门口听到的远处房间声音
-
极端滤波器
-
奇异的反向效果
-
极端梳状滤波器效果
-
-
用于整体控制和优化混音的动态范围压缩
-
用于低通、高通和其他常见滤波器的高效双二阶滤波器。
-
用于失真和其他非线性效果的波形整形效果
-
振荡器
模块化路由
模块化路由允许不同
AudioNode
对象之间进行任意连接。每个节点都可以具有
输入和/或 输出。
源节点没有
输入,只有一个输出。
目标节点
有一个输入且没有输出。滤波器等其他节点
可以放置在源节点与目标节点之间。当两个对象连接在一起时,
开发者无需担心底层流格式
的细节;
系统会自动执行正确的处理。
例如,如果单声道音频流连接到
立体声输入,它应该直接适当地
混合到左右声道。
在最简单的情况下,可以将单个源直接路由到输出。
所有路由都发生在一个 AudioContext
中,其中包含单个 AudioDestinationNode:
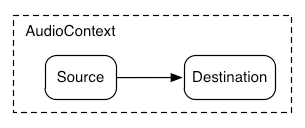
为了说明这种简单路由,下面是播放单个声音的简单示例:
const context= new AudioContext(); function playSound() { const source= context. createBufferSource(); source. buffer= dogBarkingBuffer; source. connect( context. destination); source. start( 0 ); }
下面是一个更复杂的示例,它包含三个源、一个卷积 混响发送以及最终输出阶段的动态压缩器:
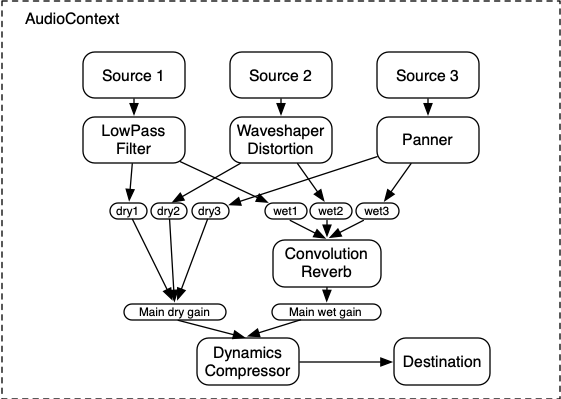
let context; let compressor; let reverb; let source1, source2, source3; let lowpassFilter; let waveShaper; let panner; let dry1, dry2, dry3; let wet1, wet2, wet3; let mainDry; let mainWet; function setupRoutingGraph() { context= new AudioContext(); // 创建效果节点。 lowpassFilter= context. createBiquadFilter(); waveShaper= context. createWaveShaper(); panner= context. createPanner(); compressor= context. createDynamicsCompressor(); reverb= context. createConvolver(); // 创建主湿声和干声。 mainDry= context. createGain(); mainWet= context. createGain(); // 将最终压缩器连接到最终目标。 compressor. connect( context. destination); // 将主干声和湿声连接到压缩器。 mainDry. connect( compressor); mainWet. connect( compressor); // 将混响连接到主湿声。 reverb. connect( mainWet); // 创建几个源。 source1= context. createBufferSource(); source2= context. createBufferSource(); source3= context. createOscillator(); source1. buffer= manTalkingBuffer; source2. buffer= footstepsBuffer; source3. frequency. value= 440 ; // 连接 source1 dry1= context. createGain(); wet1= context. createGain(); source1. connect( lowpassFilter); lowpassFilter. connect( dry1); lowpassFilter. connect( wet1); dry1. connect( mainDry); wet1. connect( reverb); // 连接 source2 dry2= context. createGain(); wet2= context. createGain(); source2. connect( waveShaper); waveShaper. connect( dry2); waveShaper. connect( wet2); dry2. connect( mainDry); wet2. connect( reverb); // 连接 source3 dry3= context. createGain(); wet3= context. createGain(); source3. connect( panner); panner. connect( dry3); panner. connect( wet3); dry3. connect( mainDry); wet3. connect( reverb); // 立即启动这些源。 source1. start( 0 ); source2. start( 0 ); source3. start( 0 ); }
模块化路由还允许将
AudioNode 的输出
路由到一个
AudioParam
参数,该参数控制另一个 AudioNode 的行为。在
这种情况下,一个节点的
输出可以充当调制信号,而不是
输入信号。
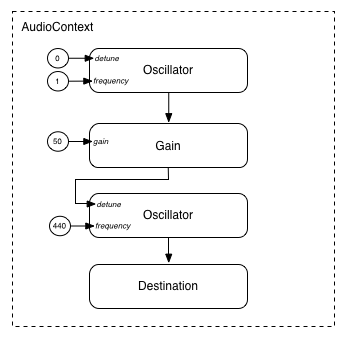
function setupRoutingGraph() { const context= new AudioContext(); // 创建提供调制信号的低频振荡器 const lfo= context. createOscillator(); lfo. frequency. value= 1.0 ; // 创建要被调制的高频振荡器 const hfo= context. createOscillator(); hfo. frequency. value= 440.0 ; // 创建一个增益节点,其增益决定调制信号的振幅 const modulationGain= context. createGain(); modulationGain. gain. value= 50 ; // 配置图并启动振荡器 lfo. connect( modulationGain); modulationGain. connect( hfo. detune); hfo. connect( context. destination); hfo. start( 0 ); lfo. start( 0 ); }
API 概述
定义了以下接口:
-
一个 AudioContext 接口,其中包含表示
AudioNode之间连接的音频信号图。 -
一个
AudioNode接口,表示 音频源、音频输出和中间处理模块。AudioNode可以以模块化方式 动态连接在一起。AudioNode存在于AudioContext的上下文中。 -
一个
AnalyserNode接口,它是一个AudioNode, 用于音乐可视化器或 其他可视化应用程序。 -
一个
AudioBuffer接口,用于处理 驻留在内存中的音频资源。它们可以表示一次性声音或 较长的音频片段。 -
一个
AudioBufferSourceNode接口,它是一个AudioNode, 用于从 AudioBuffer 生成音频。 -
一个
AudioDestinationNode接口,它是一个AudioNode子类,表示所有渲染音频的最终 目标。 -
一个
AudioParam接口,用于控制AudioNode功能的 某个方面, 例如音量。 -
一个
AudioListener接口,它与PannerNode配合进行空间化。 -
一个
AudioWorklet接口,表示 一个工厂,用于创建可以直接 使用脚本处理音频的自定义节点。 -
一个
AudioWorkletGlobalScope接口,即 AudioWorkletProcessor 处理脚本运行的上下文。 -
一个
AudioWorkletNode接口,它是一个AudioNode, 表示在 AudioWorkletProcessor 中处理的节点。 -
一个
AudioWorkletProcessor接口, 表示音频工作线程中的单个节点实例。 -
一个
BiquadFilterNode接口,它是一个AudioNode, 用于常见的低阶滤波器,例如:-
低通
-
高通
-
带通
-
低架
-
高架
-
峰值
-
陷波
-
全通
-
-
一个
ChannelMergerNode接口,它是一个AudioNode, 用于将多个 音频流中的声道合并为单个音频流。 -
一个
ChannelSplitterNode接口,它是一个AudioNode, 用于访问路由图中 音频流的各个声道。 -
一个
ConstantSourceNode接口,它是一个AudioNode, 用于生成名义上的恒定输出值, 并带有一个AudioParam以允许自动控制该值。 -
一个
ConvolverNode接口,它是一个AudioNode, 用于应用 实时线性效果(例如 音乐厅的声音)。 -
一个
DynamicsCompressorNode接口,它是一个AudioNode, 用于动态范围压缩。 -
一个
IIRFilterNode接口,它是一个AudioNode, 用于通用 IIR 滤波器。 -
一个
MediaElementAudioSourceNode接口,它是一个AudioNode, 其音频源来自audio、video或其他媒体元素。 -
一个
MediaStreamAudioSourceNode接口,它是一个AudioNode, 其音频源来自MediaStream, 例如实时音频输入或远程对等端。 -
一个
MediaStreamTrackAudioSourceNode接口, 它是一个AudioNode, 其音频源来自MediaStreamTrack。 -
一个
MediaStreamAudioDestinationNode接口, 它是一个AudioNode, 它是发送到远程对等端的MediaStream的音频目标。 -
一个
PannerNode接口,它是一个AudioNode, 用于在 3D 空间中对音频进行 空间化 / 定位。 -
一个
PeriodicWave接口,用于指定供OscillatorNode使用的自定义周期波形。 -
一个
OscillatorNode接口,它是一个AudioNode, 用于生成周期波形。 -
一个
StereoPannerNode接口,它是一个AudioNode, 用于在立体声流中对音频 输入进行等功率定位。 -
一个
WaveShaperNode接口,它是一个AudioNode, 用于应用非线性波形整形 效果,以产生失真和其他更细微的暖化效果。 -
一个
AudioPlaybackStats接口,它提供有关AudioContext所播放音频的统计信息。
Web Audio API 中还有一些已经弃用但 尚未移除的特性,以等待其替代方案的实现经验:
-
一个
ScriptProcessorNode接口,它是一个AudioNode, 用于直接 使用脚本生成或处理音频。 -
一个
AudioProcessingEvent接口,它是 与ScriptProcessorNode对象一起使用的事件类型。
1. 音频 API
1.1.
BaseAudioContext
接口
此接口表示一组 AudioNode
对象及其连接。它允许将信号任意路由到
AudioDestinationNode。
节点由上下文创建,然后再彼此连接。
BaseAudioContext
不会被直接实例化,
而是由具体接口
AudioContext
(用于实时渲染)和
OfflineAudioContext
(用于离线渲染)扩展。
BaseAudioContext
创建时具有一个内部槽
[[pending promises]],它是一个
初始为空的 promise 有序列表。
每个 BaseAudioContext
都具有唯一的
媒体元素事件任务源。
此外,一个 BaseAudioContext
具有多个私有槽 [[rendering thread state]] 和
[[control thread state]],它们
取自 AudioContextState
的值,
且二者最初都设置为 "suspended"
,[[state before interruption]]
也取自 AudioContextState
的值,
并且最初设置为
null,还有一个私有槽 [[render quantum
size]],它是一个无符号整数。
enum {AudioContextState "suspended" ,"running" ,"closed" ,"interrupted" };
| 枚举值 | 说明 |
|---|---|
"suspended"
| 此上下文当前已暂停(上下文时间不会 推进,音频硬件可能已断电/释放)。 |
"running"
| 正在处理音频。 |
"closed"
| 此上下文已被释放,不能再用于 处理音频。所有系统音频资源都已释放。 |
"interrupted"
| 此上下文当前被中断,在中断结束之前 无法处理音频。 |
enum {AudioContextRenderSizeCategory "default" ,"hardware" };
| 枚举说明 | |
|---|---|
"default"
| AudioContext 的渲染量子大小为默认值 128 帧。 |
"hardware"
|
用户代理选择一个最适合
当前配置的渲染量子大小。
注: 这会暴露有关 主机的信息,并可用于指纹识别。 |
callback DecodeErrorCallback =undefined (DOMException );error callback DecodeSuccessCallback =undefined (AudioBuffer ); [decodedData Exposed =Window ]interface BaseAudioContext :EventTarget {readonly attribute AudioDestinationNode destination ;readonly attribute float sampleRate ;readonly attribute double currentTime ;readonly attribute AudioListener listener ;readonly attribute AudioContextState state ;readonly attribute unsigned long renderQuantumSize ; [SameObject ,SecureContext ]readonly attribute AudioWorklet audioWorklet ;attribute EventHandler onstatechange ;AnalyserNode createAnalyser ();BiquadFilterNode createBiquadFilter ();AudioBuffer createBuffer (unsigned long ,numberOfChannels unsigned long ,length float );sampleRate AudioBufferSourceNode createBufferSource ();ChannelMergerNode createChannelMerger (optional unsigned long numberOfInputs = 6);ChannelSplitterNode createChannelSplitter (optional unsigned long numberOfOutputs = 6);ConstantSourceNode createConstantSource ();ConvolverNode createConvolver ();DelayNode createDelay (optional double maxDelayTime = 1.0);DynamicsCompressorNode createDynamicsCompressor ();GainNode createGain ();IIRFilterNode createIIRFilter (sequence <double >,feedforward sequence <double >);feedback OscillatorNode createOscillator ();PannerNode createPanner ();PeriodicWave createPeriodicWave (sequence <float >,real sequence <float >,imag optional PeriodicWaveConstraints = {});constraints ScriptProcessorNode createScriptProcessor (optional unsigned long bufferSize = 0,optional unsigned long numberOfInputChannels = 2,optional unsigned long numberOfOutputChannels = 2);StereoPannerNode createStereoPanner ();WaveShaperNode createWaveShaper ();Promise <AudioBuffer >decodeAudioData (ArrayBuffer ,audioData optional DecodeSuccessCallback ?,successCallback optional DecodeErrorCallback ?); };errorCallback
1.1.1. 属性
audioWorklet,类型为 AudioWorklet, 只读-
允许访问
Worklet对象,该对象可以通过由 [HTML] 和AudioWorklet定义的算法导入包含AudioWorkletProcessor类定义的脚本。 currentTime,类型为 double,只读-
这是上下文渲染图最近处理的音频块中 最后一个采样帧之后紧接着的采样帧的 时间,以秒为单位。如果 上下文的渲染图尚未处理任何音频块, 则
currentTime的值为 零。在
currentTime的时间坐标系中, 零值对应于图处理的第一个块中的 第一个采样帧。此系统中的经过时间 对应于BaseAudioContext所生成音频流中的经过时间,该时间可能不会 与系统中的其他时钟同步。(对于OfflineAudioContext, 由于该流 并未由任何设备主动播放,因此甚至不存在 对实时的近似。)Web Audio API 中所有计划时间都相对于
currentTime的值。当
BaseAudioContext处于 "running" 状态时, 此属性的值单调递增,并由 渲染线程以均匀增量更新, 每次对应一个渲染量子。因此,对于正在运行的 上下文,随着系统处理音频块,currentTime会稳定增加,并且始终表示 下一个要处理的音频块的开始时间。它也是 当前状态中计划的任何更改可能生效的 最早时间。currentTime在返回之前必须在控制线程上原子地 读取。 destination,类型为 AudioDestinationNode,只读-
一个只有单个输入的
AudioDestinationNode, 表示所有音频的最终目标。 通常这将表示实际的音频硬件。 所有正在主动渲染音频的AudioNode都会直接或间接连接到destination。 listener,类型为 AudioListener, 只读-
一个用于 3D 空间化的
AudioListener。 onstatechange,类型为 EventHandler-
一个属性,用于为 AudioContext 状态发生变化时 派发到
BaseAudioContext的事件设置事件处理程序(即对应的 promise 将会被兑现时)。此事件处理程序的事件类型为statechange。一个使用Event接口的事件将被派发到事件 处理程序,该处理程序可以直接查询 AudioContext 的状态。新创建的 AudioContext 始终以suspended状态开始,并且每当状态变化为不同状态时 都会触发状态变化事件。此 事件会在complete事件触发之前 触发。 sampleRate,类型为 float,只读-
BaseAudioContext处理音频时的采样率(以每秒采样帧数为单位)。 假定上下文中的所有AudioNode都以此速率运行。由于这一假设, 实时处理中不支持采样率转换器或 "varispeed" 处理器。 奈奎斯特频率是此采样率值的一半。 state,类型为 AudioContextState,只读-
描述
BaseAudioContext的当前状态。 获取此属性会返回[[control thread state]]槽的内容。 renderQuantumSize, 类型为 unsigned long,只读-
获取此属性会返回
[[render quantum size]]槽的值。
1.1.2. 方法
createAnalyser()-
用于
AnalyserNode的工厂方法。无参数。返回类型:AnalyserNode createBiquadFilter()-
用于
BiquadFilterNode的工厂方法, 它表示一个二阶滤波器,可以配置为 多种常见滤波器类型之一。无参数。返回类型:BiquadFilterNode createBuffer(numberOfChannels, length, sampleRate)-
创建给定大小的 AudioBuffer。缓冲区中的音频数据 将被零初始化(静音)。 如果任何参数为负数、零或超出其 标称范围,则必须抛出
NotSupportedError异常。BaseAudioContext.createBuffer() 方法的参数。 参数 类型 可为空 可选 说明 numberOfChannelsunsigned long✘ ✘ 确定缓冲区将具有多少个声道。实现必须支持至少 32 个声道。 lengthunsigned long✘ ✘ 以采样帧为单位确定缓冲区的大小。该值必须至少为 1。 sampleRatefloat✘ ✘ 描述缓冲区中线性 PCM 音频数据的采样率,以每秒采样帧数 表示。有关必须支持的范围,请参阅§ 2.4 支持的采样率。 返回类型:AudioBuffer createBufferSource()-
用于
AudioBufferSourceNode的工厂方法。无参数。返回类型:AudioBufferSourceNode createChannelMerger(numberOfInputs)-
用于
ChannelMergerNode的工厂方法, 它表示一个声道 合并器。如果IndexSizeError小于 1 或大于支持的声道数量,则必须抛出numberOfInputs异常。BaseAudioContext.createChannelMerger(numberOfInputs) 方法的参数。 参数 类型 可为空 可选 说明 numberOfInputsunsigned long✘ ✔ 确定输入数量。必须支持最多 32 的值。如果未指定, 则使用 6。返回类型:ChannelMergerNode createChannelSplitter(numberOfOutputs)-
用于
ChannelSplitterNode的工厂方法, 它表示一个声道 拆分器。如果numberOfOutputs小于 1 或大于支持的声道数量,则必须抛出IndexSizeError异常。BaseAudioContext.createChannelSplitter(numberOfOutputs) 方法的参数。 参数 类型 可为空 可选 说明 numberOfOutputsunsigned long✘ ✔ 输出数量。必须支持最多 32 的值。如果未指定,则 使用 6。返回类型:ChannelSplitterNode createConstantSource()-
用于
ConstantSourceNode的工厂方法。无参数。返回类型:ConstantSourceNode createConvolver()-
用于
ConvolverNode的工厂方法。无参数。返回类型:ConvolverNode createDelay(maxDelayTime)-
用于
DelayNode的工厂方法。 初始默认 延迟时间为 0 秒。BaseAudioContext.createDelay(maxDelayTime) 方法的参数。 参数 类型 可为空 可选 说明 maxDelayTimedouble✘ ✔ 指定延迟线允许的最大延迟时间,以秒为单位。如果指定,此值必须大于零且小于 三分钟,否则必须抛出 NotSupportedError异常。 如果未指定,则使用1。返回类型:DelayNode createDynamicsCompressor()-
用于
DynamicsCompressorNode的工厂方法。无参数。返回类型:DynamicsCompressorNode createGain()-
无参数。返回类型:
GainNode createIIRFilter(feedforward, feedback)-
BaseAudioContext.createIIRFilter() 方法的参数。 参数 类型 可为空 可选 说明 feedforwardsequence<double>✘ ✘ IIR 滤波器传递函数的前馈(分子)系数数组。 此数组的最大长度为 20。如果所有值均为零,则必须抛出 InvalidStateError异常。如果数组长度为 0 或 大于 20,则必须抛出NotSupportedError异常。feedbacksequence<double>✘ ✘ IIR 滤波器传递函数的反馈(分母)系数数组。 此数组的最大长度为 20。如果数组的第一个元素为 0, 则必须抛出 InvalidStateError异常。如果数组长度为 0 或 大于 20,则必须抛出NotSupportedError异常。返回类型:IIRFilterNode createOscillator()-
用于
OscillatorNode的工厂方法。无参数。返回类型:OscillatorNode createPanner()-
用于
PannerNode的工厂方法。无参数。返回类型:PannerNode createPeriodicWave(real, imag, constraints)-
用于创建
PeriodicWave的工厂方法。调用此方法时, 执行以下步骤:-
如果
real和imag的长度 不相同,则必须抛出IndexSizeError异常。 -
令 o 为一个类型为
PeriodicWaveOptions的新对象。 -
将 o 上的
disableNormalization属性设置为 传递给工厂方法的constraints属性的disableNormalization属性值。 -
构造一个新的
PeriodicWavep,将调用此工厂 方法的BaseAudioContext作为第一个参数,并传入 o。 -
返回 p。
BaseAudioContext.createPeriodicWave() 方法的参数。 参数 类型 可为空 可选 说明 realsequence<float>✘ ✘ 余弦参数序列。有关更详细的说明,请参阅其 real构造函数参数。imagsequence<float>✘ ✘ 正弦参数序列。有关更详细的说明,请参阅其 imag构造函数参数。constraintsPeriodicWaveConstraints✘ ✔ 如果未给出,则波形会被归一化。否则,波形根据 constraints给定的值进行归一化。返回类型:PeriodicWave -
createScriptProcessor(bufferSize, numberOfInputChannels, numberOfOutputChannels)-
用于
ScriptProcessorNode的工厂方法。 此方法已弃用,因为它旨在由AudioWorkletNode取代。 创建一个ScriptProcessorNode, 用于通过脚本直接处理音频。 如果bufferSize或numberOfInputChannels或numberOfOutputChannels超出有效范围,则必须抛出IndexSizeError异常。numberOfInputChannels和numberOfOutputChannels同时为零是无效的。 在这种情况下,必须抛出IndexSizeError异常。BaseAudioContext.createScriptProcessor(bufferSize, numberOfInputChannels, numberOfOutputChannels) 方法的参数。 参数 类型 可为空 可选 说明 bufferSizeunsigned long✘ ✔ bufferSize参数确定以采样帧为单位的缓冲区大小。如果未传入, 或者值为 0,则实现将为给定环境选择最佳缓冲区大小, 该大小在节点的整个生命周期内将保持为固定的 2 的幂。 否则,如果作者显式指定 bufferSize,则它必须是以下值之一:256、512、 1024、2048、4096、8192、16384。此值控制audioprocess事件的派发频率,以及每次调用需要处理多少采样帧。较低的bufferSize值会带来更低(更好)的延迟。为了避免音频断裂和故障, 则需要较高的值。建议作者不要指定此缓冲区大小, 而允许实现选择一个合适的缓冲区大小,以在延迟和音频 质量之间取得平衡。如果此参数的值不是上面列出的允许的 2 的幂值之一, 则必须抛出IndexSizeError异常。numberOfInputChannelsunsigned long✘ ✔ 此参数确定此节点输入的声道数量。默认 值为 2。必须支持最多 32 的值。如果不支持该声道数量,则必须抛出 NotSupportedError异常。numberOfOutputChannelsunsigned long✘ ✔ 此参数确定此节点输出的声道数量。默认 值为 2。必须支持最多 32 的值。如果不支持该声道数量,则必须抛出 NotSupportedError异常。返回类型:ScriptProcessorNode createStereoPanner()-
用于
StereoPannerNode的工厂方法。无参数。返回类型:StereoPannerNode createWaveShaper()-
用于
WaveShaperNode的工厂方法, 它表示一种非线性失真。无参数。返回类型:WaveShaperNode decodeAudioData(audioData, successCallback, errorCallback)-
异步解码
ArrayBuffer中包含的音频文件数据。 例如,可以在将responseType设置为"arraybuffer"后, 从XMLHttpRequest的response属性加载ArrayBuffer。 音频文件数据可以采用audio元素支持的任何格式。传递给decodeAudioData()的缓冲区,其 内容类型按照 [mimesniff] 中所述通过嗅探确定。尽管与此函数交互的主要方式 是通过其 promise 返回值,但为了 兼容旧版仍提供回调参数。
鼓励实现在文件损坏时警告作者。无法 抛出异常,因为这会造成破坏性更改。
注:如果压缩音频数据字节流已损坏,但 解码在其他方面仍可继续,则鼓励实现警告 作者,例如通过开发者工具。调用decodeAudioData时, 必须在控制 线程上执行以下步骤:-
如果 this 的相关全局对象的关联 Document不是完全活动的,则返回一个以 "
InvalidStateError"DOMException拒绝的 promise。 -
令 promise 为一个新的 Promise。
-
-
将 promise 追加到
[[pending promises]]。 -
分离
audioDataArrayBuffer。 如果此操作抛出异常,则跳转到步骤 4.1。 -
将一个解码操作排队,以便在另一个线程上执行。
-
-
否则,执行以下错误步骤:
-
令 error 为一个
DataCloneError。 -
使用 error 拒绝 promise,并将其从
[[pending promises]]中移除。 -
将媒体元素任务排队,以使用 error 调用
errorCallback。
-
-
返回 promise。
当将一个要在另一个线程上执行的解码操作排队时, 以下步骤必须发生在既不是 控制线程 也不是渲染 线程的线程上, 该线程称为解码线程。注: 多个
解码线程可以并行运行,以 服务对decodeAudioData的多个调用。-
令 can decode 为一个布尔标志,初始设置为 true。
-
尝试确定
audioData的 MIME 类型, 使用 MIME 嗅探 § 6.2 匹配音频或视频类型模式。如果音频 或 视频类型模式匹配算法返回undefined, 则将 can decode 设置为 false。 -
如果 can decode 为 true,尝试将已编码的
audioData解码为线性 PCM。 如果 失败,则将 can decode 设置为 false。如果媒体字节流包含多个音频轨道,则只将 第一个轨道解码为线性 pcm。
注: 需要对 解码过程进行更多控制的作者可以使用 [WEBCODECS]。
-
如果 can decode 为
false, 将媒体元素任务排队,以执行以下步骤:-
令 error 为一个名称为
EncodingError的DOMException。-
使用 error 拒绝 promise,并将其从
[[pending promises]]中移除。
-
-
如果
errorCallback未缺失, 则使用 error 调用errorCallback。
-
-
否则:
-
取得表示已解码线性 PCM 音频数据的结果,如果其采样率与
audioData的采样率不同,则将其重采样为BaseAudioContext的采样率。 -
将媒体元素任务排队,以执行以下步骤:
-
令 buffer 为一个
AudioBuffer, 其中包含最终结果 (可能执行采样率转换之后)。 -
使用 buffer 兑现 promise。
-
如果
successCallback未缺失,则使用 buffer 调用successCallback。
-
-
BaseAudioContext.decodeAudioData() 方法的参数。 参数 类型 可为空 可选 说明 audioDataArrayBuffer✘ ✘ 包含压缩音频数据的 ArrayBuffer。 successCallbackDecodeSuccessCallback?✔ ✔ 解码完成时将调用的回调函数。此回调的唯一 参数是表示已解码 PCM 音频数据的 AudioBuffer。 errorCallbackDecodeErrorCallback?✔ ✔ 解码音频文件发生错误时将调用的回调函数。 返回类型:Promise<AudioBuffer> -
1.1.3.
回调 DecodeSuccessCallback()
参数
decodedData, 类型为AudioBuffer-
包含已解码音频数据的 AudioBuffer。
1.1.4.
回调 DecodeErrorCallback()
参数
error, 类型为DOMException-
解码过程中发生的错误。
1.1.5. 生命周期
一旦创建,AudioContext
将持续播放
声音,直到没有更多声音可播放,或者页面消失。
1.1.6. 缺少内省或序列化原语
Web Audio API 对
音频源调度采用即发即弃的方式。也就是说,在 AudioContext
的生命周期内,每个音符都会创建一个源节点,
并且
从不显式地从图中移除。这与
序列化 API 不兼容,因为不存在可以
序列化的稳定节点集合。
此外,提供内省 API 将使内容脚本 能够观察垃圾回收。
1.1.7.
与 BaseAudioContext
子类关联的系统资源
子类 AudioContext
和 OfflineAudioContext
应被视为开销较大的对象。创建这些对象可能
涉及创建高优先级线程,或使用低延迟的
系统音频流,这两者都会影响能耗。
通常没有必要在一个文档中创建多个
AudioContext。
构造或恢复一个 BaseAudioContext
子类
会涉及为该上下文获取系统
资源。对于 AudioContext,
这还需要创建
系统音频流。当上下文
开始从其关联的音频图生成输出时,这些操作返回。
此外,用户代理可以具有由实现定义的
AudioContext
最大数量,
超过该数量后,任何
创建新的 AudioContext
的尝试都将失败,并抛出 NotSupportedError。
suspend
和 close
允许作者释放系统
资源,包括线程、
进程和音频流。暂停一个 BaseAudioContext
允许实现释放其部分资源,并
允许稍后通过调用
resume
继续运行。
关闭一个
AudioContext
允许实现释放其所有
资源,此后它不能再次使用或恢复。
注: 例如,这可能涉及等待 音频回调 定期触发,或等待硬件准备好进行 处理。
1.2.
AudioContext
接口
此接口表示一个音频图,其
AudioDestinationNode
被路由到一个实时
输出设备,该设备生成面向用户的信号。在大多数
用例中,每个文档只使用一个 AudioContext。
enum {AudioContextLatencyCategory "balanced" ,"interactive" ,"playback" };
| 枚举值 | 说明 |
|---|---|
"balanced"
| 在音频输出延迟与功耗之间取得平衡。 |
"interactive"
| 在不产生故障的情况下提供尽可能低的音频输出 延迟。这是默认值。 |
"playback"
| 相比音频输出延迟,优先保证持续、不中断的播放。 功耗最低。 |
enum {AudioSinkType "none" };
| 枚举值 | 说明 |
|---|---|
"none"
| 音频图将被处理,但不会通过 音频输出设备播放。 |
[Exposed =Window ]interface AudioContext :BaseAudioContext {constructor (optional AudioContextOptions contextOptions = {});readonly attribute double baseLatency ;readonly attribute double outputLatency ; [SecureContext ]readonly attribute (DOMString or AudioSinkInfo )sinkId ;attribute EventHandler onsinkchange ;attribute EventHandler onerror ; [SameObject ]readonly attribute AudioPlaybackStats playbackStats ;AudioTimestamp getOutputTimestamp ();Promise <undefined >resume ();Promise <undefined >suspend ();Promise <undefined >close (); [SecureContext ]Promise <undefined >((setSinkId DOMString or AudioSinkOptions ));sinkId MediaElementAudioSourceNode createMediaElementSource (HTMLMediaElement );mediaElement MediaStreamAudioSourceNode createMediaStreamSource (MediaStream );mediaStream MediaStreamTrackAudioSourceNode createMediaStreamTrackSource (MediaStreamTrack );mediaStreamTrack MediaStreamAudioDestinationNode createMediaStreamDestination (); };
如果用户代理
允许上下文状态从 "suspended"
转换为
"running",
则称一个 AudioContext
允许
启动。
用户代理可以禁止此初始转换,
并且仅当 AudioContext
的
相关全局对象具有
粘性激活时才允许它。
AudioContext
具有以下内部槽:
[[suspended by user]]-
表示上下文是否被用户代码暂停的布尔标志。 初始值为
false。 [[sink ID]]-
一个
DOMString或一个AudioSinkInfo, 分别表示当前音频输出设备的标识符 或信息。初始值为"",表示默认音频输出 设备。 [[sink ID at construction]]-
一个
DOMString或一个AudioSinkInfo, 分别表示构造时请求的音频输出设备的标识符 或信息。初始值为"",表示 默认音频输出设备。 [[pending resume promises]][[playback stats]]-
用于存储
AudioPlaybackStats实例的槽。
1.2.1. 构造函数
AudioContext(contextOptions)-
如果当前设置对象的相关全局对象的 关联 Document不是完全活动的,则抛出 "
创建InvalidStateError" 并中止这些步骤。AudioContext时,执行以下步骤:-
令 context 为一个新的
AudioContext对象。 -
将 context 上的
[[control thread state]]设置为suspended。 -
将 context 上的
[[rendering thread state]]设置为suspended。 -
将 context 上的
[[state before interruption]]设置为null。 -
令 messageChannel 为一个新的
MessageChannel。 -
令 controlSidePort 为 messageChannel 的
port1属性的值。 -
令 renderingSidePort 为 messageChannel 的
port2属性的值。 -
令 serializedRenderingSidePort 为 StructuredSerializeWithTransfer(renderingSidePort, « renderingSidePort ») 的结果。
-
将此
audioWorklet的port设置为 controlSidePort。 -
将控制消息排队, 以使用 serializedRenderingSidePort 在 AudioContextGlobalScope 上设置 MessagePort。
-
如果给出了
contextOptions,执行以下 子步骤:-
如果指定了
sinkId,令 sinkId 为contextOptions.的值,并 执行以下子步骤:sinkId-
如果 sinkId 和
[[sink ID]]都是DOMString类型, 并且二者相等,则中止这些 子步骤。 -
如果 sinkId 是
AudioSinkOptions类型,并且[[sink ID]]是AudioSinkInfo类型,并且 sinkId 中的type与[[sink ID]]中的type相等,则中止这些子步骤。 -
如果 sinkId 是
DOMString类型,则将[[sink ID at construction]]设置为 sinkId 并中止这些 子步骤。 -
如果 sinkId 是
AudioSinkOptions类型,则将[[sink ID at construction]]设置为一个新的AudioSinkInfo实例,该实例使用 sinkId 的type值创建。
-
-
按照
contextOptions.设置 context 的内部延迟, 如latencyHintlatencyHint中所述。 -
如果
contextOptions.已指定,则将 context 的sampleRatesampleRate设置为该值。否则,执行以下子步骤:-
如果 sinkId 是空字符串或
AudioSinkOptions类型,则使用默认输出 设备的采样率。中止这些子步骤。 -
如果 sinkId 是
DOMString, 则使用由 sinkId 标识的 输出设备的采样率。中止这些子步骤。
如果
contextOptions.与输出设备的采样率不同,则用户代理 必须对音频输出进行重采样,以匹配 输出设备的采样率。sampleRate注: 如果需要重采样, context 的延迟可能会 受到影响,并且影响可能很大。
-
-
根据
contextOptions.的值,设置 context 的renderSizeHint[[render quantum size]]:-
如果其默认值为
"default",则将[[render quantum size]]私有槽设置为 128。 -
否则,如果其值为
"hardware",则将[[render quantum size]]私有槽设置为 0。 -
否则,如果传入了整数,并且该值超出 § 2.5 支持的渲染量子 大小中指定的范围,则必须 抛出
NotSupportedError; 否则将[[render quantum size]]私有槽设置为传入的值。
-
-
-
将
[[playback stats]]设置为一个新的AudioPlaybackStats实例。 -
返回 context。
发送一条控制 消息以开始处理,意味着 执行以下步骤:-
令 validationResult 为对
[[sink ID at construction]]进行接收器标识符验证 的返回值。 -
如果 validationResult 为
false,执行以下步骤:-
将
[[sink ID]]设置为空字符串。 -
将媒体元素任务排队,以在
AudioContext上触发一个 名为error的事件, 并中止后续步骤。
-
-
尝试获取 系统资源,以根据
[[sink ID at construction]]使用以下音频输出设备 进行渲染:-
对于空字符串,使用默认音频输出设备。
-
由
[[sink ID at construction]]标识的音频输出设备。-
如果资源获取失败,则将媒体元素 任务排队,以在
AudioContext上触发一个名为error的事件,并 中止后续步骤。
-
-
-
将
[[sink ID]]设置为[[sink ID at construction]]的值。 -
将
AudioContext上的 this[[rendering thread state]]设置为running。 -
将媒体元素任务排队以执行 以下步骤:
-
如果
AudioContext的[[render quantum size]]为 0, 则将其设置为资源获取期间选择的实际硬件渲染量子大小。 -
将
AudioContext的state属性设置为 "running"。 -
在
AudioContext上触发一个名为statechange的事件。
-
注: 在不带参数构造
AudioContext且资源 获取失败的情况下,用户代理将尝试使用 模拟音频输出设备的机制静默渲染音频图。发送一条控制 消息以在AudioWorkletGlobalScope上设置MessagePort, 意味着在 渲染 线程上, 使用已经传输到AudioWorkletGlobalScope的 serializedRenderingSidePort 执行以下步骤:-
令 deserializedPort 为 StructuredDeserialize(serializedRenderingSidePort, 当前 Realm) 的结果。
-
将
port设置为 deserializedPort。
AudioContext.constructor(contextOptions) 方法的参数。 参数 类型 可为空 可选 说明 contextOptionsAudioContextOptions✘ ✔ 用于控制应如何构造 AudioContext的用户指定选项。 -
1.2.2. 属性
baseLatency, 类型为 double,只读-
这表示
AudioContext将音频从AudioDestinationNode传递到音频子系统时产生的处理延迟秒数。它不 包括由AudioDestinationNode输出与音频硬件之间的任何 其他处理可能导致的额外延迟, 特别是也不包括音频 图本身产生的任何延迟。例如,如果音频上下文以 44.1 kHz 运行并使用默认渲染 量子大小,并且
AudioDestinationNode内部实现双缓冲, 并且每个渲染量子都可以处理并输出音频,则 处理延迟约为 \((2\cdot128)/44100 = 5.805 \mathrm{ ms}\)。 outputLatency, 类型为 double,只读-
音频输出延迟的估计值,以秒为单位,即 用户代理请求主机系统播放缓冲区的时刻与 缓冲区中的第一个采样实际由音频输出设备 处理的时刻之间的间隔。对于 扬声器或耳机等产生声学 信号的设备,后一个时刻指采样的 声音产生的时刻。
outputLatency属性值取决于平台和 所连接的音频输出设备硬件。 在上下文 运行期间或关联的音频输出设备发生变化时,outputLatency属性值可能会发生变化。当需要精确 同步时,经常查询此值很有用。 sinkId, 类型为(DOMString or AudioSinkInfo),只读-
返回
[[sink ID]]内部槽的值。此 属性在更新时会被缓存,并且在 缓存后返回同一个对象。 onsinkchange, 类型为 EventHandler-
setSinkId()的事件处理程序。 此事件处理程序的事件类型为sinkchange。更改输出设备完成时将 派发此事件。注: 在
AudioContext构造过程中的初始 设备选择不会派发此事件。 可以使用statechange事件 来检查初始输出设备是否已就绪。 onerror, 类型为 EventHandler-
用于处理从
AudioContext派发的Event的事件处理程序。 此处理程序的事件 类型为error,并且 用户代理可以在以下情况下 派发此事件:-
初始化和激活选定音频设备时发生故障。
-
与
AudioContext关联的音频输出设备在 上下文处于running状态时断开连接。 -
操作系统报告音频设备故障时。
-
playbackStats, 类型为 AudioPlaybackStats,只读-
此
AudioContext的AudioPlaybackStats实例。 返回[[playback stats]]内部槽的值。
1.2.3. 方法
close()-
关闭
AudioContext, 释放正在使用的系统 资源。这不会自动释放 所有由AudioContext创建的 对象,但会暂停AudioContext的currentTime的推进,并停止 处理音频数据。调用 close 时,执行以下步骤:-
如果 this 的相关全局对象的关联 Document不是完全活动的,则返回一个以 "
InvalidStateError"DOMException拒绝的 promise。 -
令 promise 为一个新的 Promise。
-
如果
AudioContext上的[[control thread state]]标志为closed,则使用InvalidStateError拒绝 promise, 中止这些步骤, 并返回 promise。 -
将
AudioContext上的[[control thread state]]标志设置为closed。 -
将控制消息排队, 以关闭
AudioContext。 -
返回 promise。
运行一条控制 消息以关闭AudioContext意味着在 渲染 线程上运行以下步骤:-
尝试释放 系统资源。
-
将
[[rendering thread state]]设置为suspended。这将停止渲染。 -
如果此控制消息是为了响应 文档被卸载而运行的,则中止此算法。
在这种情况下无需通知控制线程。 -
将媒体元素任务排队以执行以下步骤:
-
兑现 promise。
-
如果
AudioContext的state属性尚未为 "closed":-
将
AudioContext的state属性设置为 "closed"。 -
将媒体元素任务排队,以在
AudioContext上触发 一个名为statechange的事件。
-
-
当
AudioContext被关闭时,任何连接到AudioContext的MediaStream和HTMLMediaElement的输出都将被忽略。也就是说,它们将不再向 扬声器或其他输出设备产生任何输出。若需要更灵活的 行为,请考虑使用HTMLMediaElement.captureStream()。注: 当
AudioContext已关闭时,实现可以 选择比暂停时更积极地释放更多资源。无参数。 -
createMediaElementSource(mediaElement)-
给定一个
HTMLMediaElement, 创建一个MediaElementAudioSourceNode。 调用此 方法的结果是,来自HTMLMediaElement的音频播放将被 重新路由到AudioContext的处理图中。AudioContext.createMediaElementSource() 方法的参数。 参数 类型 可为空 可选 说明 mediaElementHTMLMediaElement✘ ✘ 将被重新路由的媒体元素。 createMediaStreamDestination()-
创建一个
MediaStreamAudioDestinationNode无参数。 createMediaStreamSource(mediaStream)-
创建一个
MediaStreamAudioSourceNode。AudioContext.createMediaStreamSource() 方法的参数。 参数 类型 可为空 可选 说明 mediaStreamMediaStream✘ ✘ 将充当源的媒体流。 createMediaStreamTrackSource(mediaStreamTrack)-
创建一个
MediaStreamTrackAudioSourceNode。AudioContext.createMediaStreamTrackSource() 方法的参数。 参数 类型 可为空 可选 说明 mediaStreamTrackMediaStreamTrack✘ ✘ 将充当源的 MediaStreamTrack。其kind属性的值必须等于"audio",否则必须抛出InvalidStateError异常。 getOutputTimestamp()-
返回一个新的
AudioTimestamp实例, 其中包含该上下文的两个相关音频流位置 值:contextTime成员包含 当前正在由音频输出设备渲染的采样帧的时间 (即输出音频流 位置),其单位和原点与上下文的currentTime相同;performanceTime成员 包含一个时间估计值,表示与所存储contextTime值对应的采样帧由 音频输出设备渲染的时刻,其单位和 原点与performance.now()相同(在 [hr-time-3] 中描述)。如果上下文的渲染图尚未处理任何 音频块,则调用
getOutputTimestamp会返回一个AudioTimestamp实例,其两个 成员均包含零。上下文的渲染图开始处理 音频块后,其
currentTime属性值 始终大于通过调用getOutputTimestamp方法获得的contextTime值。getOutputTimestamp方法返回的值可以用于获得稍晚一些的 上下文时间值所对应的性能时间估计:function outputPerformanceTime( contextTime) { const timestamp= context. getOutputTimestamp(); const elapsedTime= contextTime- timestamp. contextTime; return timestamp. performanceTime+ elapsedTime* 1000 ; } 在上述示例中,估计的准确性取决于 参数值与当前输出音频 流位置的接近程度:给定的
contextTime越接近timestamp.contextTime, 所获得估计值的准确性就越高。注: 上下文的
currentTime与通过调用getOutputTimestamp方法获得的contextTime值之间的差值 不能被视为可靠的输出延迟估计, 因为currentTime可能会 以不均匀的时间间隔递增,因此应改用outputLatency属性。无参数。返回类型:AudioTimestamp resume()-
当
AudioContext已被暂停时,恢复其currentTime的推进。调用 resume 时, 执行以下步骤:-
如果 this 的相关全局对象的 关联 Document不是完全活动的,则返回 一个以 "
InvalidStateError"DOMException拒绝的 promise。 -
令 promise 为一个新的 Promise。
-
如果
AudioContext上的[[control thread state]]为closed,则使用InvalidStateError拒绝 promise, 中止这些步骤, 并返回 promise。 -
将
[[suspended by user]]设置为false。 -
如果上下文的
state属性为 "suspended" 并且上下文的[[control thread state]]为 "interrupted", 则:-
将媒体元素任务排队以 执行以下步骤:
-
将
AudioContext的state属性设置为 "interrupted"。 -
将
[[state before interruption]]槽设置为 "running"。 -
将媒体元素 任务排队,以在
AudioContext上触发一个名为statechange的事件。
-
-
使用
InvalidStateError拒绝 promise, 中止这些 步骤,并返回 promise。
-
-
如果上下文不允许启动,则将 promise 追加到
[[pending promises]]和[[pending resume promises]]中,并中止 这些步骤,返回 promise。 -
将
AudioContext上的[[control thread state]]设置为running。 -
将控制消息排队, 以使用 promise 恢复
AudioContext。 -
返回 promise。
运行一条控制 消息以恢复AudioContext意味着在 渲染 线程上运行以下步骤:-
令 promise 为传入此算法的 promise。
-
尝试获取系统资源。
-
将
AudioContext上的[[rendering thread state]]设置为running。 -
开始渲染音频图。
-
如果失败, 将媒体元素任务排队以执行以下步骤:
-
按顺序拒绝
[[pending resume promises]]中的所有 promise,然后清空[[pending resume promises]]。 -
此外,从
[[pending promises]]中移除这些 promise。
-
-
将媒体元素任务排队以执行以下步骤:
-
如果
AudioContext的[[render quantum size]]为 0, 则将其设置为资源获取期间选择的实际硬件渲染量子大小。 -
按顺序兑现
[[pending resume promises]]中的所有 promise。 -
清空
[[pending resume promises]]。 此外,从[[pending promises]]中移除这些 promise。 -
兑现 promise。
-
如果
AudioContext的state属性尚未为 "running":-
将
AudioContext的state属性设置为 "running"。 -
将媒体元素 任务排队,以在
AudioContext上触发一个名为statechange的事件。
-
-
无参数。 -
suspend()-
暂停
AudioContext的currentTime的推进, 允许任何已经处理完成的 当前上下文处理块播放到目标,然后允许系统 释放其对音频硬件的占用。这通常在 应用程序知道一段时间内不需要AudioContext并希望暂时 释放系统资源 与AudioContext关联时很有用。 当帧缓冲区 为空(已移交给硬件)时,promise 会兑现;如果上下文已经suspended,则立即兑现 (且不会产生其他影响)。如果上下文 已关闭,则 promise 会被拒绝。调用 suspend 时,执行以下步骤:-
如果 this 的相关全局对象的关联 Document不是完全活动的,则返回一个以 "
InvalidStateError"DOMException拒绝的 promise。 -
令 promise 为一个新的 Promise。
-
如果
AudioContext上的[[control thread state]]为closed,则使用InvalidStateError拒绝 promise, 中止这些步骤, 并返回 promise。 -
将 promise 追加到
[[pending promises]]。 -
将
[[suspended by user]]设置为true。 -
将
AudioContext上的[[control thread state]]设置为suspended。 -
将控制消息排队, 以使用 promise 暂停
AudioContext。 -
返回 promise。
运行一条控制 消息以暂停AudioContext意味着在 渲染 线程上运行以下步骤:-
令 promise 为传入此算法的 promise。
-
尝试释放 系统资源。
-
如果
AudioContext上的[[rendering thread state]]为 "interrupted", 则将媒体元素 任务排队,以将[[state before interruption]]槽设置为 "suspended"。 -
将
AudioContext上的[[rendering thread state]]设置为 "suspended"。 -
将媒体元素任务排队以执行 以下步骤:
-
兑现 promise。
-
如果
AudioContext的state属性尚未为 "suspended":-
将
AudioContext的state属性设置为 "suspended"。 -
将媒体元素 任务排队,以在
AudioContext上触发一个名为statechange的事件。
-
-
当
AudioContext处于暂停状态时,MediaStream的输出将被忽略;也就是说, 由于媒体流的实时性质,数据将丢失。HTMLMediaElement的输出同样会被忽略,直到系统恢复。AudioWorkletNode和ScriptProcessorNode在暂停期间将停止调用其 处理程序,但会在上下文恢复时继续。 对于AnalyserNode窗函数,数据被视为 连续流——即resume()/suspend()不会导致AnalyserNode的数据流中出现静音。 特别是,当AudioContext处于暂停状态时,重复调用AnalyserNode函数必须返回相同的 数据。无参数。 -
setSinkId((DOMString or AudioSinkOptions) sinkId)-
设置输出设备的标识符。调用此方法时, 用户代理必须执行以下步骤:
-
令 sinkId 为该方法的第一个参数。
-
如果 sinkId 等于
[[sink ID]], 则返回一个 promise,立即兑现它并中止这些步骤。 -
令 validationResult 为对 sinkId 进行接收器标识符验证 的返回值。
-
如果 validationResult 为
false,则返回一个 以新DOMException拒绝的 promise,该异常的名称为 "NotAllowedError"。 中止这些步骤。 -
令 p 为一个新的 promise。
-
发送一条带有 p 和 sinkId 的控制消息以开始 处理。
-
返回 p。
在setSinkId()期间发送一条控制 消息以开始处理, 意味着执行以下步骤:-
令 p 为传入此算法的 promise。
-
令 sinkId 为传入此算法的接收器标识符。
-
如果 sinkId 和
[[sink ID]]都是DOMString类型, 并且二者相等,则 将媒体元素任务排队以兑现 p 并中止这些步骤。 -
如果 sinkId 是
AudioSinkOptions类型,并且[[sink ID]]是AudioSinkInfo类型,并且 sinkId 中的type与[[sink ID]]中的type相等, 则 将媒体元素任务排队以兑现 p 并中止这些步骤。 -
令 wasRunning 为 true。
-
如果
AudioContext上的[[rendering thread state]]为"suspended",则将 wasRunning 设置为 false。 -
处理完当前渲染量子后暂停渲染器。
-
尝试释放 系统资源。
-
如果 wasRunning 为 true:
-
将
AudioContext上的[[rendering thread state]]设置为"suspended"。 -
将媒体元素任务排队以执行以下步骤:
-
如果
AudioContext的state属性尚未为 "suspended":-
将
AudioContext的state属性设置为 "suspended"。 -
在 关联的
AudioContext上触发一个名为statechange的事件。
-
-
-
-
尝试获取系统资源,以 根据
[[sink ID]]使用以下音频输出设备 进行渲染:-
对于空字符串,使用默认音频输出设备。
-
由
[[sink ID]]标识的音频输出设备。
如果失败,则使用 "
InvalidAccessError" 拒绝 p, 并中止 后续步骤。 -
-
将媒体元素任务排队以执行以下步骤:
-
如果 sinkId 是
DOMString类型,则将[[sink ID]]设置为 sinkId。中止这些步骤。 -
如果 sinkId 是
AudioSinkOptions类型,并且[[sink ID]]是DOMString类型,则将[[sink ID]]设置为一个新的AudioSinkInfo实例,该实例使用 sinkId 的type值创建。 -
如果 sinkId 是
AudioSinkOptions类型,并且[[sink ID]]是AudioSinkInfo类型,则将[[sink ID]]的type设置为 sinkId 的type值。 -
兑现 p。
-
在 关联的
AudioContext上触发一个名为sinkchange的事件。
-
-
如果 wasRunning 为 true:
-
将
AudioContext上的[[rendering thread state]]设置为"running"。 -
将媒体元素任务排队以执行以下步骤:
-
如果
AudioContext的state属性尚未为 "running":-
将
AudioContext的state属性设置为 "running"。 -
在 关联的
AudioContext上触发一个名为statechange的事件。
-
-
-
-
1.2.4.
验证 sinkId
此算法用于验证为修改
sinkId
而提供的信息:
-
令 document 为当前设置对象的关联 Document。
-
令 sinkIdArg 为传入此算法的值。
-
如果不允许 document 使用由
"speaker-selection"标识的特性,则返回false。 -
如果 sinkIdArg 是
DOMString类型,但它不等于空 字符串,或者它与enumerateDevices()所提供结果中标识的任何音频输出设备都不匹配, 则返回false。 -
返回
true。
1.2.5.
AudioContextOptions
AudioContextOptions
字典用于
为 AudioContext
指定用户定义的选项。
dictionary AudioContextOptions { (AudioContextLatencyCategory or double )latencyHint = "interactive";float sampleRate ; (DOMString or AudioSinkOptions )sinkId ; (AudioContextRenderSizeCategory or unsigned long )renderSizeHint = "default"; };
1.2.5.1.
字典 AudioContextOptions
成员
latencyHint, 类型为(AudioContextLatencyCategory or double),默认值为"interactive"-
标识播放类型,这会影响 音频输出延迟与功耗之间的权衡。
latencyHint的首选值是AudioContextLatencyCategory中的一个值。 不过,也可以指定一个 double,表示延迟秒数,以便更精细地控制延迟与功耗 之间的平衡。如何适当地解释 该数值由浏览器自行决定。实际使用的延迟由 AudioContext 的baseLatency属性给出。 sampleRate, 类型为 float-
将要创建的
AudioContext的sampleRate设置为此值。有关所需支持的范围,请参阅 § 2.4 支持的采样率。如果未指定
sampleRate, 则使用此AudioContext的输出设备的首选采样率。 sinkId, 类型为(DOMString or AudioSinkOptions)-
音频输出设备的标识符或相关信息。 有关更多详细信息,请参阅
sinkId。 renderSizeHint, 类型为(AudioContextRenderSizeCategory or unsigned long),默认值为"default"-
当传入整数时,这允许用户请求特定的渲染量子大小;如果未传入任何值或传入
"default",则使用默认的 128 帧;如果指定了"hardware", 则要求用户代理选择合适的 渲染量子 大小。有关所需支持的范围,请参阅§ 2.5 支持的渲染量子大小。
这只是一个提示,可能不会被遵循。
1.2.6.
AudioSinkOptions
AudioSinkOptions
字典用于为
sinkId
指定选项。
dictionary AudioSinkOptions {required AudioSinkType type ; };
1.2.6.1.
字典 AudioSinkOptions
成员
type, 类型为 AudioSinkType-
一个
AudioSinkType值,用于指定设备的类型。
1.2.7.
AudioSinkInfo
AudioSinkInfo
接口用于通过 sinkId
获取有关当前
音频输出设备的信息。
[Exposed =Window ]interface AudioSinkInfo {readonly attribute AudioSinkType type ; };
1.2.7.1. 属性
type, 类型为 AudioSinkType,只读-
表示设备类型的
AudioSinkType值。
1.2.8.
AudioTimestamp
dictionary AudioTimestamp {double contextTime ;DOMHighResTimeStamp performanceTime ; };
1.2.8.1.
字典 AudioTimestamp
成员
contextTime, 类型为 double-
表示 BaseAudioContext 的
currentTime时间坐标系中的一个时间点。 performanceTime, 类型为 DOMHighResTimeStamp-
表示
Performance接口实现的时间坐标系中的一个时间点(在 [hr-time-3] 中描述)。
1.3.
OfflineAudioContext
接口
OfflineAudioContext
是一种特殊类型的
BaseAudioContext,
用于(可能)快于实时地进行渲染/混缩。
它不会渲染到音频硬件,而是尽可能快地进行渲染,并使用渲染结果
作为一个
AudioBuffer
来兑现返回的 promise。
[Exposed =Window ]interface OfflineAudioContext :BaseAudioContext {constructor (OfflineAudioContextOptions contextOptions );constructor (unsigned long numberOfChannels ,unsigned long length ,float sampleRate );Promise <AudioBuffer >startRendering (optional unsigned long ?chunkSize =null );Promise <undefined >resume ();Promise <undefined >suspend (double );suspendTime Promise <undefined >close ();readonly attribute unsigned long ?length ;attribute EventHandler oncomplete ; };
OfflineAudioContext
具有以下内部槽:
[[rendering started]]-
表示渲染是否已开始的布尔标志。其 初始值为
false。 [[rendered buffers]]-
正在渲染的
AudioBuffer的有序列表。初始 值为空列表。 [[committed frames]]-
跟踪
OfflineAudioContext已提交进行渲染的帧数。初始值为0。 [[rendered frames]]-
跟踪已经渲染的帧数。初始值 为
0。
1.3.1. 构造函数
OfflineAudioContext(contextOptions)-
如果当前设置对象的相关全局对象的 关联 Document不是完全活动的, 则抛出一个
令 c 为一个新的InvalidStateError并中止这些步骤。OfflineAudioContext对象。 按如下方式初始化 c:-
将 c 的
[[control thread state]]设置为"suspended"。 -
将 c 的
[[rendering thread state]]设置为"suspended"。 -
根据
contextOptions.的值,设置 c 的sampleRatesampleRate。 -
根据
contextOptions.的值,确定 c 的renderSizeHint[[render quantum size]]:-
如果其默认值为
"default"或"hardware",则将[[render quantum size]]私有 槽设置为 128。 -
否则,如果传入了一个整数,并且该值超出 § 2.5 支持的渲染量子大小 中指定的范围,则必须 抛出
NotSupportedError; 否则将[[render quantum size]]私有槽设置为传入的值。
-
-
构造一个
AudioDestinationNode, 并将其channelCount设置为contextOptions.numberOfChannels。 -
令 messageChannel 为一个新的
MessageChannel。 -
令 controlSidePort 为 messageChannel 的
port1属性的值。 -
令 renderingSidePort 为 messageChannel 的
port2属性的值。 -
令 serializedRenderingSidePort 为 StructuredSerializeWithTransfer(renderingSidePort, « renderingSidePort ») 的结果。
-
将此
audioWorklet的port设置为 controlSidePort。 -
将控制消息排队, 以使用 serializedRenderingSidePort 在 AudioContextGlobalScope 上设置 MessagePort。
OfflineAudioContext.constructor(contextOptions) 方法的参数。 参数 类型 可为空 可选 说明 contextOptions构造此上下文所需的初始参数。 -
OfflineAudioContext(numberOfChannels, length, sampleRate)-
OfflineAudioContext可以使用与 AudioContext.createBuffer 相同的参数 进行构造。如果任何 参数为负数、零或超出其标称 范围,则必须抛出NotSupportedError异常。OfflineAudioContext 的构造效果等同于调用
new OfflineAudioContext({ numberOfChannels: numberOfChannels, length: length, sampleRate: sampleRate}) 。
OfflineAudioContext.constructor(numberOfChannels, length, sampleRate) 方法的参数。 参数 类型 可为空 可选 说明 numberOfChannelsunsigned long✘ ✘ 确定缓冲区将具有多少个声道。有关支持的声道数量,请参阅 createBuffer()。lengthunsigned long✘ ✘ 以采样帧为单位确定音频渲染的总大小。 sampleRatefloat✘ ✘ 描述缓冲区中线性 PCM 音频数据的采样率,以每秒采样帧数 表示。有关所需支持的范围,请参阅§ 2.4 支持的采样率。
1.3.2. 属性
length, 类型为 unsigned long,只读,可为空-
以采样帧为单位表示音频渲染的总大小。该值与构造函数的
length参数值相同。对于未定义长度的渲染,此属性应该设置为
null。 oncomplete, 类型为 EventHandler-
此事件处理程序的事件类型为
complete。派发到 该事件处理程序的事件将使用OfflineAudioCompletionEvent接口。它是在OfflineAudioContext上触发的最后一个事件。
1.3.3. 方法
startRendering(chunkSize)-
根据当前连接和已计划的更改,开始 渲染音频。
尽管获取渲染后音频数据的主要方式 是通过其 promise 返回值,但出于兼容旧版的原因,该实例还会触发一个 名为
complete的事件。调用startRendering时, 必须在控制 线程上执行以下步骤:- 如果 this 的相关全局对象的关联 Document不是完全活动的,则返回一个以 "
InvalidStateError"DOMException拒绝的 promise。 - 令 promise 为一个新的 promise。
- 如果
OfflineAudioContext上的[[control thread state]]为closed, 则使用InvalidStateError拒绝 promise,并中止这些 步骤。 - 如果
OfflineAudioContext的length不为null,并且[[committed frames]]大于或等于OfflineAudioContext的length, 则使用InvalidStateError拒绝 promise,并中止这些 步骤。 -
令 bufferLength 为一个初始化为
chunkSize值的数字。-
如果
OfflineAudioContext的length为null: -
否则,如果
OfflineAudioContext的length不为null:- 如果
chunkSize不为null,且[[committed frames]]+chunkSize小于OfflineAudioContext的length, 则将 bufferLength 设置为chunkSize。 - 否则,将 bufferLength 设置为
length-[[committed frames]]。
- 如果
-
如果
- 如果 bufferLength 不是 渲染 量子大小的整数倍,则将其向上取整为下一个 渲染量子大小的整数倍。
- 创建一个新的
AudioBufferbuffer,其声道数和采样率分别等于 在contextOptions参数中传递给此实例构造函数的numberOfChannels和sampleRate值; 长度等于 bufferLength。 - 如果前面的
AudioBuffer构造函数调用期间抛出了异常,则使用 此异常拒绝 promise,并返回 promise。 - 将
[[rendering started]]设置为 true。 - 将
[[committed frames]]设置为[[committed frames]]与 buffer 的length之和。 - 将 buffer 追加到
[[rendered buffers]]中,并为 buffer 开始离线渲染。 - 将 promise 追加到
[[pending promises]]。 - 返回 promise。
要为AudioBufferbuffer 开始离线渲染,以下步骤必须发生在为此创建的渲染 线程上。- 根据当前连接和已计划的更改,开始将
buffer 的
length个音频采样帧渲染到 buffer 中。 - 对于每个渲染
量子,进行检查,并在必要时
suspend渲染。 - 如果已暂停的上下文恢复,则继续渲染 缓冲区。
-
渲染完成后,
将媒体元素任务排队以执行以下步骤:
- 使用 buffer 兑现由
startRendering()创建的 promise。 - 从
[[pending promises]]中移除 promise。 - 从
[[rendered buffers]]中移除 buffer。 - 将
[[rendered frames]]设置为[[rendered frames]]与 buffer 的length之和。 -
如果
length不为null:- 如果
[[rendered frames]]大于或 等于length, 则将 控制消息排队以关闭OfflineAudioContext。 - 将媒体元素任务排队,
以使用
OfflineAudioCompletionEvent在OfflineAudioContext上触发一个名为complete的事件,其中renderedBuffer属性设置为 buffer。
- 如果
- 使用 buffer 兑现由
OfflineAudioContext.startRendering(chunkSize) 方法的参数。 参数 类型 可为空 可选 说明 chunkSizeunsigned long?✔ ✔ 此调用期间要渲染的采样帧数。 返回类型:Promise<AudioBuffer> - 如果 this 的相关全局对象的关联 Document不是完全活动的,则返回一个以 "
resume()-
当
OfflineAudioContext已暂停时,恢复其currentTime的推进。调用 resume 时, 执行以下步骤:-
如果 this 的相关全局对象的关联 Document不是完全活动的,则返回 一个以 "
InvalidStateError"DOMException拒绝的 promise。 -
令 promise 为一个新的 Promise。
-
当以下任一条件为真时,中止这些步骤,并使用
InvalidStateError拒绝 promise:-
OfflineAudioContext上的[[control thread state]]为closed。 -
OfflineAudioContext上的[[rendering started]]槽为 false。
-
-
将
OfflineAudioContext上的[[control thread state]]标志设置为running。 -
将控制消息排队, 以恢复
OfflineAudioContext。 -
返回 promise。
运行一条控制 消息以恢复OfflineAudioContext意味着在 渲染 线程上运行以下步骤:-
将
OfflineAudioContext上的[[rendering thread state]]设置为running。 -
开始渲染音频图。
-
如果失败, 将媒体元素任务排队以拒绝 promise 并中止剩余 步骤。
-
将媒体元素任务排队以执行以下步骤:
-
兑现 promise。
-
如果
OfflineAudioContext的state属性尚未为 "running":-
将
OfflineAudioContext的state属性设置为 "running"。 -
将媒体元素 任务排队,以在
OfflineAudioContext上触发一个名为statechange的事件。
-
-
无参数。 -
suspend(suspendTime)-
计划在指定时间暂停音频 上下文中的时间推进,并返回一个 promise。这通常适用于 在
OfflineAudioContext上同步操作音频图时。请注意,暂停的最大精度为 渲染量子 的大小,指定的暂停时间 将向上舍入到最近的渲染量子 边界。因此,不允许在同一个量化帧上计划 多次暂停。此外,为确保 精确暂停,应在上下文未运行时进行计划。
OfflineAudioContext.suspend() 方法的参数。 参数 类型 可为空 可选 说明 suspendTimedouble✘ ✘ 计划在指定时间暂停渲染,该时间会被量化并 向上舍入到渲染量子大小。如果量化后的帧号 - 为负数,或
- 小于或等于当前时间,或
- 大于或等于总渲染时长,或
- 同一时间已由另一个 suspend 进行计划,
InvalidStateError拒绝 promise。 close()-
关闭
OfflineAudioContext。 这不会自动释放 所有由AudioContext创建的 对象,但会暂停AudioContext的currentTime的推进,并停止 处理音频数据。调用 close 时,执行以下步骤:-
如果 this 的相关全局对象的 关联 Document不是完全活动的,则返回 一个以 "
InvalidStateError"DOMException拒绝的 promise。 -
令 promise 为一个新的 Promise。
-
如果
OfflineAudioContext上的[[control thread state]]标志为closed,则使用InvalidStateError拒绝 promise, 中止这些步骤, 并返回 promise。 -
将
OfflineAudioContext上的[[control thread state]]标志设置为closed。 -
将控制消息排队, 以关闭
OfflineAudioContext。 -
返回 promise。
运行一条控制 消息以关闭OfflineAudioContext意味着在渲染线程上运行以下步骤:-
将
[[rendering thread state]]设置为suspended。这将停止渲染。 -
如果此控制消息是为了响应 文档被卸载而运行的,则中止此算法。
在这种情况下无需通知控制线程。 -
将媒体元素任务排队以执行以下步骤:
-
兑现 promise。
-
如果
OfflineAudioContext的state属性尚未为 "closed":-
将
OfflineAudioContext的state属性设置为 "closed"。
-
将媒体元素任务排队,以在
OfflineAudioContext上触发一个名为statechange的事件。
-
-
-
1.3.4.
OfflineAudioContextOptions
这指定了构造
OfflineAudioContext
时使用的选项。
dictionary OfflineAudioContextOptions {unsigned long numberOfChannels = 1;unsigned long ?length =null ;required float sampleRate ; (AudioContextRenderSizeCategory or unsigned long )renderSizeHint = "default"; };
1.3.4.1.
字典 OfflineAudioContextOptions
成员
length, 类型为 unsigned long,可为空,默认值为null-
渲染后的
AudioBuffer的长度,以采样帧为单位。 numberOfChannels, 类型为 unsigned long,默认值为1-
此
OfflineAudioContext的声道数量。 sampleRate, 类型为 float-
此
OfflineAudioContext的采样率。有关所需支持的范围,请参阅 § 2.4 支持的采样率。 renderSizeHint, 类型为(AudioContextRenderSizeCategory or unsigned long),默认值为"default"-
用于此
OfflineAudioContext的渲染量子大小的提示。 有关所需支持的范围,请参阅§ 2.5 支持的渲染量子大小。
1.3.5.
OfflineAudioCompletionEvent
接口
这是一个出于兼容旧版原因而派发到
OfflineAudioContext
的 Event
对象。
[Exposed =Window ]interface OfflineAudioCompletionEvent :Event {(constructor DOMString ,type OfflineAudioCompletionEventInit );eventInitDict readonly attribute AudioBuffer renderedBuffer ; };
1.3.5.1. 属性
renderedBuffer, 类型为 AudioBuffer, 只读-
一个包含渲染后音频数据的
AudioBuffer。
1.3.5.2.
OfflineAudioCompletionEventInit
dictionary OfflineAudioCompletionEventInit :EventInit {required AudioBuffer renderedBuffer ; };
1.3.5.2.1.
字典 OfflineAudioCompletionEventInit
成员
renderedBuffer, 类型为 AudioBuffer-
要赋给事件的
renderedBuffer属性的值。
1.4.
AudioBuffer
接口
此接口表示驻留在内存中的音频资源。它可以包含一个或
多个声道,其中每个声道表现为 32 位浮点
线性 PCM 值,标称
范围为 \([-1,1]\),但这些
值并不限于该范围。通常预计
PCM 数据的长度会相当短(通常略短于一分钟)。
对于音乐配乐等较长的声音,应使用
audio
元素和
MediaElementAudioSourceNode
进行流式传输。
一个 AudioBuffer
可以由一个或多个
AudioContext
使用,并且可以在
OfflineAudioContext
与
AudioContext
之间共享。
AudioBuffer
具有四个内部槽:
[[number of channels]]-
此
AudioBuffer的音频声道数量,它是一个 unsigned long。 [[length]]-
此
AudioBuffer每个声道的长度,它是一个 unsigned long。 [[sample rate]]-
此
AudioBuffer的采样率,以 Hz 为单位,是一个 float。 [[internal data]]-
保存音频采样数据的数据块。
[Exposed =Window ]interface AudioBuffer {constructor (AudioBufferOptions );options readonly attribute float sampleRate ;readonly attribute unsigned long length ;readonly attribute double duration ;readonly attribute unsigned long numberOfChannels ;Float32Array getChannelData (unsigned long );channel undefined copyFromChannel (Float32Array ,destination unsigned long ,channelNumber optional unsigned long = 0);bufferOffset undefined copyToChannel (Float32Array ,source unsigned long ,channelNumber optional unsigned long = 0); };bufferOffset
1.4.1. 构造函数
AudioBuffer(options)-
-
如果
options中的任何值超出其标称范围,则抛出一个NotSupportedError异常并中止后续步骤。 -
令 b 为一个新的
AudioBuffer对象。 -
分别将构造函数中传入的
AudioBufferOptions的numberOfChannels、length、sampleRate属性的值赋给内部槽[[number of channels]]、[[length]]、[[sample rate]]。 -
将此
AudioBuffer的内部槽[[internal data]]设置为调用CreateByteDataBlock(的结果。[[length]]*[[number of channels]])注: 这会将底层存储 初始化为零。
-
返回 b。
AudioBuffer.constructor() 方法的参数。 参数 类型 可为空 可选 说明 optionsAudioBufferOptions✘ ✘ 一个用于确定此 AudioBuffer属性的AudioBufferOptions。 -
1.4.2. 属性
duration, 类型为 double,只读-
PCM 音频数据的持续时间,以秒为单位。
该值通过将
AudioBuffer的[[length]]除以[[sample rate]]计算得到。 length, 类型为 unsigned long,只读-
PCM 音频数据的长度,以采样帧为单位。此属性必须返回
[[length]]的值。 numberOfChannels, 类型为 unsigned long,只读-
离散音频声道的数量。此属性必须返回
[[number of channels]]的值。 sampleRate, 类型为 float,只读-
PCM 音频数据的采样率,以每秒采样数表示。 此属性必须返回
[[sample rate]]的值。
1.4.3. 方法
copyFromChannel(destination, channelNumber, bufferOffset)-
copyFromChannel()方法将AudioBuffer指定声道中的采样复制到destination数组。令
buffer为具有 \(N_b\) 个帧的AudioBuffer, 令 \(N_f\) 为destination数组中的元素数量,并令 \(k\) 为bufferOffset的值。 则从buffer复制到destination的帧数为 \(\max(0, \min(N_b - k, N_f))\)。如果该值小于 \(N_f\),则destination中剩余的元素不会 被修改。AudioBuffer.copyFromChannel() 方法的参数。 参数 类型 可为空 可选 说明 destinationFloat32Array✘ ✘ 声道数据将被复制到的数组。 channelNumberunsigned long✘ ✘ 要从中复制数据的声道索引。如果 channelNumber大于 或等于AudioBuffer的声道数量, 则必须抛出IndexSizeError。bufferOffsetunsigned long✘ ✔ 可选偏移量,默认为 0。从 AudioBuffer中此偏移量开始的数据会被复制到destination。返回类型:undefined copyToChannel(source, channelNumber, bufferOffset)-
copyToChannel()方法将source数组中的采样复制到AudioBuffer的指定声道。如果
source无法复制到缓冲区,则可能抛出UnknownError。令
buffer为具有 \(N_b\) 个帧的AudioBuffer, 令 \(N_f\) 为source数组中的元素数量,并令 \(k\) 为bufferOffset的值。 则从source复制到buffer的帧数为 \(\max(0, \min(N_b - k, N_f))\)。如果该值小于 \(N_f\),则buffer中剩余的元素不会 被修改。AudioBuffer.copyToChannel() 方法的参数。 参数 类型 可为空 可选 说明 sourceFloat32Array✘ ✘ 将从中复制声道数据的数组。 channelNumberunsigned long✘ ✘ 要将数据复制到的声道索引。如果 channelNumber大于 或等于AudioBuffer的声道数量, 则必须抛出IndexSizeError。bufferOffsetunsigned long✘ ✔ 可选偏移量,默认为 0。 source中的数据会从此偏移量开始复制到AudioBuffer中。返回类型:undefined getChannelData(channel)-
根据获取内容中描述的规则, 允许写入
[[internal data]]中存储的字节,或者在一个新的Float32Array中获取其副本。如果无法创建
[[internal data]]或新的Float32Array, 则可能抛出UnknownError。AudioBuffer.getChannelData() 方法的参数。 参数 类型 可为空 可选 说明 channelunsigned long✘ ✘ 此参数是表示要获取数据的特定声道的索引。索引 值 0 表示第一个声道。此索引值必须 小于 [[number of channels]], 否则必须抛出IndexSizeError异常。返回类型:Float32Array
注: 方法 copyToChannel()
和
copyFromChannel()
可以通过传入一个作为更大数组视图的
Float32Array
来填充数组的一部分。从 AudioBuffer
的声道读取数据时,如果
数据可以分块处理,则应优先使用 copyFromChannel(),
而不是调用 getChannelData()
并访问结果数组,因为这样可能避免不必要的
内存分配和复制。
当某些 API
实现需要 AudioBuffer
的内容时,会调用内部操作获取
AudioBuffer 的内容。此操作会向调用者返回不可变的声道数据。
AudioBuffer
上执行获取内容
操作时,运行以下步骤:
-
如果
AudioBuffer的任何ArrayBuffer已分离,则返回true,中止这些 步骤,并 向调用者返回一个长度为零的声道数据缓冲区。 -
分离此前由此
AudioBuffer上的getChannelData()返回的数组对应的所有ArrayBuffer。注: 由于
AudioBuffer只能通过createBuffer()或AudioBuffer构造函数创建,因此这里 不会抛出异常。 -
保留这些
ArrayBuffer中底层的[[internal data]], 并将它们的引用返回给 调用者。 -
将包含数据副本的
ArrayBuffer附加到AudioBuffer, 以便在下一次调用getChannelData()时返回。
获取 AudioBuffer 内容操作会在以下情况下调用:
-
调用
AudioBufferSourceNode.start时,它会 获取该节点的buffer的内容。 如果操作失败,则不会播放任何内容。 -
当
buffer为AudioBufferSourceNode设置后,并且此前已经调用过AudioBufferSourceNode.start, setter 会获取 内容AudioBuffer。 如果该操作失败, 则不会播放任何内容。 -
当
ConvolverNode的buffer被设置为AudioBuffer时,它会获取AudioBuffer的内容。 -
当
AudioProcessingEvent的派发完成时,它会 获取其outputBuffer的内容。
注: 这意味着 copyToChannel()
不能用于更改
当前正由
已获取 AudioBuffer
内容的
AudioNode
所使用的 AudioBuffer
的内容,因为该 AudioNode
将继续使用此前
获取的数据。
1.4.4.
AudioBufferOptions
这指定了构造
AudioBuffer
时使用的选项。
length
和 sampleRate
成员是
必需的。
dictionary AudioBufferOptions {unsigned long numberOfChannels = 1;required unsigned long length ;required float sampleRate ; };
1.4.4.1.
字典 AudioBufferOptions
成员
此字典成员允许的值受到约束。请参阅 createBuffer()。
length, 类型为 unsigned long-
缓冲区的长度,以采样帧为单位。有关约束,请参阅
length。 numberOfChannels, 类型为 unsigned long,默认值为1-
缓冲区的声道数量。有关约束,请参阅
numberOfChannels。 sampleRate, 类型为 float-
缓冲区的采样率,以 Hz 为单位。有关所需支持的范围,请参阅§ 2.4 支持的采样率。
1.5.
AudioNode
接口
AudioNode
是 AudioContext
的构建块。
此接口
表示音频源、音频目标和中间
处理模块。这些模块可以连接在一起,形成
用于将音频渲染到音频硬件的处理图。
每个节点都可以具有输入和/或
输出。源节点没有输入,只有一个
输出。大多数处理节点(例如滤波器)将有一个输入和
一个输出。每种 AudioNode
在处理或合成音频的具体方式上有所不同。但通常,
AudioNode
会处理其输入(如果有),
并为其输出生成音频(如果有)。
每个输出都有一个或多个声道。确切的声道数量
取决于具体 AudioNode
的细节。
一个输出可以连接到一个或多个 AudioNode
输入,因此支持扇出。一个输入最初没有
连接,但可以连接来自一个或多个 AudioNode
的输出,因此支持扇入。当调用
connect() 方法将一个
AudioNode
的输出连接到另一个 AudioNode
的输入时,我们将其称为到该输入的一个
连接。
每个 AudioNode
的 输入在任何给定时刻都有特定数量的
声道。该数量可以根据连接到该输入的
连接发生变化。如果
输入没有连接,则它有一个静音声道。
对于每个输入,AudioNode
会对连接到该输入的所有连接执行
混音。
有关规范性要求和详细信息,请参阅§ 4 声道升混和降混。
AudioNode
的输入处理和内部操作会相对于
AudioContext
时间连续进行,无论该节点是否有
已连接的输出,也无论这些输出最终是否
到达 AudioContext
的
AudioDestinationNode。
[Exposed =Window ]interface AudioNode :EventTarget {AudioNode connect (AudioNode destinationNode ,optional unsigned long output = 0,optional unsigned long input = 0);undefined connect (AudioParam destinationParam ,optional unsigned long output = 0);undefined disconnect ();undefined disconnect (unsigned long output );undefined disconnect (AudioNode destinationNode );undefined disconnect (AudioNode destinationNode ,unsigned long output );undefined disconnect (AudioNode destinationNode ,unsigned long output ,unsigned long input );undefined disconnect (AudioParam destinationParam );undefined disconnect (AudioParam destinationParam ,unsigned long output );readonly attribute BaseAudioContext context ;readonly attribute unsigned long numberOfInputs ;readonly attribute unsigned long numberOfOutputs ;attribute unsigned long channelCount ;attribute ChannelCountMode channelCountMode ;attribute ChannelInterpretation channelInterpretation ; };
1.5.1. AudioNode 创建
AudioNode
可以通过两种方式创建:使用此特定接口的
构造函数,或者使用
BaseAudioContext
或
AudioContext
上的工厂方法。
作为
AudioNode
构造函数第一个参数传入的 BaseAudioContext
被称为要创建的
AudioNode
的关联 BaseAudioContext。
类似地,使用工厂
方法时,AudioNode
的关联
BaseAudioContext就是调用该工厂方法的 BaseAudioContext。
AudioNode
的对象 o,意味着给定传递给此接口构造函数的
参数 context 和 dict,执行以下
步骤。
-
将 o 的关联
BaseAudioContext设置为 context。 -
将其
numberOfInputs、numberOfOutputs、channelCount、channelCountMode、channelInterpretation的值设置为 每个AudioNode对应章节中为此 特定接口列出的默认值。 -
对于传入的 dict 的每个成员,执行以下步骤,其中 k 为成员的键,v 为其值。如果执行这些步骤时 抛出任何异常,则中止迭代并 将该异常传播给算法(构造函数或 工厂方法)的调用者。
-
如果 k 是此 接口上某个
AudioParam的名称,则将此AudioParam的value属性设置为 v。 -
否则,如果 k 是此 接口上某个属性的名称,则将与此属性关联的对象设置为 v。
-
工厂方法的关联 接口是该方法返回的对象所使用的 接口。接口的关联选项 对象是可以传递给该接口构造函数的选项 对象。
AudioNode
是 EventTarget,
如 [DOM] 中所述。
这意味着可以像其他 EventTarget
接收事件一样,将事件派发到
AudioNode。
enum {ChannelCountMode "max" ,"clamped-max" ,"explicit" };
ChannelCountMode
与节点的
channelCount
和 channelInterpretation
值结合使用,以确定
控制如何对节点输入进行混音的 computedNumberOfChannels。computedNumberOfChannels
按如下方式确定。有关如何执行
混音的更多信息,请参阅§ 4 声道升混和
降混。
| 枚举值 | 说明 |
|---|---|
"max"
|
computedNumberOfChannels 是
连接到某个输入的所有连接的声道数
中的最大值。在此模式下,
channelCount
会被忽略。
|
"clamped-max"
|
computedNumberOfChannels 按
"max"
的方式确定,然后钳制为不超过给定
channelCount
的最大值。
|
"explicit"
|
computedNumberOfChannels 与
channelCount
所指定的值完全相同。
|
enum {ChannelInterpretation "speakers" ,"discrete" };
| 枚举值 | 说明 |
|---|---|
"speakers"
|
使用升混方程或降混方程。
当声道数量与这些基本扬声器布局均不匹配时,回退到
"discrete"。
|
"discrete"
| 升混时依次填充声道,直到用尽,然后将 剩余声道置零。降混时尽可能填充多个声道, 然后丢弃剩余声道。 |
1.5.2. AudioNode 尾部时间
一个 AudioNode
可以具有尾部时间。这
意味着即使向
AudioNode
输入静音,其输出也可能不是静音。
如果 AudioNode
具有内部处理状态,使得过去的输入会影响未来的输出,
则它具有非零尾部时间。即使
输入从非静音变为静音之后,AudioNode
也可能在计算出的尾部时间内继续产生非静音输出。
1.5.3. AudioNode 生命周期
如果满足以下任一条件,AudioNode
在一个渲染量子期间可以
主动
处理。
-
AudioScheduledSourceNode当且仅当它在当前渲染量子的至少一部分时间中 播放时,才会主动 处理。 -
MediaElementAudioSourceNode当且仅当其mediaElement在当前渲染量子的至少一部分时间中播放时,才会主动 处理。 -
当关联的
MediaStreamTrack对象的readyState属性等于"live"、muted属性等于false,且enabled属性等于true时,MediaStreamAudioSourceNode或MediaStreamTrackAudioSourceNode会主动 处理。 -
循环中的
DelayNode仅当当前渲染量子中任意输出采样的绝对值 大于或等于 \( 2^{-126} \) 时才会主动处理。 -
当其输入或输出已连接时,
ScriptProcessorNode会主动 处理。 -
当
AudioWorkletProcessor的[[callable process]]返回true, 并且其活动 源标志为true,或连接到其某个输入的任意AudioNode正在主动处理时,AudioWorkletNode会主动 处理。 -
所有其他
AudioNode会在连接到其某个输入的任意AudioNode开始主动 处理时开始主动处理, 并在从其他主动 处理的AudioNode接收到的输入不再影响输出时停止主动 处理。
未主动
处理的 AudioNode
输出一个单声道的
静音。
1.5.4. 属性
channelCount, 类型为 unsigned long-
channelCount是对节点任意输入的连接执行 升混和降混时使用的声道数量。默认值为 2,但某些 特定节点的值会以特殊方式确定。对于没有输入的节点, 此属性不起作用。如果此 值被设置为零或大于实现支持的最大声道数量, 实现必须抛出NotSupportedError异常。此外,一些节点对可能的声道数量值还有额外的 channelCount 约束:
AudioDestinationNode-
行为取决于目标节点是
AudioContext还是OfflineAudioContext的目标:AudioContext-
声道数量必须介于 1 和
maxChannelCount之间。任何将数量设置到此范围之外的尝试 都必须抛出IndexSizeError异常。 OfflineAudioContext-
声道数量不能更改。任何更改该值的尝试 都必须抛出
InvalidStateError异常。
AudioWorkletNode-
请参阅§ 1.32.4.3.2 使用 AudioWorkletNodeOptions 配置声道 使用
AudioWorkletNodeOptions配置声道。 ChannelMergerNode-
声道数量不能更改,任何更改该值的尝试 都必须抛出
InvalidStateError异常。 ChannelSplitterNode-
声道数量不能更改,任何更改该值的尝试 都必须抛出
InvalidStateError异常。 ConvolverNode-
声道数量不能大于二,任何将其更改为 大于二的值的尝试 都必须抛出
NotSupportedError异常。 DynamicsCompressorNode-
声道数量不能大于二,任何将其更改为 大于二的值的尝试 都必须抛出
NotSupportedError异常。 PannerNode-
声道数量不能大于二,任何将其更改为 大于二的值的尝试 都必须抛出
NotSupportedError异常。 ScriptProcessorNode-
声道数量不能更改,任何更改该值的尝试 都必须抛出
NotSupportedError异常。 StereoPannerNode-
声道数量不能大于二,任何将其更改为 大于二的值的尝试 都必须抛出
NotSupportedError异常。
有关此属性的更多信息,请参阅§ 4 声道升混和降混。
channelCountMode, 类型为 ChannelCountMode-
channelCountMode确定在对节点任意输入的连接进行升混和降混时 如何计算声道数量。默认值为 "max"。 对于没有输入的节点,此属性不起作用。此外,一些节点对声道数量模式的可能值还有额外的 channelCountMode 约束:
AudioDestinationNode-
如果
AudioDestinationNode是OfflineAudioContext的destination节点, 则声道数量模式 不能更改。任何更改该值的尝试 都必须抛出InvalidStateError异常。 ChannelMergerNode-
声道数量模式不能从 "
explicit" 更改, 任何更改该值的尝试 都必须抛出InvalidStateError异常。 ChannelSplitterNode-
声道数量模式不能从 "
explicit" 更改, 任何更改该值的尝试 都必须抛出InvalidStateError异常。 ConvolverNode-
声道数量模式不能设置为 "
max", 任何将其设置为 "max" 的尝试都必须抛出NotSupportedError异常。 DynamicsCompressorNode-
声道数量模式不能设置为 "
max", 任何将其设置为 "max" 的尝试都必须抛出NotSupportedError异常。 PannerNode-
声道数量模式不能设置为 "
max", 任何将其设置为 "max" 的尝试都必须抛出NotSupportedError异常。 ScriptProcessorNode-
声道数量模式不能从 "
explicit" 更改, 任何更改该值的尝试 都必须抛出NotSupportedError异常。 StereoPannerNode-
声道数量模式不能设置为 "
max", 任何将其设置为 "max" 的尝试都必须抛出NotSupportedError异常。
有关此属性的更多信息,请参阅§ 4 声道升混和降混一节。
channelInterpretation, 类型为 ChannelInterpretation-
channelInterpretation决定在对节点任意输入的连接进行升混和降混时 如何处理各个声道。默认值为 "speakers"。 对于没有输入的节点, 此属性不起作用。此外,一些节点对声道解释的可能值还有额外的 channelInterpretation 约束:
ChannelSplitterNode-
声道解释不能从 "
discrete" 更改, 任何更改该值的尝试 都必须抛出InvalidStateError异常。
有关此属性的更多信息,请参阅§ 4 声道升混和降混。
context, 类型为 BaseAudioContext,只读-
拥有此
AudioNode的BaseAudioContext。 numberOfInputs, 类型为 unsigned long,只读-
馈入
AudioNode的输入数量。对于 源节点,该值为 0。对于许多AudioNode类型,此属性是预先确定的,但某些AudioNode, 例如ChannelMergerNode和AudioWorkletNode, 具有可变数量的输入。 numberOfOutputs, 类型为 unsigned long,只读-
AudioNode的输出数量。对于某些AudioNode类型,此属性是预先确定的,但 也可以是可变的,例如ChannelSplitterNode和AudioWorkletNode。
1.5.5. 方法
connect(destinationNode, output, input)-
一个特定节点的给定输出与另一个特定节点的 给定输入之间只能存在一个连接。 具有相同端点的多个连接会被忽略。
此方法返回
destinationAudioNode对象。AudioNode.connect(destinationNode, output, input) 方法的参数。 参数 类型 可为空 可选 说明 destinationNodedestination参数是要连接到的AudioNode。 如果destination参数是一个 使用另一个AudioContext创建的AudioNode, 则必须抛出InvalidAccessError异常。也就是说,AudioNode不能在不同的AudioContext之间共享。 多个AudioNode可以连接到同一个AudioNode, 这在声道升混和 降混一节中进行了说明。outputunsigned long✘ ✔ output参数是一个索引,用于描述从AudioNode的哪个输出进行连接。如果此参数越界,则必须抛出IndexSizeError异常。可以通过多次调用 connect() 将一个AudioNode输出连接到多个输入。因此支持“扇出”。inputinput参数是一个索引,用于描述要连接到目标AudioNode的哪个输入。如果此参数越界,则必须抛出IndexSizeError异常。可以将一个AudioNode连接到另一个AudioNode, 从而形成一个循环:一个AudioNode可以连接到另一个AudioNode, 后者又连接回第一个AudioNode的输入或AudioParam。返回类型:AudioNode connect(destinationParam, output)-
将
AudioNode连接到AudioParam, 使用 a-rate 信号 控制参数值。可以通过 多次调用 connect(),将一个
AudioNode输出连接到多个AudioParam。 因此支持“扇出”。可以通过多次调用 connect(),将多个
AudioNode输出连接到单个AudioParam。 因此支持“扇入”。AudioParam会获取连接到它的任意AudioNode输出的已渲染音频 数据,如果它尚不是单声道,则通过 降混将其转换为单声道,然后将其与 其他此类输出混合,最后再与 内在参数值(即在没有任何 音频连接时AudioParam通常具有的value)混合,其中包括为该参数 计划的任何时间线变化。降混为单声道等价于一个
AudioNode使用channelCount= 1、channelCountMode= "explicit", 且channelInterpretation= "speakers" 时的降混。一个特定节点的给定输出与特定
AudioParam之间只能存在一个连接。 具有相同端点的多个连接会被忽略。AudioNode.connect(destinationParam, output) 方法的参数。 参数 类型 可为空 可选 说明 destinationParamAudioParam✘ ✘ destination参数是要连接到的AudioParam。 此方法不会返回destinationAudioParam对象。如果destinationParam属于一个AudioNode, 而该节点所属于的BaseAudioContext与创建调用此方法的AudioNode的BaseAudioContext不同,则必须抛出InvalidAccessError。outputunsigned long✘ ✔ output参数是一个索引,用于描述从AudioNode的哪个输出进行连接。如果parameter越界,则必须抛出IndexSizeError异常。返回类型:undefined disconnect()-
断开
AudioNode的所有传出连接。无参数。返回类型:undefined disconnect(output)-
将
AudioNode的单个输出与它所连接的任何其他AudioNode或AudioParam对象断开。AudioNode.disconnect(output) 方法的参数。 参数 类型 可为空 可选 说明 outputunsigned long✘ ✘ 此参数是一个索引,用于描述要断开 AudioNode的哪个输出。它会断开给定输出的所有传出连接。如果此参数越界,则必须抛出IndexSizeError异常。返回类型:undefined disconnect(destinationNode)-
断开
AudioNode中通往特定目标AudioNode的所有输出。AudioNode.disconnect(destinationNode) 方法的参数。 参数 类型 可为空 可选 说明 destinationNodedestinationNode参数是要断开的AudioNode。 它会断开通往给定destinationNode的所有传出连接。如果不存在通往destinationNode的连接,则必须抛出InvalidAccessError异常。返回类型:undefined disconnect(destinationNode, output)-
将
AudioNode的特定输出与某个目标AudioNode的任意及所有输入断开。AudioNode.disconnect(destinationNode, output) 方法的参数。 参数 类型 可为空 可选 说明 destinationNodedestinationNode参数是要断开的AudioNode。 如果给定输出不存在通往destinationNode的连接,则必须抛出InvalidAccessError异常。outputunsigned long✘ ✘ output参数是一个索引,用于描述从AudioNode的哪个输出断开。如果此参数越界, 则必须抛出IndexSizeError异常。返回类型:undefined disconnect(destinationNode, output, input)-
将
AudioNode的特定输出与某个目标AudioNode的特定输入断开。AudioNode.disconnect(destinationNode, output, input) 方法的参数。 参数 类型 可为空 可选 说明 destinationNodedestinationNode参数是要断开的AudioNode。 如果给定输出到给定输入之间不存在通往destinationNode的连接,则必须抛出InvalidAccessError异常。outputunsigned long✘ ✘ output参数是一个索引,用于描述从AudioNode的哪个输出断开。如果此参数越界, 则必须抛出IndexSizeError异常。inputinput参数是一个索引,用于描述要断开目标AudioNode的哪个输入。如果此参数越界,则必须抛出IndexSizeError异常。返回类型:undefined disconnect(destinationParam)-
断开
AudioNode中通往特定目标AudioParam的所有输出。 当此操作生效时,此AudioNode对计算参数值的贡献 变为 0。此操作不会影响内在 参数值。AudioNode.disconnect(destinationParam) 方法的参数。 参数 类型 可为空 可选 说明 destinationParamAudioParam✘ ✘ destinationParam参数是要断开的AudioParam。 如果不存在通往destinationParam的连接,则必须抛出InvalidAccessError异常。返回类型:undefined disconnect(destinationParam, output)-
将
AudioNode的特定输出与特定目标AudioParam断开。 当此操作生效时,此AudioNode对计算参数值的贡献 变为 0。此操作不会影响内在 参数值。AudioNode.disconnect(destinationParam, output) 方法的参数。 参数 类型 可为空 可选 说明 destinationParamAudioParam✘ ✘ destinationParam参数是要断开的AudioParam。 如果不存在通往destinationParam的连接,则必须抛出InvalidAccessError异常。outputunsigned long✘ ✘ output参数是一个索引,用于描述从AudioNode的哪个输出断开。如果parameter越界,则必须抛出IndexSizeError异常。返回类型:undefined
1.5.6.
AudioNodeOptions
这指定了可用于构造所有
AudioNode
的选项。
所有成员都是可选的。不过,每个节点所使用的具体
值取决于实际的节点。
dictionary AudioNodeOptions {unsigned long channelCount ;ChannelCountMode channelCountMode ;ChannelInterpretation channelInterpretation ; };
1.5.6.1.
字典 AudioNodeOptions
成员
channelCount, 类型为 unsigned long-
channelCount属性所需的声道数量。 channelCountMode, 类型为 ChannelCountMode-
channelCountMode属性所需的模式。 channelInterpretation, 类型为 ChannelInterpretation-
channelInterpretation属性所需的模式。
1.6.
AudioParam
接口
AudioParam
控制
AudioNode
功能的某个独立方面,例如音量。可以使用
value 属性立即将参数设置为特定值。或者,可以计划
在非常精确的时间(位于
AudioContext
的
currentTime
属性的坐标系中)发生值的变化,用于包络、音量
淡入淡出、LFO、滤波器扫描、粒度窗口等。通过这种方式,
可以在任意
AudioParam
上设置任意基于时间线的自动化曲线。
此外,来自
AudioNode
输出的音频信号可以连接到
AudioParam,
并与内在参数值相加。
某些合成和处理 AudioNode
具有
AudioParam
属性,其值必须逐个音频采样纳入
考虑。对于其他
AudioParam,
采样级精度并不重要,值的变化可以以更粗的粒度采样。每个
AudioParam
都会指定它是
a-rate 参数,即其值必须
逐个音频采样纳入考虑;或者它是一个 k-rate
参数。
实现必须使用分块处理,其中每个
AudioNode
处理一个渲染
量子。
对于每个渲染量子,
k-rate 参数的值
必须在第一个采样帧的时刻进行采样,并且该值必须用于整个
块。a-rate 参数必须
针对块中的每个采样帧进行采样。
根据不同的 AudioParam,
可以通过将
automationRate
属性设置为
"a-rate"
或 "k-rate"
来控制其速率。
有关更多详细信息,请参阅各个 AudioParam
的说明。
每个 AudioParam
都包含 minValue
和 maxValue
属性,它们共同构成该参数的
简单标称
范围。实际上,
参数值会被钳制到范围 \([\mathrm{minValue},
\mathrm{maxValue}]\)。有关完整详细信息,请参阅§ 1.6.3 值的计算。
对于许多 AudioParam,
minValue
和 maxValue
应设置为最大可能范围。在这种情况下,maxValue
应设置为
最大正单精度浮点值,即
3.4028235e38。
(不过,在仅支持 IEEE-754 双精度
浮点值的 JavaScript 中,它必须写为 3.4028234663852886e38。)
类似地,minValue
应设置
为最小负单精度浮点值,即
最大正单精度浮点值的负值:-3.4028235e38。
(类似地,在 JavaScript 中必须写为
-3.4028234663852886e38。)
一个 AudioParam
维护一个包含零个或多个自动化事件的列表。每个自动化事件
指定参数值在特定时间范围内的变化,这些变化相对于其在
AudioContext
的 currentTime
属性的时间坐标系中的自动化事件时间。
自动化事件列表按
自动化事件时间升序维护。
给定自动化事件的行为取决于
AudioContext
的当前时间,以及此事件和列表中相邻事件的自动化事件
时间。以下
自动化方法通过向事件列表添加
一个特定于该方法类型的新事件来更改
事件列表:
-
setValueAtTime()-SetValue -
linearRampToValueAtTime()-LinearRampToValue -
exponentialRampToValueAtTime()-ExponentialRampToValue -
setTargetAtTime()-SetTarget -
setValueCurveAtTime()-SetValueCurve
调用这些方法时适用以下规则:
-
自动化 事件时间不会根据当前采样率进行量化。用于确定曲线和渐变的公式 会应用于计划事件时给出的精确数值 时间。
-
如果在已经存在一个或多个事件的时间点添加其中一个事件, 那么它会被放在这些事件之后, 但位于时间晚于该事件的事件之前。
-
如果针对时间 \(T\) 和持续时间 \(D\) 调用setValueCurveAtTime(), 并且存在时间严格大于 \(T\) 但严格小于 \(T + D\) 的任何事件,则必须抛出
NotSupportedError异常。换句话说,不能在包含其他事件的时间段内 安排值曲线,但可以恰好在另一个事件的时间点安排值 曲线。 -
类似地,如果在 \([T, T+D)\) 所包含的时间点调用任何 自动化方法, 其中 \(T\) 是曲线的时间, \(D\) 是其持续时间,则必须抛出
NotSupportedError异常。
注: 除
value
属性外,AudioParam
属性均为只读。
可以通过将
automationRate
属性设置为以下值之一来选择
AudioParam
的自动化速率。不过,某些 AudioParam
对自动化速率是否可以更改
存在约束。
enum {AutomationRate "a-rate" ,"k-rate" };
| 枚举值 | 说明 |
|---|---|
"a-rate"
|
此 AudioParam
设置为进行 a-rate
处理。
|
"k-rate"
|
此 AudioParam
设置为进行 k-rate
处理。
|
每个 AudioParam
都具有一个内部槽 [[current value]],
初始设置为该 AudioParam
的
defaultValue。
[Exposed =Window ]interface AudioParam {attribute float value ;attribute AutomationRate automationRate ;readonly attribute float defaultValue ;readonly attribute float minValue ;readonly attribute float maxValue ;AudioParam setValueAtTime (float ,value double );startTime AudioParam linearRampToValueAtTime (float ,value double );endTime AudioParam exponentialRampToValueAtTime (float ,value double );endTime AudioParam setTargetAtTime (float ,target double ,startTime float );timeConstant AudioParam setValueCurveAtTime (sequence <float >,values double ,startTime double );duration AudioParam cancelScheduledValues (double );cancelTime AudioParam cancelAndHoldAtTime (double ); };cancelTime
1.6.1. 属性
automationRate, 类型为 AutomationRate-
AudioParam的自动化速率。 默认值取决于实际的AudioParam; 有关默认值,请参阅每个独立AudioParam的说明。某些节点具有如下额外的自动化速率约束:
AudioBufferSourceNode-
AudioParamplaybackRate和detune必须为 "k-rate"。 如果将速率更改为 "a-rate", 则必须抛出InvalidStateError。 DynamicsCompressorNode-
AudioParamthreshold、knee、ratio、attack和release必须为 "k-rate"。 如果将速率更改为 "a-rate", 则必须抛出InvalidStateError。 PannerNode-
如果
panningModel为 "HRTF", 则会忽略PannerNode的任何AudioParam的automationRate设置。 同样,也会忽略AudioListener的任何AudioParam的automationRate设置。在这种 情况下,AudioParam的行为就像其automationRate被设置为 "k-rate"。
defaultValue, 类型为 float,只读-
value属性的初始值。 maxValue, 类型为 float,只读-
参数可以取的标称最大值。它与
minValue一起构成此参数的标称范围。 minValue, 类型为 float,只读-
参数可以取的标称最小值。它与
maxValue一起构成此参数的标称范围。 value, 类型为 float-
参数的浮点值。此属性 初始化为
defaultValue。获取此属性时返回
[[current value]]槽的内容。有关返回值的算法,请参阅 § 1.6.3 值的计算。设置此属性的效果是将 请求的值赋给
[[current value]]槽,并使用当前AudioContext的currentTime和[[current value]]调用setValueAtTime() 方法。 设置此属性时也会抛出setValueAtTime()本来会抛出的任何 异常。
1.6.2. 方法
cancelAndHoldAtTime(cancelTime)-
这与
cancelScheduledValues()类似,因为它会取消所有时间大于或等于cancelTime的已计划参数变化。 不过,除此之外,本应在cancelTime发生的自动化 值随后会传播到所有未来时间,直到引入其他自动化 事件。当自动化正在运行, 并且在调用
cancelAndHoldAtTime()之后且到达cancelTime之前的任意时刻还可以引入自动化时, 时间线面对cancelAndHoldAtTime()的行为相当复杂。因此,cancelAndHoldAtTime()的行为在以下算法中 规定。令 \(t_c\) 为cancelTime的值。然后-
令 \(E_1\) 为时间 \(t_1\) 处的事件(如果有),其中 \(t_1\) 是满足 \(t_1 \le t_c\) 的最大数。
-
令 \(E_2\) 为时间 \(t_2\) 处的事件(如果有),其中 \(t_2\) 是满足 \(t_c \lt t_2\) 的最小数。
-
如果 \(E_2\) 存在:
-
如果 \(E_2\) 是线性或指数渐变,
-
实际上将 \(E_2\) 重写为相同类型的 渐变,使其在时间 \(t_c\) 结束,并将结束值设为 原始渐变在时间 \(t_c\) 时应具有的值。

-
转到步骤 5。
-
-
否则,转到步骤 4。
-
-
如果 \(E_1\) 存在:
-
如果 \(E_1\) 是一个
setTarget事件,-
在时间 \(t_c\) 隐式插入一个
setValueAtTime事件,其值为setTarget在时间 \(t_c\) 时应具有的值。
-
转到步骤 5。
-
-
如果 \(E_1\) 是一个起始时间为 \(t_3\)、 持续时间为 \(d\) 的
setValueCurve-
如果 \(t_c \gt t_3 + d\),转到步骤 5。
-
否则,
-
实际上将此事件替换为一个起始时间 为 \(t_3\)、新持续时间为 \(t_c-t_3\) 的
setValueCurve事件。 不过,这并不是真正的替换;此 自动化必须确保产生与原始事件相同的 输出,而不能使用不同持续时间 重新计算。(否则会以略有不同的方式 对值曲线进行采样, 从而产生不同结果。)
-
转到步骤 5。
-
-
-
-
移除所有时间大于 \(t_c\) 的事件。
如果没有添加任何事件,那么
cancelAndHoldAtTime()之后的自动化值就是 原始时间线在时间 \(t_c\) 时应具有的常量值。AudioParam.cancelAndHoldAtTime() 方法的参数。 参数 类型 可为空 可选 说明 cancelTimedouble✘ ✘ 在此时间之后,任何先前计划的参数变化都会被取消。它 使用与 AudioContext的currentTime属性相同的时间坐标系。如果cancelTime为负数, 则必须抛出RangeError异常。如果cancelTime小于currentTime, 则将其钳制为currentTime。返回类型:AudioParam -
cancelScheduledValues(cancelTime)-
取消所有时间大于 或等于
cancelTime的已计划参数变化。 取消已计划的 参数变化意味着从 事件列表中移除已计划事件。任何自动化事件时间小于cancelTime的活动自动化也会被取消,并且此类 取消可能导致不连续,因为原始 值(此类自动化之前的值)会立即恢复。由cancelAndHoldAtTime()计划的任何保持值,如果其保持时间发生在cancelTime之后,也会被移除。对于
setValueCurveAtTime(), 令 \(T_0\) 和 \(T_D\) 分别为此事件对应的startTime和duration。 那么,如果cancelTime位于范围 \([T_0, T_0 + T_D]\) 内,则从时间线中 移除该事件。AudioParam.cancelScheduledValues() 方法的参数。 参数 类型 可为空 可选 说明 cancelTimedouble✘ ✘ 在此时间之后,任何先前计划的参数变化都会被取消。它 使用与 AudioContext的currentTime属性相同的时间坐标系。如果cancelTime为负数, 则必须抛出RangeError异常。如果cancelTime小于currentTime, 则将其钳制为currentTime。返回类型:AudioParam exponentialRampToValueAtTime(value, endTime)-
计划参数值从前一个已计划参数值到给定值的 指数连续变化。 表示滤波器频率和播放速率的参数 最适合按指数方式变化,因为人类 感知声音的方式如此。
在时间区间 \(T_0 \leq t < T_1\) 内的值 (其中 \(T_0\) 是前一个事件的时间,而 \(T_1\) 是 传入此方法的
endTime参数) 按如下方式计算:$$ v(t) = V_0 \left(\frac{V_1}{V_0}\right)^\frac{t - T_0}{T_1 - T_0} $$其中 \(V_0\) 是时间 \(T_0\) 时的值,而 \(V_1\) 是 传入此方法的
value参数。如果 \(V_0\) 和 \(V_1\) 符号相反,或者 \(V_0\) 为零, 则对于 \(T_0 \le t \lt T_1\),\(v(t) = V_0\)。这也意味着无法进行指数渐变到 0。可以使用
setTargetAtTime()并选择适当的时间常数来获得 良好的近似效果。如果此 ExponentialRampToValue 事件之后没有更多事件,则对于 \(t \geq T_1\),\(v(t) = V_1\)。
如果此事件之前没有事件,则指数渐变的 行为就像调用了
setValueAtTime(value, currentTime), 其中value是属性的当前值,而currentTime是调用exponentialRampToValueAtTime()时上下文的currentTime。如果前一个事件是
SetTarget事件,则 \(T_0\) 和 \(V_0\) 从SetTarget自动化的当前时间和值中选取。也就是说,如果SetTarget事件尚未开始,则 \(T_0\) 是该事件的开始 时间,而 \(V_0\) 是SetTarget事件开始前一刻的值。在这种情况下,ExponentialRampToValue事件实际上会替换SetTarget事件。如果SetTarget事件已经 开始,则 \(T_0\) 是当前上下文时间,而 \(V_0\) 是时间 \(T_0\) 时当前的SetTarget自动化值。 在这两种情况下,自动化曲线都是连续的。AudioParam.exponentialRampToValueAtTime() 方法的参数。 参数 类型 可为空 可选 说明 valuefloat✘ ✘ 参数在给定时间将以指数方式渐变到的值。如果此值等于 0,则必须抛出 RangeError异常。endTimedouble✘ ✘ 指数渐变结束的时间,它使用与 AudioContext的currentTime属性相同的时间坐标系。如果endTime为负数或不是有限 数,则必须抛出RangeError异常。如果 endTime 小于currentTime, 则将其钳制为currentTime。返回类型:AudioParam linearRampToValueAtTime(value, endTime)-
计划参数值从 前一个已计划参数值到给定值的线性连续变化。
在时间区间 \(T_0 \leq t < T_1\) 内的值 (其中 \(T_0\) 是前一个事件的时间,而 \(T_1\) 是 传入此方法的
endTime参数) 按如下方式计算:$$ v(t) = V_0 + (V_1 - V_0) \frac{t - T_0}{T_1 - T_0} $$其中 \(V_0\) 是时间 \(T_0\) 时的值,而 \(V_1\) 是 传入此方法的
value参数。如果此 LinearRampToValue 事件之后没有更多事件, 则对于 \(t \geq T_1\),\(v(t) = V_1\)。
如果此事件之前没有事件,则线性渐变的 行为就像调用了
setValueAtTime(value, currentTime), 其中value是属性的当前值,而currentTime是调用linearRampToValueAtTime()时上下文的currentTime。如果前一个事件是
SetTarget事件,则 \(T_0\) 和 \(V_0\) 从SetTarget自动化的当前时间和值中选取。也就是说,如果SetTarget事件尚未开始,则 \(T_0\) 是该事件的开始 时间,而 \(V_0\) 是SetTarget事件开始前一刻的值。在这种情况下,LinearRampToValue事件实际上会替换SetTarget事件。如果SetTarget事件已经 开始,则 \(T_0\) 是当前上下文时间,而 \(V_0\) 是时间 \(T_0\) 时当前的SetTarget自动化值。 在这两种情况下,自动化曲线都是连续的。AudioParam.linearRampToValueAtTime() 方法的参数。 参数 类型 可为空 可选 说明 valuefloat✘ ✘ 参数在给定时间将线性渐变到的值。 endTimedouble✘ ✘ 自动化结束的时间,它使用与 AudioContext的currentTime属性相同的时间坐标系。如果endTime为负数或不是有限 数,则必须抛出RangeError异常。如果 endTime 小于currentTime, 则将其钳制为currentTime。返回类型:AudioParam setTargetAtTime(target, startTime, timeConstant)-
在给定时间,以具有给定时间常数的速率开始按指数方式 接近目标值。除其他用途外,这对于实现 ADSR 包络的 “衰减”和“释放”部分很有用。请注意,参数 值不会在给定时间立即变为目标值, 而是逐渐变为目标值。
在时间区间 \(T_0 \leq t\) 内,其中 \(T_0\) 是
startTime参数:$$ v(t) = V_1 + (V_0 - V_1)\, e^{-\left(\frac{t - T_0}{\tau}\right)} $$其中 \(V_0\) 是 \(T_0\)(
startTime参数)时的初始值([[current value]]属性), \(V_1\) 等于target参数,而 \(\tau\) 是timeConstant参数。如果一个
LinearRampToValue或ExponentialRampToValue事件紧随此事件,则其 行为分别在linearRampToValueAtTime()或exponentialRampToValueAtTime()中描述。对于所有其他事件,SetTarget事件在下一个事件的时间点结束。AudioParam.setTargetAtTime() 方法的参数。 参数 类型 可为空 可选 说明 targetfloat✘ ✘ 参数在给定时间将开始向其变化的值。 startTimedouble✘ ✘ 开始指数接近的时间,它使用与 AudioContext的currentTime属性相同的时间坐标系。如果start为负数或不是有限 数,则必须抛出RangeError异常。如果 startTime 小于currentTime, 则将其钳制为currentTime。timeConstantfloat✘ ✘ 以一阶滤波器(指数)方式接近目标 值的时间常数。该值越大,过渡越慢。该值必须为非负数,否则必须抛出 RangeError异常。如果timeConstant为零,输出 值会立即跳到最终值。更准确地说,timeConstant 是 一阶线性连续时不变系统在给定阶跃输入响应 (从值 0 过渡到值 1)时达到 \(1 - 1/e\)(约 63.2%)所需的时间。返回类型:AudioParam setValueAtTime(value, startTime)-
计划在给定时间更改参数值。
如果此
SetValue事件之后没有更多事件, 则对于 \(t \geq T_0\),\(v(t) = V\),其中 \(T_0\) 是startTime参数,而 \(V\) 是value参数。换句话说,该值将 保持不变。如果此
SetValue事件之后的下一个事件(时间为 \(T_1\)) 不是LinearRampToValue或ExponentialRampToValue类型,则对于 \(T_0 \leq t < T_1\):$$ v(t) = V $$换句话说,在此时间 区间内该值将保持不变,从而可以创建“阶跃”函数。
如果此
SetValue事件之后的下一个事件是LinearRampToValue或ExponentialRampToValue类型,则请分别参阅linearRampToValueAtTime()或exponentialRampToValueAtTime()。AudioParam.setValueAtTime() 方法的参数。 参数 类型 可为空 可选 说明 valuefloat✘ ✘ 参数在给定时间将变为的值。 startTimedouble✘ ✘ 参数变为给定值的时间,它使用与 BaseAudioContext的currentTime属性相同的时间坐标系。如果startTime为负数或不是有限 数,则必须抛出RangeError异常。如果 startTime 小于currentTime, 则将其钳制为currentTime。返回类型:AudioParam setValueCurveAtTime(values, startTime, duration)-
从给定时间开始,在给定持续时间内设置 任意参数值数组。值的数量将被 缩放以适应所需的持续时间。
令 \(T_0\) 为
startTime, \(T_D\) 为duration, \(V\) 为values数组, \(N\) 为values数组的长度。然后, 在时间区间 \(T_0 \le t < T_0 + T_D\) 内,令$$ \begin{align*} k &= \left\lfloor \frac{N - 1}{T_D}(t-T_0) \right\rfloor \\ \end{align*} $$然后通过在 \(V[k]\) 和 \(V[k+1]\) 之间进行线性插值来计算 \(v(t)\)。
曲线时间区间结束后(\(t \ge T_0 + T_D\)), 该值将保持在曲线最终值,直到 出现另一个自动化事件(如果有)。
会在时间 \(T_0 + T_D\) 以值 \(V[N-1]\) 隐式调用
setValueAtTime(), 以便后续自动化从setValueCurveAtTime()事件的末尾开始。AudioParam.setValueCurveAtTime() 方法的参数。 参数 类型 可为空 可选 说明 valuessequence<float>✘ ✘ 表示参数值曲线的一系列 float 值。这些值将从 给定时间开始,并持续给定的持续时间。调用此方法时, 会为自动化目的创建该曲线的内部副本。因此,之后 修改传入数组的内容不会影响 AudioParam。 如果此属性是长度小于 2 的sequence<float>对象,则必须抛出InvalidStateError。startTimedouble✘ ✘ 应用值曲线的开始时间,它使用与 AudioContext的currentTime属性相同的时间坐标系。如果startTime为负数或不是有限 数,则必须抛出RangeError异常。如果 startTime 小于currentTime, 则将其钳制为currentTime。durationdouble✘ ✘ 按照 values参数计算值的时间量,以秒为单位 (在startTime参数之后)。如果duration不是严格正数或不是 有限数,则必须抛出RangeError异常。返回类型:AudioParam
1.6.3. 值的计算
存在两种不同类型的 AudioParam:
简单
参数和复合参数。
简单参数(默认)单独用于
计算 AudioNode
的最终音频输出。
复合
参数是与其他
AudioParam
一起使用的 AudioParam,
用于计算一个值,然后将该值作为输入
用于计算 AudioNode
的输出。
computedValue 是 控制音频 DSP 的最终值,由音频渲染线程在每个 渲染时间量子期间计算。
AudioParam
值的计算由两部分组成:
-
paramComputedValue,即控制 音频 DSP 的最终值,由音频渲染线程在每个 渲染量子期间计算。
这些值必须按如下方式计算:
-
paramIntrinsicValue 会在 每个时间点计算,它要么是直接设置给
value属性的值,要么在存在时间早于或等于此时间点的 自动化 事件时,是根据这些事件计算得到的值。如果从给定时间范围中 移除了自动化事件,则 paramIntrinsicValue 值会保持 不变并维持之前的值,直到直接设置value属性,或者 为该时间范围添加自动化事件。 -
将
[[current value]]设置为此渲染 量子开始时 paramIntrinsicValue 的值。 -
paramComputedValue 是 paramIntrinsicValue 值与输入 AudioParam 缓冲区值之和。如果该和为
NaN,则用defaultValue替换该和。 -
如果此
AudioParam是一个复合参数, 则使用其他AudioParam计算其最终值。 -
将computedValue 设置为 paramComputedValue。
computedValue 的
标称范围是
此参数实际可以具有的较低值和较高值。对于
简单参数,
computedValue 会被钳制到
此参数的简单标称
范围。复合
参数在根据构成它的不同
AudioParam
值计算后,会将其最终值钳制到其标称
范围。
使用自动化方法时,仍然会应用钳制。 不过,自动化本身会像完全不存在钳制一样运行。 只有当自动化值要应用于输出时, 才会按上述规定执行钳制。
N. p. setValueAtTime( 0 , 0 ); N. p. linearRampToValueAtTime( 4 , 1 ); N. p. linearRampToValueAtTime( 0 , 2 );
曲线的初始斜率为 4,直到达到最大 值 1,此时输出保持恒定。最后, 在接近时间 2 时,曲线的斜率为 -4。如下图所示, 其中虚线表示在没有裁剪的情况下会 发生什么,实线表示由于钳制到标称 范围而导致的 audioparam 实际预期行为。
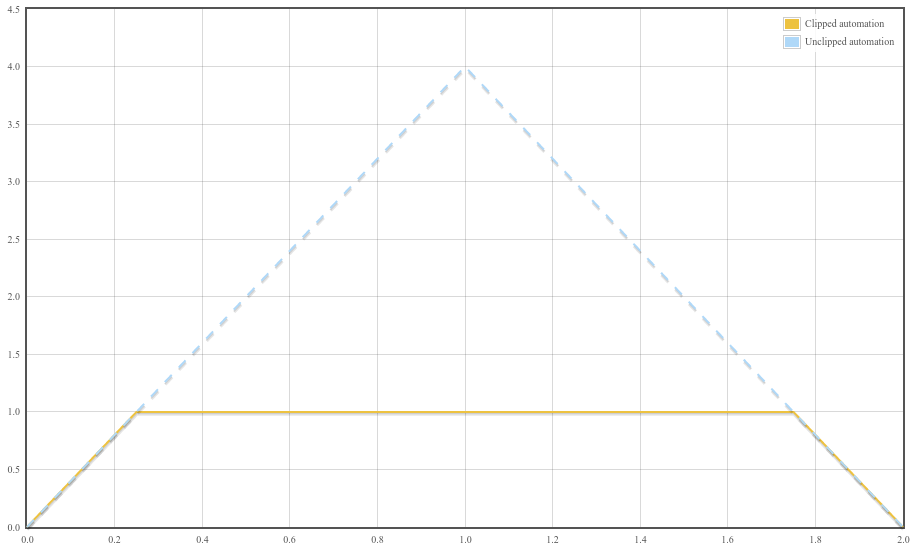
1.6.4.
AudioParam
自动化示例
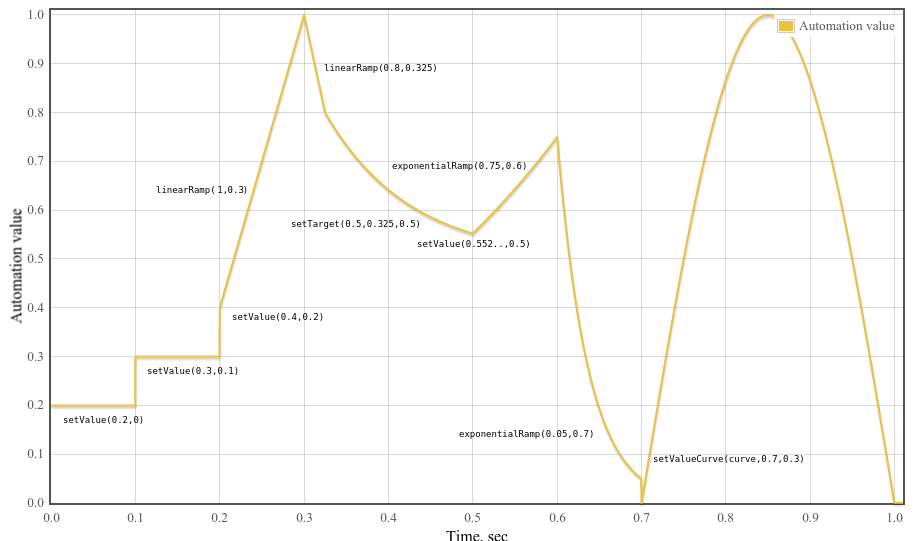
const curveLength= 44100 ; const curve= new Float32Array( curveLength); for ( const i= 0 ; i< curveLength; ++ i) curve[ i] = Math. sin( Math. PI* i/ curveLength); const t0= 0 ; const t1= 0.1 ; const t2= 0.2 ; const t3= 0.3 ; const t4= 0.325 ; const t5= 0.5 ; const t6= 0.6 ; const t7= 0.7 ; const t8= 1.0 ; const timeConstant= 0.1 ; param. setValueAtTime( 0.2 , t0); param. setValueAtTime( 0.3 , t1); param. setValueAtTime( 0.4 , t2); param. linearRampToValueAtTime( 1 , t3); param. linearRampToValueAtTime( 0.8 , t4); param. setTargetAtTime( .5 , t4, timeConstant); // 计算 setTargetAtTime 在时间 t5 时的位置,以便我们可以让 // 后续指数渐变从正确的位置开始,从而不会产生 // 跳跃不连续。根据规范,我们有 // v(t) = 0.5 + (0.8 - 0.5)*exp(-(t-t4)/timeConstant) // 因此 v(t5) = 0.5 + (0.8 - 0.5)*exp(-(t5-t4)/timeConstant) param. setValueAtTime( 0.5 + ( 0.8 - 0.5 ) * Math. exp( - ( t5- t4) / timeConstant), t5); param. exponentialRampToValueAtTime( 0.75 , t6); param. exponentialRampToValueAtTime( 0.05 , t7); param. setValueCurveAtTime( curve, t7, t8- t7);
1.7.
AudioScheduledSourceNode
接口
此接口表示诸如
AudioBufferSourceNode、
ConstantSourceNode
和
OscillatorNode
等源节点的共同特性。
在源启动之前(通过调用 start()),
源节点
必须输出静音(0)。在源停止后(通过调用
stop()),
源随后必须输出静音(0)。
AudioScheduledSourceNode
不能直接实例化,而是由源节点的具体接口进行扩展。
当
AudioScheduledSourceNode
的关联 BaseAudioContext
的
currentTime
大于或等于
AudioScheduledSourceNode
被设置为开始的时间,
且小于它被设置为停止的时间时,称其正在播放。
AudioScheduledSourceNode
创建时带有一个内部布尔
槽 [[source started]],
初始设置为 false。
[Exposed =Window ]interface AudioScheduledSourceNode :AudioNode {attribute EventHandler onended ;undefined start (optional double when = 0);undefined stop (optional double when = 0); };
1.7.1. 属性
onended, 类型为 EventHandler-
用于为派发到
AudioScheduledSourceNode节点类型的ended事件类型设置事件处理程序的属性。 当源节点停止播放时(由具体节点确定),会向 事件处理程序派发一个使用Event接口的事件。对于所有
AudioScheduledSourceNode, 当达到由stop()确定的停止时间时,会派发ended事件。 对于AudioBufferSourceNode, 当达到duration或整个buffer已播放完时,也会派发该事件。
1.7.2. 方法
start(when)-
计划声音在精确时间开始播放。
调用此方法时,执行 以下步骤:-
如果此
AudioScheduledSourceNode的内部 槽[[source started]]为 true,则必须抛出InvalidStateError异常。 -
检查由于下面描述的参数 约束而必须抛出的任何错误。如果在此 步骤期间抛出任何异常,则中止这些步骤。
-
将此
AudioScheduledSourceNode上的内部槽[[source started]]设置为true。 -
将控制消息排队 以启动
AudioScheduledSourceNode, 并在消息中包含参数 值。 -
仅当满足以下 所有条件时,才向关联的
AudioContext发送一条控制消息,以 开始运行其渲染线程:-
上下文的
[[control thread state]]为 "suspended"。 -
上下文允许启动。
-
[[suspended by user]]标志为false。
注: 这可以允许
start()启动一个当前允许启动、 但此前曾被阻止启动的AudioContext。 -
AudioScheduledSourceNode.start(when) 方法的参数。 参数 类型 可为空 可选 说明 whendouble✘ ✔ when参数描述声音应在什么时间(以秒为单位)开始播放。它使用与AudioContext的currentTime属性相同的时间坐标系。当AudioScheduledSourceNode发出的信号取决于声音的开始时间时,始终使用when的精确值, 不会将其舍入到最近的采样帧。如果为此值传入 0,或者该 值小于currentTime, 则声音会立即开始播放。如果when为负数, 则必须抛出RangeError异常。返回类型:undefined -
stop(when)-
计划声音在精确时间停止播放。如果
stop在已经调用过之后再次调用, 只会应用最后一次调用;先前调用设置的停止 时间不会应用,除非缓冲区在任何后续调用之前已经 停止。如果缓冲区已经停止,进一步调用stop将不起作用。如果在计划的开始时间之前 达到停止时间,则声音不会 播放。调用此方法时,执行以下步骤:-
如果此
AudioScheduledSourceNode的内部 槽[[source started]]不为true, 则必须抛出InvalidStateError异常。 -
检查由于下面描述的参数 约束而必须抛出的任何错误。
-
将控制消息排队 以停止
AudioScheduledSourceNode, 并在消息中包含参数 值。
AudioScheduledSourceNode.stop(when) 方法的参数。 参数 类型 可为空 可选 说明 whendouble✘ ✔ when参数描述源应在什么时间(以秒为单位)停止播放。它使用与AudioContext的currentTime属性相同的时间坐标系。如果为此值传入 0,或者该值小于currentTime, 则声音会立即停止播放。如果when为负数, 则必须抛出RangeError异常。返回类型:undefined -
1.8.
AnalyserNode
接口
此接口表示能够提供实时 频域和时域分析信息的节点。音频流将 未经处理地从输入传递到输出。
| 属性 | 值 | 备注 |
|---|---|---|
numberOfInputs
| 1 | |
numberOfOutputs
| 1 | 此输出可以不连接。 |
channelCount
| 2 | |
channelCountMode
| "max"
| |
channelInterpretation
| "speakers"
| |
| 尾部时间 | 否 |
[Exposed =Window ]interface AnalyserNode :AudioNode {constructor (BaseAudioContext ,context optional AnalyserOptions = {});options undefined getFloatFrequencyData (Float32Array );array undefined getByteFrequencyData (Uint8Array );array undefined getFloatTimeDomainData (Float32Array );array undefined getByteTimeDomainData (Uint8Array );array attribute unsigned long fftSize ;readonly attribute unsigned long frequencyBinCount ;attribute double minDecibels ;attribute double maxDecibels ;attribute double smoothingTimeConstant ; };
1.8.1. 构造函数
AnalyserNode(context, options)-
当使用一个
BaseAudioContextc 和 一个选项对象 option 调用构造函数时,用户代理必须初始化 AudioNode this,并将 context 和 options 作为参数。AnalyserNode.constructor() 方法的参数。 参数 类型 可为空 可选 说明 contextBaseAudioContext✘ ✘ 这个新的 AnalyserNode将与之关联的BaseAudioContext。optionsAnalyserOptions✘ ✔ 此 AnalyserNode的可选初始参数值。
1.8.2. 属性
fftSize, 类型为 unsigned long-
用于频域分析的 FFT 大小(以采样帧为单位)。 它必须是 32 到 32768 范围内的 2 的幂,否则必须抛出
IndexSizeError异常。默认值为 2048。 请注意,较大的 FFT 大小可能具有较高的计算开销。如果将
fftSize更改为不同的值, 则与频率数据平滑相关的所有状态 (用于getByteFrequencyData()和getFloatFrequencyData()) 都会被重置。也就是说,用于随时间平滑的 前一个块 \(\hat{X}_{-1}[k]\) 对所有 \(k\) 都设置为 0。请注意,增大
fftSize确实意味着 当前时域数据必须扩展,以包含 之前未包含的过去帧。这意味着AnalyserNode实际上必须保留最近的 32768 个采样帧,而当前时域 数据是其中最近的fftSize个采样帧。 frequencyBinCount, 类型为 unsigned long,只读-
FFT 大小的一半。
maxDecibels, 类型为 double-
maxDecibels是 FFT 分析数据缩放范围中的最大功率值, 用于转换为无符号字节 值。默认值为 -30。如果 此属性的值被设置为小于或等于minDecibels的值,则必须抛出IndexSizeError异常。 minDecibels, 类型为 double-
minDecibels是 FFT 分析数据缩放范围中的最小功率值, 用于转换为无符号字节 值。默认值为 -100。如果 此属性的值被设置为大于或等于maxDecibels的值,则必须抛出IndexSizeError异常。 smoothingTimeConstant, 类型为 double-
一个从 0 -> 1 的值,其中 0 表示不与 上一个分析帧进行时间平均。默认值为 0.8。如果此 属性的值被设置为 小于 0 或大于 1,则必须抛出
IndexSizeError异常。
1.8.3. 方法
getByteFrequencyData(array)-
将当前频率数据 写入 array。如果 array 的字节长度小于
frequencyBinCount, 则多出的元素会被丢弃。如果 array 的 字节长度大于frequencyBinCount, 则多出的元素会被忽略。使用最近的fftSize个帧来计算频率数据。如果在与前一次调用相同的 渲染量子内再次调用
getByteFrequencyData()或getFloatFrequencyData(), 则不会使用相同数据更新当前 频率数据。而是返回 先前计算的数据。存储在无符号字节数组中的值按 以下方式计算。令 \(Y[k]\) 为当前频率 数据,如FFT 加窗和 随时间平滑中所述。那么字节值 \(b[k]\) 为
$$
    b[k] = \left\lfloor
            \frac{255}{\mbox{dB}_{max} - \mbox{dB}_{min}}
            \left(Y[k] - \mbox{dB}_{min}\right)
        \right\rfloor
$$
其中 \(\mbox{dB}_{min}\) 为
minDecibels, \(\mbox{dB}_{max}\) 为maxDecibelsAnalyserNode.getByteFrequencyData() 方法的参数。 参数 类型 可为空 可选 说明 arrayUint8Array✘ ✘ 频域分析数据将被复制到此参数。 返回类型:undefined getByteTimeDomainData(array)-
将当前时域 数据(波形数据) 写入 array。如果 array 的字节长度小于
fftSize, 则多出的元素会被丢弃。如果 array 的 字节长度大于fftSize, 则多出的元素会被忽略。使用最近的fftSize个帧来计算字节数据。存储在无符号字节数组中的值按 以下方式计算。令 \(x[k]\) 为时域数据。那么 字节值 \(b[k]\) 为
$$
    b[k] = \left\lfloor 128(1 + x[k]) \right\rfloor.
$$
如果 \(b[k]\) 超出 0 到 255 的范围,则将 \(b[k]\) 裁剪到该范围内。
AnalyserNode.getByteTimeDomainData() 方法的参数。 参数 类型 可为空 可选 说明 arrayUint8Array✘ ✘ 时域采样数据将被复制到此参数。 返回类型:undefined getFloatFrequencyData(array)-
将当前频率数据 写入 array。如果 array 的元素数量少于
frequencyBinCount, 则多出的 元素会被丢弃。如果 array 的元素数量多于frequencyBinCount, 则多出的元素会被忽略。使用最近的fftSize个帧来计算频率数据。如果在与前一次调用相同的 渲染量子内再次调用
getFloatFrequencyData()或getByteFrequencyData(), 则不会使用相同数据更新当前 频率数据。而是返回 先前计算的数据。频率数据的单位为 dB。
AnalyserNode.getFloatFrequencyData() 方法的参数。 参数 类型 可为空 可选 说明 arrayFloat32Array✘ ✘ 频域分析数据将被复制到此参数。 返回类型:undefined getFloatTimeDomainData(array)-
将当前时域 数据(波形数据) 写入 array。如果 array 的元素数量少于
fftSize的值,则多出的元素会被丢弃。如果 array 的元素数量多于fftSize的值,则多出的 元素会被忽略。会写入最近的fftSize个帧 (降混之后)。AnalyserNode.getFloatTimeDomainData() 方法的参数。 参数 类型 可为空 可选 说明 arrayFloat32Array✘ ✘ 时域采样数据将被复制到此参数。 返回类型:undefined
1.8.4.
AnalyserOptions
这指定了构造
AnalyserNode
时使用的选项。
所有成员都是可选的;如果未
指定,则使用常规默认值构造
节点。
dictionary AnalyserOptions :AudioNodeOptions {unsigned long fftSize = 2048;double maxDecibels = -30;double minDecibels = -100;double smoothingTimeConstant = 0.8; };
1.8.4.1.
字典 AnalyserOptions
成员
fftSize, 类型为 unsigned long,默认值为2048-
用于频域分析的 FFT 所需初始大小。
maxDecibels, 类型为 double,默认值为-30-
FFT 分析所需的初始最大功率,以 dB 为单位。
minDecibels, 类型为 double,默认值为-100-
FFT 分析所需的初始最小功率,以 dB 为单位。
smoothingTimeConstant, 类型为 double,默认值为0.8-
FFT 分析所需的初始平滑常数。
1.8.5. 时域降混
计算当前
时域数据时,输入信号必须降混为单声道,就像
channelCount
为 1、
channelCountMode
为
"max",
且 channelInterpretation
为 "speakers"。
这与
AnalyserNode
本身的设置无关。最近的
fftSize
个帧用于
降混操作。
1.8.6. FFT 加窗和随时间平滑
计算当前频率 数据时,应执行以下操作:
-
计算当前时域数据。
-
对时域输入数据应用 Blackman 窗。
-
对加窗后的时域输入数据应用傅里叶变换, 以获得实部和虚部 频率数据。
-
对频域数据进行随时间平滑。
以下令 \(N\) 为此 AnalyserNode
的
fftSize
属性的值。
$$
\begin{align*}
    \alpha &= \mbox{0.16} \\ a_0 &= \frac{1-\alpha}{2} \\
    a_1 &= \frac{1}{2} \\
    a_2 &= \frac{\alpha}{2} \\
    w[n] &= a_0 - a_1 \cos\frac{2\pi n}{N} + a_2 \cos\frac{4\pi n}{N}, \mbox{ for } n = 0, \ldots, N - 1
\end{align*}
$$
加窗后的信号 \(\hat{x}[n]\) 为
$$
    \hat{x}[n] = x[n] w[n], \mbox{ for } n = 0, \ldots, N - 1
$$
$$
    X[k] = \frac{1}{N} \sum_{n = 0}^{N - 1} \hat{x}[n]\, W^{-kn}_{N}
$$
对于 \(k = 0, \dots, N/2-1\),其中 \(W_N = e^{2\pi i/N}\)。
-
令 \(\hat{X}_{-1}[k]\) 为此操作对 前一个块执行后的结果。 前一个 块定义为 前一次随时间平滑操作计算得到的缓冲区, 如果这是第一次进行随时间平滑, 则定义为一个包含 \(N\) 个零的数组。
-
令 \(\tau\) 为此
AnalyserNode的smoothingTimeConstant属性值。 -
令 \(X[k]\) 为对当前块应用傅里叶变换的结果。
那么平滑后的值 \(\hat{X}[k]\) 按如下方式计算
$$
    \hat{X}[k] = \tau\, \hat{X}_{-1}[k] + (1 - \tau)\, \left|X[k]\right|
$$
-
如果 \(\hat{X}[k]\) 为
NaN、正无穷或负无穷,则将 \(\hat{X}[k]\) 设置为 0。
对于 \(k = 0, \ldots, N - 1\)。
$$
    Y[k] = 20\log_{10}\hat{X}[k]
$$
对于 \(k = 0, \ldots, N-1\)。
此数组 \(Y[k]\) 会复制到
getFloatFrequencyData()
的输出数组中。
对于
getByteFrequencyData(),
\(Y[k]\) 会被裁剪到
minDecibels
和
maxDecibelsminDecibels
由值 0 表示,而
maxDecibels
1.9.
AudioBufferSourceNode
接口
此接口表示来自
AudioBuffer
中内存音频资源的音频源。
它适用于播放需要高度调度灵活性和
精确性的音频资源。如果需要对网络或磁盘支持的
资源进行采样级精确播放,实现者应使用
AudioWorkletNode
来实现播放。
start()
方法用于
计划声音何时播放。start()
方法不能
多次调用。当缓冲区的音频数据全部播放完毕
(如果 loop
属性为 false)时,播放会自动停止;或者当调用了
stop()
方法并且达到指定时间时停止。更多
详细信息请参阅 start()
和
stop()
的说明。
| 属性 | 值 | 备注 |
|---|---|---|
numberOfInputs
| 0 | |
numberOfOutputs
| 1 | |
channelCount
| 2 | |
channelCountMode
| "max"
| |
channelInterpretation
| "speakers"
| |
| 尾部时间 | 否 |
输出的声道数量等于赋给
buffer
属性的 AudioBuffer 的声道数量;
如果 buffer
为
null,则为一个静音声道。
此外,如果缓冲区具有多个声道,
那么 AudioBufferSourceNode
的输出必须在以下任一条件成立的时刻之后的某个渲染量子开始处
更改为一个静音声道:
AudioBufferSourceNode
的播放头位置
定义为任何表示相对于缓冲区中第一个采样帧的时间坐标的、
以秒为单位的时间偏移量。
这些值应独立于节点的 playbackRate 和 detune
参数进行考虑。
一般来说,播放头位置可以具有子采样级精度,并且不必
指向精确的采样帧位置。它们可以取
0 到缓冲区持续时间之间的有效值。
playbackRate
和
detune
属性构成一个
复合参数。
它们一起用于确定
computedPlaybackRate 值:
computedPlaybackRate(t) = playbackRate(t) * pow(2, detune(t) / 1200)
此复合参数 的标称范围 为 \((-\infty, \infty)\)。
AudioBufferSourceNode
创建时带有一个内部布尔
槽 [[buffer set]],初始
设置为 false。
[Exposed =Window ]interface AudioBufferSourceNode :AudioScheduledSourceNode {constructor (BaseAudioContext ,context optional AudioBufferSourceOptions = {});options attribute AudioBuffer ?buffer ;readonly attribute AudioParam playbackRate ;readonly attribute AudioParam detune ;attribute boolean loop ;attribute double loopStart ;attribute double loopEnd ;undefined start (optional double when = 0,optional double offset ,optional double duration ); };
1.9.1. 构造函数
AudioBufferSourceNode(context, options)-
当使用一个
BaseAudioContextc 和 一个选项对象 option 调用构造函数时,用户代理必须初始化 AudioNode this,并将 context 和 options 作为参数。AudioBufferSourceNode.constructor() 方法的参数。 参数 类型 可为空 可选 说明 contextBaseAudioContext✘ ✘ 这个新的 AudioBufferSourceNode将与之关联的BaseAudioContext。optionsAudioBufferSourceOptions✘ ✔ 此 AudioBufferSourceNode的可选初始参数值。
1.9.2. 属性
buffer, 类型为 AudioBuffer, 可为空-
表示要播放的音频资源。
要设置buffer属性,执行以下步骤:-
令 new buffer 为要赋给
buffer的AudioBuffer或null值。 -
如果 new buffer 不为
null,且[[buffer set]]为 true,则抛出InvalidStateError并中止这些步骤。 -
如果 new buffer 不为
null,则将[[buffer set]]设置为 true。 -
将 new buffer 赋给
buffer属性。
-
detune, 类型为 AudioParam, 只读-
一个以音分为单位的附加参数,用于调制 音频流的渲染速度。此参数与
playbackRate构成一个复合 参数,以形成 computedPlaybackRate。参数 值 备注 defaultValue0 minValue最小负单精度浮点值 约为 -3.4028235e38 maxValue最大正单精度浮点值 约为 3.4028235e38 automationRate" k-rate"具有自动化速率 约束 loop, 类型为 booleanloopEnd, 类型为 double-
一个可选的播放头 位置,当
loop属性为 true 时,循环应在此处结束。其值不包含 循环内容。其默认value为 0,并且可以有效地 设置为 0 到缓冲区持续时间之间的任意值。如果loopEnd小于或等于 0,或者loopEnd大于缓冲区持续时间, 则循环将在缓冲区末尾结束。 loopStart, 类型为 double-
一个可选的播放头位置,当
loop属性为 true 时,循环应从此处开始。其默认value为 0,并且可以有效地设置为 0 到缓冲区持续时间之间的任意值。如果loopStart小于 0,则循环将从 0 开始。如果loopStart大于缓冲区持续时间,则循环将在 缓冲区末尾开始。 playbackRate, 类型为 AudioParam, 只读-
渲染音频流的速度。这与
detune构成一个复合 参数,以形成 computedPlaybackRate。参数 值 备注 defaultValue1 minValue最小负单精度浮点值 约为 -3.4028235e38 maxValue最大正单精度浮点值 约为 3.4028235e38 automationRate" k-rate"具有自动化速率 约束
1.9.3. 方法
start(when, offset, duration)-
计划声音在精确时间开始播放。
调用此方法时,执行以下步骤:-
如果此
AudioBufferSourceNode的内部 槽[[source started]]为true,则必须抛出InvalidStateError异常。 -
检查由于下面描述的参数 约束而必须抛出的任何错误。如果在此 步骤期间抛出任何异常, 则中止这些步骤。
-
将此
AudioBufferSourceNode上的内部槽[[source started]]设置为true。 -
将控制 消息排队以启动
AudioBufferSourceNode, 并在消息中包含参数值。 -
仅当满足以下 所有条件时,才向关联的
AudioContext发送一条控制消息,以 开始运行其渲染线程:-
上下文的
[[control thread state]]为suspended。 -
上下文允许启动。
-
[[suspended by user]]标志为false。
注: 这可以允许
start()启动一个当前允许启动、 但此前曾被阻止启动的AudioContext。 -
AudioBufferSourceNode.start(when, offset, duration) 方法的参数。 参数 类型 可为空 可选 说明 whendouble✘ ✔ when参数描述声音应在什么时间(以秒为单位) 开始播放。它使用与AudioContext的currentTime属性相同的时间坐标系。如果为此值传入 0,或者该值小于 currentTime,则声音会立即开始播放。如果when为负数,则必须抛出RangeError异常。offsetdouble✘ ✔ offset参数提供播放开始处的播放头位置。 如果为此值传入 0,则播放将从缓冲区开头开始。如果offset为负数,则必须抛出RangeError异常。如果offset大于loopEnd,playbackRate为正数或零,并且loop为true,则播放将从loopEnd开始。 如果offset大于loopStart,playbackRate为负数,并且loop为true,则播放将从loopStart开始。 当达到startTime时,offset会被静默钳制到 [0,duration], 其中duration是设置给此AudioBufferSourceNode的buffer属性的AudioBuffer的duration属性值。durationdouble✘ ✔ duration参数描述要播放的声音持续时间,以要输出的缓冲区内容总秒数表示, 包括任何完整或部分循环迭代。duration的单位不受playbackRate影响。 例如,duration为 5 秒且播放速率为 0.5 时,将以一半 速度输出 5 秒的缓冲区内容,从而产生 10 秒的可听输出。如果duration为负数,则必须抛出RangeError异常。返回类型:undefined -
1.9.4.
AudioBufferSourceOptions
这指定了构造
AudioBufferSourceNode
时使用的选项。
所有成员都是
可选的;如果未指定,则在构造节点时使用
常规默认值。
dictionary AudioBufferSourceOptions {AudioBuffer ?buffer ;float detune = 0;boolean loop =false ;double loopEnd = 0;double loopStart = 0;float playbackRate = 1; };
1.9.4.1.
字典 AudioBufferSourceOptions
成员
buffer, 类型为 AudioBuffer, 可为空-
要播放的音频资源。这等价于将
buffer赋给AudioBufferSourceNode的buffer属性。 detune, 类型为 float,默认值为0-
detuneAudioParam 的初始值。 loop, 类型为 boolean,默认值为false-
loop属性的初始值。 loopEnd, 类型为 double,默认值为0-
loopEnd属性的初始值。 loopStart, 类型为 double,默认值为0-
loopStart属性的初始值。 playbackRate, 类型为 float,默认值为1-
playbackRateAudioParam 的初始值。
1.9.5. 循环
本节为非规范性内容。有关规范性要求,请参阅播放 算法。
将 loop
属性设置为 true,会使由端点 loopStart
和 loopEnd
定义的缓冲区区域在
循环区域的任何部分被播放后无限继续播放。当
loop
保持为 true 时,
循环播放将持续进行,直到发生以下情况之一:
循环主体被视为占据从
loopStart
开始、直到但不包括
loopEnd
的区域。
循环区域的播放方向遵循节点播放速率的符号。
对于正播放速率,循环从 loopStart
到 loopEnd;
对于负速率,循环
从 loopEnd
到
loopStart。
循环不会影响
start()
的 offset 参数的解释。
播放始终从请求的偏移量开始,只有在播放期间遇到
循环主体后才开始循环。
有效循环开始点和结束点必须位于
零到缓冲区持续时间的范围内,如下面的
算法所指定。loopEnd
还进一步受到约束,必须位于
loopStart
处或其后。如果
违反任何这些约束,则认为循环
包含整个缓冲区内容。
循环端点具有子采样级精度。当端点没有落在 精确采样帧偏移上,或者播放速率不 等于 1 时,会对循环播放进行插值,将循环的 开头和结尾拼接在一起,就像循环音频 出现在缓冲区连续的非循环区域中一样。
与循环相关的属性可以在缓冲区播放期间 改变,并且通常在下一个渲染量子生效。 精确结果由下面的规范性播放算法 定义。
loopStart
和 loopEnd
属性的默认值均为 0。由于
loopEnd
值为零
等价于缓冲区长度,因此默认端点
会使整个缓冲区包含在循环中。
请注意,循环端点的值表示为
相对于缓冲区采样率的时间偏移量,这意味着
这些值独立于节点的 playbackRate
参数,而该参数在播放过程中可以
动态变化。
1.9.6. 播放 AudioBuffer 内容
本规范性章节规定了缓冲区内容的播放, 并考虑到播放受到以下因素 共同影响:
-
起始偏移量,可以用子采样精度表示。
-
循环点,可以用子采样精度表示,并且可以 在播放期间动态变化。
-
播放速率和失谐参数,它们组合产生一个 computedPlaybackRate,其可以采用 正或负的有限值。
为了从
AudioBufferSourceNode
内部生成输出而应遵循的算法符合以下原则:
-
用户代理可以在任何需要的位置任意对缓冲区进行重采样, 以提高输出的效率或质量。
-
子采样起始偏移量或循环点可能需要在采样帧之间 进行额外插值。
-
循环缓冲区的播放行为应与包含循环 音频内容连续副本的非循环缓冲区相同, 插值产生的任何影响除外。
算法说明如下:
let buffer; // 此节点使用的 AudioBuffer let context; // 此节点使用的 AudioContext // 以下变量保存此节点的属性值和 AudioParam 值。 // 它们按 k-rate 更新,在每次调用 process() 之前进行。 let loop; let detune; let loopStart; let loopEnd; let playbackRate; // 节点播放参数的变量 let start= 0 , offset= 0 , duration= Infinity ; // 由 start() 设置 let stop= Infinity ; // 由 stop() 设置 // 用于跟踪节点播放状态的变量 let bufferTime= 0 , started= false , enteredLoop= false ; let bufferTimeElapsed= 0 ; let dt= 1 / context. sampleRate; // 处理 start 方法调用 function handleStart( when, pos, dur) { if ( arguments. length>= 1 ) { start= when; } offset= pos; if ( arguments. length>= 3 ) { duration= dur; } } // 处理 stop 方法调用 function handleStop( when) { if ( arguments. length>= 1 ) { stop= when; } else { stop= context. currentTime; } } // 对某个采样帧的多声道信号值进行插值。 // 返回信号值数组。 function playbackSignal( position) { /* 此函数提供 buffer 的播放信号函数,该函数 将播放头位置映射到一组输出信号 值,每个输出声道对应一个值。如果 |position| 对应于 buffer 中精确采样帧的位置,则此函数返回 该帧。否则,其返回值由用户代理提供的 算法确定,该算法在 |position| 附近的采样帧之间 进行插值。 如果 |position| 大于或等于 |loopEnd|,并且 buffer 中不存在后续 采样帧,则插值应基于从 |loopStart| 开始的 后续帧序列。 */ ... } // 生成单个音频渲染量子,并将其放入 // 由 output 定义的声道数组中。返回包含 // 要输出的 |numberOfFrames| 个采样帧的数组。 function process( numberOfFrames) { let currentTime= context. currentTime; // 下一个渲染帧的上下文时间 const output= []; // 累积已渲染的采样帧 // 合并影响播放速率的两个 k-rate 参数 const computedPlaybackRate= playbackRate* Math. pow( 2 , detune/ 1200 ); // 根据需要确定循环端点 let actualLoopStart, actualLoopEnd; if ( loop&& buffer!= null ) { if ( loopStart>= 0 && loopEnd> 0 && loopStart< loopEnd) { actualLoopStart= loopStart; actualLoopEnd= Math. min( loopEnd, buffer. duration); } else { actualLoopStart= 0 ; actualLoopEnd= buffer. duration; } } else { // 如果 loop 标志为 false,则移除任何已进入循环的记录 enteredLoop= false ; } // 处理 buffer 为 null 的情况 if ( buffer== null ) { stop= currentTime; // 强制所有时间都输出零 } // 渲染量子中的每个采样帧 for ( let index= 0 ; index< numberOfFrames; index++ ) { // 检查 currentTime 和 bufferTimeElapsed 是否 // 位于允许播放的范围内 if ( currentTime< start|| currentTime>= stop|| bufferTimeElapsed>= duration) { output. push( 0 ); // 此采样帧为静音 currentTime+= dt; continue ; } if ( ! started) { // 记录 buffer 已开始播放,并获取初始 // 播放头位置。 if ( loop&& computedPlaybackRate>= 0 && offset>= actualLoopEnd) { offset= actualLoopEnd; } if ( computedPlaybackRate< 0 && loop&& offset< actualLoopStart) { offset= actualLoopStart; } bufferTime= offset; started= true ; } // 处理与循环相关的计算 if ( loop) { // 确定是否首次进入循环部分 if ( ! enteredLoop) { if ( offset< actualLoopEnd&& bufferTime>= actualLoopStart) { // 播放在循环之前或循环内部开始,且播放头现在 // 已越过循环起点 enteredLoop= true ; } if ( offset>= actualLoopEnd&& bufferTime< actualLoopEnd) { // 播放在循环之后开始,且播放头现在位于 // 循环终点之前 enteredLoop= true ; } } // 根据需要回绕循环迭代。请注意,enteredLoop // 可能会在前面的条件语句中变为 true。 if ( enteredLoop) { while ( bufferTime>= actualLoopEnd) { bufferTime-= actualLoopEnd- actualLoopStart; } while ( bufferTime< actualLoopStart) { bufferTime+= actualLoopEnd- actualLoopStart; } } } if ( bufferTime>= 0 && bufferTime< buffer. duration) { output. push( playbackSignal( bufferTime)); } else { output. push( 0 ); // 已越过 buffer 末尾,因此输出静音帧 } bufferTime+= dt* computedPlaybackRate; bufferTimeElapsed+= dt* computedPlaybackRate; currentTime+= dt; } // 渲染量子循环结束 if ( currentTime>= stop) { // 结束此节点的播放状态。不再调用 process() // 。计划一次更改,将输出声道数设置为 1。 } return output; }
以下非规范性图示说明了该算法在 各种关键场景下的行为。这里不考虑缓冲区的动态 重采样,但只要循环位置的时间 不发生变化,就不会对最终播放产生实质性 影响。在所有图中,采用以下约定:
-
上下文采样率为 1000 Hz
-
AudioBuffer内容以第一个采样帧位于 x 原点的方式显示。 -
输出信号以位于时间
start的采样帧处于 x 原点的方式显示。 -
所有图中均采用线性插值表示,尽管用户代理 可以采用其他插值技术。
-
图中标注的
duration值指的是buffer,而不是传递给start()的参数
此图说明了缓冲区的基本播放,其中包含一个简单循环, 该循环在缓冲区最后一个采样帧之后结束:
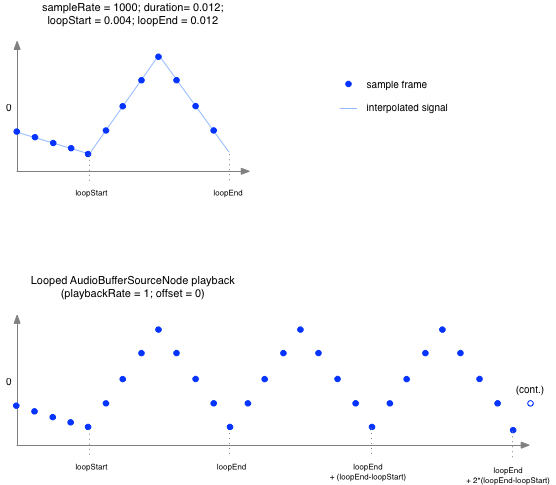
AudioBufferSourceNode
基本播放
此图说明了 playbackRate 插值,
展示了以半速播放缓冲区内容的情况,其中每隔一个
输出采样帧进行插值。尤其值得注意的是循环输出中的最后一个
采样帧,它使用
循环起点进行插值:
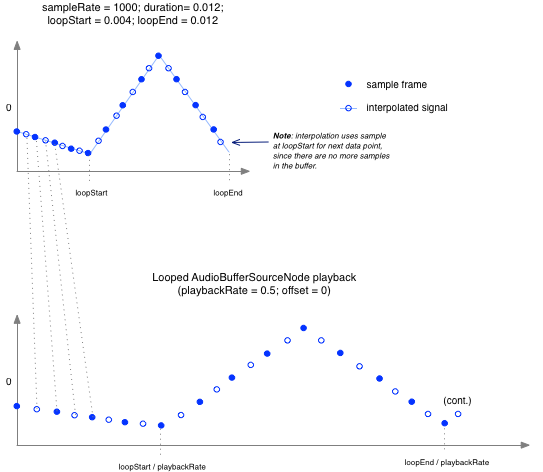
AudioBufferSourceNode
playbackRate 插值
此图说明了采样率插值,展示了播放 采样率为上下文采样率 50% 的缓冲区, 从而产生 0.5 的计算播放速率,以校正 缓冲区与上下文之间的采样率差异。最终 输出与前一个示例相同,但原因 不同。
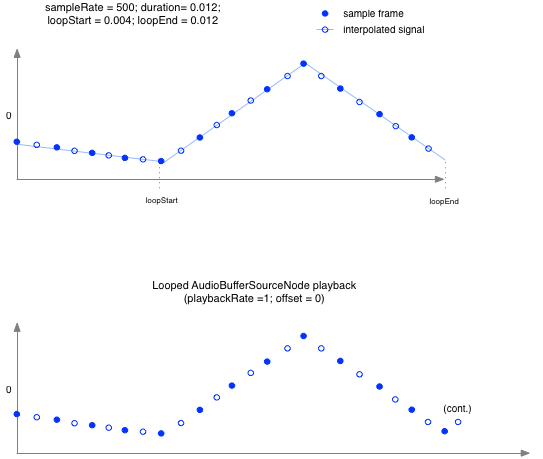
AudioBufferSourceNode
采样率插值。
此图说明了子采样偏移播放,其中 缓冲区内的偏移量恰好从半个采样帧处开始。 因此,每个输出帧都会进行插值:
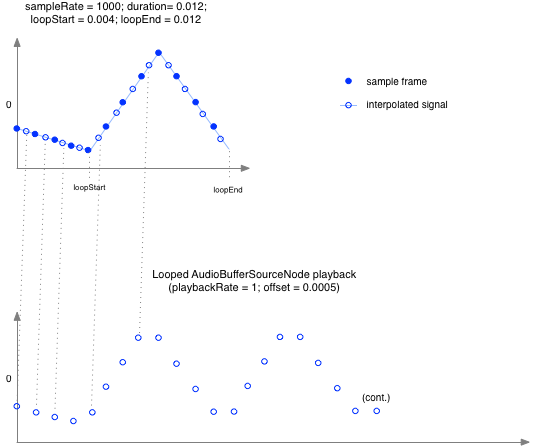
AudioBufferSourceNode
子采样偏移播放
此图说明了子采样循环播放,展示 循环端点中的小数帧偏移如何映射到缓冲区中的插值 数据点,并使这些偏移如同 精确采样帧的引用一样得到遵循:
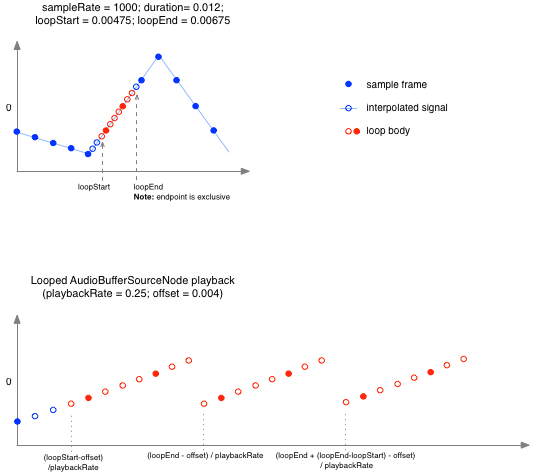
AudioBufferSourceNode
子采样循环播放
1.10.
AudioDestinationNode
接口
这是一个表示最终音频
目标的 AudioNode,
也是用户最终会听到的内容。它通常可以
被视为连接到
扬声器的音频输出设备。所有要被听到的渲染音频都会被路由到此节点,
它是 AudioContext
路由
图中的“终端”节点。每个
AudioContext
只有一个 AudioDestinationNode,
通过
AudioContext
的 destination 属性提供。
AudioDestinationNode
的输出通过
对其输入求和生成,从而可以将
AudioContext
的输出捕获到例如
MediaStreamAudioDestinationNode
或
MediaRecorder(在 [mediastream-recording] 中描述)。
AudioDestinationNode
可以是
AudioContext
或 OfflineAudioContext
的目标,并且声道
属性取决于上下文的类型。
对于 AudioContext,
默认值为
| 属性 | 值 | 备注 |
|---|---|---|
numberOfInputs
| 1 | |
numberOfOutputs
| 1 | |
channelCount
| 2 | |
channelCountMode
| "explicit"
| |
channelInterpretation
| "speakers"
| |
| 尾部时间 | 否 |
channelCount
可以设置为任何
小于或等于 maxChannelCount
的值。
如果此值不在有效范围内,
则必须抛出 IndexSizeError
异常。举一个具体
示例,如果音频硬件支持 8 声道输出,那么我们可以
将 channelCount
设置为 8,并渲染 8
声道输出。
对于 OfflineAudioContext,
默认值为
| 属性 | 值 | 备注 |
|---|---|---|
numberOfInputs
| 1 | |
numberOfOutputs
| 1 | |
channelCount
| numberOfChannels | |
channelCountMode
| "explicit"
| |
channelInterpretation
| "speakers"
| |
| 尾部时间 | 否 |
其中 numberOfChannels 是
构造 OfflineAudioContext
时指定的声道数量。
此值不能更改;如果
channelCount
被更改为其他值,则必须抛出
NotSupportedError
异常。
[Exposed =Window ]interface AudioDestinationNode :AudioNode {readonly attribute unsigned long maxChannelCount ; };
1.10.1. 属性
maxChannelCount, 类型为 unsigned long,只读-
channelCount属性可以设置为的最大声道数。 表示音频硬件端点(通常情况)的AudioDestinationNode在音频硬件为多声道时,可能能够输出 多于 2 个声道的音频。maxChannelCount是该硬件能够支持的最大 声道数。
1.11.
AudioListener
接口
此接口表示正在聆听音频场景的人的位置和朝向。
所有 PannerNode
对象都相对于
BaseAudioContext
的
listener
进行空间化。
有关空间化的更多详细信息,请参阅
§ 6 空间化/声像定位。
positionX、
positionY
和 positionZ
参数表示
监听者在 3D 笛卡尔坐标空间中的位置。
PannerNode
对象使用相对于
各个音频源的此位置进行空间化。
forwardX、
forwardY
和 forwardZ
参数表示
3D 空间中的方向向量。forward 向量和
up 向量共同用于确定
监听者的朝向。用简单的人体概念来说,forward 向量
表示人的鼻子所指的方向。
up 向量表示人的
头顶所指的方向。预期这两个向量
线性无关。有关如何解释这些值的规范性要求,
请参阅 § 6 空间化/声像定位一节。
[Exposed =Window ]interface AudioListener {readonly attribute AudioParam positionX ;readonly attribute AudioParam positionY ;readonly attribute AudioParam positionZ ;readonly attribute AudioParam forwardX ;readonly attribute AudioParam forwardY ;readonly attribute AudioParam forwardZ ;readonly attribute AudioParam upX ;readonly attribute AudioParam upY ;readonly attribute AudioParam upZ ;undefined setPosition (float ,x float ,y float );z undefined setOrientation (float ,x float ,y float ,z float ,xUp float ,yUp float ); };zUp
1.11.1. 属性
forwardX, 类型为 AudioParam, 只读-
设置监听者在 3D 笛卡尔坐标空间中所指前方方向的 x 坐标分量。
参数 值 备注 defaultValue0 minValue最小负单精度浮点数 约 -3.4028235e38 maxValue最大正单精度浮点数 约 3.4028235e38 automationRate" a-rate" forwardY, 类型为 AudioParam, 只读-
设置监听者在 3D 笛卡尔坐标空间中所指前方方向的 y 坐标分量。
参数 值 备注 defaultValue0 minValue最小负单精度浮点数 约 -3.4028235e38 maxValue最大正单精度浮点数 约 3.4028235e38 automationRate" a-rate" forwardZ, 类型为 AudioParam, 只读-
设置监听者在 3D 笛卡尔坐标空间中所指前方方向的 z 坐标分量。
参数 值 备注 defaultValue-1 minValue最小负单精度浮点数 约 -3.4028235e38 maxValue最大正单精度浮点数 约 3.4028235e38 automationRate" a-rate" positionX, 类型为 AudioParam, 只读-
设置音频监听者在 3D 笛卡尔坐标空间中的 x 坐标位置。
参数 值 备注 defaultValue0 minValue最小负单精度浮点数 约 -3.4028235e38 maxValue最大正单精度浮点数 约 3.4028235e38 automationRate" a-rate" positionY, 类型为 AudioParam, 只读-
设置音频监听者在 3D 笛卡尔坐标空间中的 y 坐标位置。
参数 值 备注 defaultValue0 minValue最小负单精度浮点数 约 -3.4028235e38 maxValue最大正单精度浮点数 约 3.4028235e38 automationRate" a-rate" positionZ, 类型为 AudioParam, 只读-
设置音频监听者在 3D 笛卡尔坐标空间中的 z 坐标位置。
参数 值 备注 defaultValue0 minValue最小负单精度浮点数 约 -3.4028235e38 maxValue最大正单精度浮点数 约 3.4028235e38 automationRate" a-rate" upX, 类型为 AudioParam, 只读-
设置监听者在 3D 笛卡尔坐标空间中所指上方方向的 x 坐标分量。
参数 值 备注 defaultValue0 minValue最小负单精度浮点数 约 -3.4028235e38 maxValue最大正单精度浮点数 约 3.4028235e38 automationRate" a-rate" upY, 类型为 AudioParam, 只读-
设置监听者在 3D 笛卡尔坐标空间中所指上方方向的 y 坐标分量。
参数 值 备注 defaultValue1 minValue最小负单精度浮点数 约 -3.4028235e38 maxValue最大正单精度浮点数 约 3.4028235e38 automationRate" a-rate" upZ, 类型为 AudioParam, 只读-
设置监听者在 3D 笛卡尔坐标空间中所指上方方向的 z 坐标分量。
参数 值 备注 defaultValue0 minValue最小负单精度浮点数 约 -3.4028235e38 maxValue最大正单精度浮点数 约 3.4028235e38 automationRate" a-rate"
1.11.2. 方法
setOrientation(x, y, z, xUp, yUp, zUp)-
此方法已弃用。它等同于分别使用给定的
x、y、z、xUp、yUp和zUp值直接设置forwardX.value、forwardY.value、forwardZ.value、upX.value、upY.value和upZ.value。因此,如果在调用此方法时,
forwardX、forwardY、forwardZ、upX、upY和upZAudioParam中的任何一个已经使用setValueCurveAtTime()设置了自动化曲线, 则必须抛出NotSupportedError。setOrientation()描述监听者在 3D 笛卡尔坐标空间中所指的方向。它提供了一个 前向向量和一个 上向向量。 用简单的人体概念来说, 前向向量表示人的 鼻子所指的方向。上向向量表示 人的头顶所指的方向。预期这两个向量 线性无关。有关如何解释这些值的规范性要求, 请参阅 § 6 空间化/声像定位。x、y和z参数表示 3D 空间中的前向 方向向量,默认值为 (0,0,-1)。xUp、yUp和zUp参数表示 3D 空间中的上向方向 向量,默认值 为 (0,1,0)。AudioListener.setOrientation() 方法的参数。 参数 类型 可为空 可选 说明 xfloat✘ ✘ AudioListener的前向 x 方向yfloat✘ ✘ AudioListener的前向 y 方向zfloat✘ ✘ AudioListener的前向 z 方向xUpfloat✘ ✘ AudioListener的上向 x 方向yUpfloat✘ ✘ AudioListener的上向 y 方向zUpfloat✘ ✘ AudioListener的上向 z 方向返回类型:undefined setPosition(x, y, z)-
此方法已弃用。它等同于分别使用给定的
x、y和z值直接设置positionX.value、positionY.value和positionZ.value。因此,如果在调用此方法时, 此
AudioListener的positionX、positionY和positionZAudioParam中的任何一个已经使用setValueCurveAtTime()设置了自动化曲线, 则必须抛出NotSupportedError。setPosition()设置监听者在 3D 笛卡尔坐标 空间中的位置。PannerNode对象使用相对于各个音频源的此位置 进行空间化。默认值为 (0,0,0)。
AudioListener.setPosition() 方法的参数。 参数 类型 可为空 可选 说明 xfloat✘ ✘ AudioListener位置的 x 坐标yfloat✘ ✘ AudioListener位置的 y 坐标zfloat✘ ✘ AudioListener位置的 z 坐标
1.11.3. 处理
由于 AudioListener
的参数可以与 AudioNode
连接,
并且它们还可以影响同一图中
PannerNode
的输出,因此节点
排序算法在计算处理顺序时应将
AudioListener
考虑在内。因此,图中的所有
PannerNode
都将
AudioListener
作为输入。
1.12.
AudioProcessingEvent
接口 - 已弃用
这是一个派发到
ScriptProcessorNode
节点的 Event
对象。它将在
ScriptProcessorNode 被移除时一并移除,因为其替代者
AudioWorkletNode
使用不同的方法。
事件处理程序通过访问 inputBuffer 属性中的
音频数据来处理输入中的音频(如果有)。
处理所得的音频数据(如果没有输入,则为
合成的数据)随后会被放入
outputBuffer。
[Exposed =Window ]interface AudioProcessingEvent :Event {(constructor DOMString ,type AudioProcessingEventInit );eventInitDict readonly attribute double playbackTime ;readonly attribute AudioBuffer inputBuffer ;readonly attribute AudioBuffer outputBuffer ; };
1.12.1. 属性
inputBuffer, 类型为 AudioBuffer, 只读-
一个包含输入音频数据的 AudioBuffer。其 声道数量将等于 createScriptProcessor() 方法的
numberOfInputChannels参数。此 AudioBuffer 仅在audioprocess事件处理程序函数的作用域内有效。 在此作用域之外,其值将没有意义。 outputBuffer, 类型为 AudioBuffer, 只读-
一个必须写入输出音频数据的 AudioBuffer。其 声道数量将等于 createScriptProcessor() 方法的
numberOfOutputChannels参数。位于audioprocess事件处理程序函数作用域内的脚本代码 应修改表示此 AudioBuffer 中声道数据的Float32Array数组。在此作用域之外对该 AudioBuffer 进行的任何脚本 修改都不会产生任何可听效果。 playbackTime, 类型为 double,只读-
音频将被播放的时间,使用与
AudioContext的currentTime相同的时间坐标系。
1.12.2.
AudioProcessingEventInit
dictionary AudioProcessingEventInit :EventInit {required double playbackTime ;required AudioBuffer inputBuffer ;required AudioBuffer outputBuffer ; };
1.12.2.1.
字典 AudioProcessingEventInit
成员
inputBuffer, 类型为 AudioBuffer-
要赋给事件的
inputBuffer属性 的值。 outputBuffer, 类型为 AudioBuffer-
要赋给事件的
outputBuffer属性 的值。 playbackTime, 类型为 double-
要赋给事件的
playbackTime属性 的值。
1.13.
BiquadFilterNode
接口
BiquadFilterNode
是一个
AudioNode
处理器,实现非常常见的
低阶滤波器。
低阶滤波器是基本音调控制
(低音、中音、高音)、图形均衡器以及更高级滤波器的构建块。
可以组合多个 BiquadFilterNode
滤波器
以形成更复杂的滤波器。诸如
frequency
等滤波器参数可以
随时间改变,以实现滤波器扫描等效果。每个
BiquadFilterNode
都可以配置为
以下 IDL 中所示的多种常见滤波器类型之一。默认
滤波器类型为 "lowpass"。
frequency
和 detune
共同构成
一个复合参数,
且二者都是 a-rate。它们共同用于
确定 computedFrequency
值:
computedFrequency(t) = frequency(t) * pow(2, detune(t) / 1200)
| 属性 | 值 | 备注 |
|---|---|---|
numberOfInputs
| 1 | |
numberOfOutputs
| 1 | |
channelCount
| 2 | |
channelCountMode
| "max"
| |
channelInterpretation
| "speakers"
| |
| 尾部时间 | 是 | 在输入为零时仍会继续输出非静音音频。由于这是一个 IIR 滤波器, 滤波器会无限地产生非零输出,但在实践中,可以在经过某个有限 时间后、输出已经足够接近零时停止。实际时间取决于 滤波器系数。 |
输出的声道数量始终等于 输入的声道数量。
enum {BiquadFilterType "lowpass" ,"highpass" ,"bandpass" ,"lowshelf" ,"highshelf" ,"peaking" ,"notch" ,"allpass" };
| 枚举值 | 说明 |
|---|---|
"lowpass"
|
低通
滤波器允许低于截止频率的频率通过,
并衰减高于截止频率的频率。它实现了一个标准的二阶
谐振低通滤波器,滚降率为 12dB/倍频程。
|
"highpass"
|
高通
滤波器与低通滤波器相反。高于
截止频率的频率可以通过,而低于截止频率的频率
会被衰减。它实现了一个标准的
二阶谐振高通滤波器,滚降率为 12dB/倍频程。
|
"bandpass"
|
带通
滤波器允许一定范围的频率通过,并
衰减低于和高于该频率
范围的频率。它实现了一个二阶带通滤波器。
|
"lowshelf"
|
低架滤波器允许所有频率通过,但会对
较低频率进行提升(或衰减)。它实现了
一个二阶低架滤波器。
|
"highshelf"
|
高架滤波器与低架滤波器相反,
允许所有频率通过,但会对较高
频率进行提升。它实现了一个二阶高架滤波器
|
"peaking"
|
峰值滤波器允许所有频率通过,但会对
一定范围的频率进行提升(或衰减)。
|
"notch"
|
陷波滤波器(也称为带阻或
带拒滤波器)与带通
滤波器相反。除一组
频率之外,它允许所有频率通过。
|
"allpass"
| 全通滤波器允许所有频率通过,但会改变 各种频率之间的相位关系。它 实现了一个二阶全通滤波器 |
BiquadFilterNode
的所有属性都是 a-rate AudioParam。
[Exposed =Window ]interface BiquadFilterNode :AudioNode {(constructor BaseAudioContext ,context optional BiquadFilterOptions = {});options attribute BiquadFilterType type ;readonly attribute AudioParam frequency ;readonly attribute AudioParam detune ;readonly attribute AudioParam Q ;readonly attribute AudioParam gain ;undefined getFrequencyResponse (Float32Array ,frequencyHz Float32Array ,magResponse Float32Array ); };phaseResponse
1.13.1. 构造函数
BiquadFilterNode(context, options)-
当使用
BaseAudioContextc 和 选项对象 option 调用构造函数时,用户代理必须以 context 和 options 作为参数, 初始化 AudioNode this。BiquadFilterNode.constructor() 方法的参数。 参数 类型 可为空 可选 说明 contextBaseAudioContext✘ ✘ 此新 BiquadFilterNode将关联的BaseAudioContext。optionsBiquadFilterOptions✘ ✔ 此 BiquadFilterNode的可选初始参数值。
1.13.2. 属性
Q, 类型为 AudioParam, 只读-
滤波器的 Q 因子。
对于
lowpass和highpass滤波器,Q值被解释为 dB。对于这些滤波器,标称范围为 \([-Q_{lim}, Q_{lim}]\),其中 \(Q_{lim}\) 是使 \(10^{Q/20}\) 不会溢出的最大 值。该值约为 \(770.63678\)。对于
bandpass、notch、allpass和peaking滤波器,此值是一个 线性值。该值与滤波器的带宽 有关,因此应为正值。 标称范围为 \([0, 3.4028235e38]\),上限 为最大正单精度浮点数。lowshelf和highshelf滤波器不使用此值。参数 值 备注 defaultValue1 minValue最小负单精度浮点数 约 -3.4028235e38,但有关不同 滤波器的实际限制,请参阅上文 maxValue最大正单精度浮点数 约 3.4028235e38,但有关不同 滤波器的实际限制,请参阅上文 automationRate" a-rate" detune, 类型为 AudioParam, 只读-
频率的失谐值,以音分为单位。它与
frequency共同构成一个 复合 参数,以形成 computedFrequency。参数 值 备注 defaultValue0 minValue\(\approx -153600\) maxValue\(\approx 153600\) 此值约为 \(1200\ \log_2 \mathrm{FLT\_MAX}\),其中 FLT_MAX 是最大的 float值。automationRate" a-rate" frequency, 类型为 AudioParam, 只读-
BiquadFilterNode工作的频率,以 Hz 为单位。它与detune共同构成一个复合参数, 以形成 computedFrequency。参数 值 备注 defaultValue350 minValue0 maxValue奈奎斯特频率 automationRate" a-rate" gain, 类型为 AudioParam, 只读-
滤波器的增益。其值以 dB 为单位。增益 仅用于
lowshelf、highshelf和peaking滤波器。参数 值 备注 defaultValue0 minValue最小负单精度浮点数 约 -3.4028235e38 maxValue\(\approx 1541\) 此值约为 \(40\ \log_{10} \mathrm{FLT\_MAX}\),其中 FLT_MAX 是最大的 float值。automationRate" a-rate" type, 类型为 BiquadFilterType-
此
BiquadFilterNode的类型。其 默认值为 "lowpass"。 其他参数的确切含义取决于type属性的值。
1.13.3. 方法
getFrequencyResponse(frequencyHz, magResponse, phaseResponse)-
给定每个滤波器参数的
[[current value]], 同步计算 指定频率的频率响应。这三个参数必须是 长度相同的Float32Array, 否则必须抛出InvalidAccessError。返回的频率响应必须使用 当前处理块采样的
AudioParam来计算。BiquadFilterNode.getFrequencyResponse() 方法的参数。 参数 类型 可为空 可选 说明 frequencyHzFloat32Array✘ ✘ 此参数指定一个频率数组,以 Hz 为单位,将在这些频率处计算响应值。 magResponseFloat32Array✘ ✘ 此参数指定一个用于接收线性幅度响应值的输出数组。 如果 frequencyHz参数中的某个值不在 [0, sampleRate/2] 范围内, 其中sampleRate是sampleRate属性在AudioContext中的值, 则magResponse数组中相同索引处的对应值必须为NaN。phaseResponseFloat32Array✘ ✘ 此参数指定一个用于接收以弧度为单位的相位响应值的输出数组。 如果 frequencyHz参数中的某个值不在 [0; sampleRate/2] 范围内, 其中sampleRate是sampleRate属性在AudioContext中的值, 则phaseResponse数组中相同索引处的对应值必须 为NaN。返回类型:undefined
1.13.4.
BiquadFilterOptions
这指定了构造
BiquadFilterNode
时使用的选项。
所有成员均为可选;如果
未指定,则使用通常的默认值构造
节点。
dictionary BiquadFilterOptions :AudioNodeOptions {BiquadFilterType type = "lowpass";float Q = 1;float detune = 0;float frequency = 350;float gain = 0; };
1.13.4.1.
字典 BiquadFilterOptions
成员
Q, 类型为 float,默认值为1-
Q所需的初始值。 detune, 类型为 float,默认值为0-
detune所需的初始值。 frequency, 类型为 float,默认值为350-
frequency所需的初始值。 gain, 类型为 float,默认值为0-
gain所需的初始值。 type, 类型为 BiquadFilterType,默认值为"lowpass"-
所需的滤波器初始类型。
1.13.5. 滤波器特性
可以通过多种方式实现
BiquadFilterNode
提供的滤波器类型,
各种方式可能具有截然不同的特性。本节中的公式
描述了符合规范的实现必须
实现的滤波器,因为这些公式决定了不同
滤波器类型的特性。它们受
音频 EQ Cookbook
中公式的启发。
BiquadFilterNode
使用以下传递函数处理音频:
$$
 H(z) = \frac{\frac{b_0}{a_0} + \frac{b_1}{a_0}z^{-1} + \frac{b_2}{a_0}z^{-2}}
                                          {1+\frac{a_1}{a_0}z^{-1}+\frac{a_2}{a_0}z^{-2}}
$$
这等价于以下时域方程:
$$
a_0 y(n) + a_1 y(n-1) + a_2 y(n-2) =
    b_0 x(n) + b_1 x(n-1) + b_2 x(n-2)
$$
滤波器的初始状态为 0。
注: 虽然固定滤波器是稳定的,但可以通过
对 AudioParam
进行自动化来创建
不稳定的双二阶滤波器。
开发者有责任对此进行管理。
注: 用户代理可以生成警告,通知用户 滤波器状态中出现了 NaN 值。这通常表示滤波器不稳定。
上述传递函数中的系数对于
每种节点类型都不同。计算这些系数需要以下中间变量,
它们基于
BiquadFilterNode
的
AudioParam
的 computedValue。
-
令 \(F_s\) 为此
AudioContext的sampleRate属性值。 -
令 \(f_0\) 为 computedFrequency 的值。
-
令 \(G\) 为
gainAudioParam的值。 -
令 \(Q\) 为
QAudioParam的值。 -
最后令
$$
\begin{align*}
    A &= 10^{\frac{G}{40}} \\
    \omega_0 &= 2\pi\frac{f_0}{F_s} \\
    \alpha_Q &= \frac{\sin\omega_0}{2Q} \\
    \alpha_{Q_{dB}} &= \frac{\sin\omega_0}{2 \cdot 10^{Q/20}} \\
    S &= 1 \\
    \alpha_S &= \frac{\sin\omega_0}{2}\sqrt{\left(A+\frac{1}{A}\right)\left(\frac{1}{S}-1\right)+2}
\end{align*}
$$
每种滤波器类型的六个系数 (\(b_0, b_1, b_2, a_0, a_1, a_2\))如下:
- "
lowpass" -
$$ \begin{align*} b_0 &= \frac{1 - \cos\omega_0}{2} \\ b_1 &= 1 - \cos\omega_0 \\ b_2 &= \frac{1 - \cos\omega_0}{2} \\ a_0 &= 1 + \alpha_{Q_{dB}} \\ a_1 &= -2 \cos\omega_0 \\ a_2 &= 1 - \alpha_{Q_{dB}} \end{align*} $$ - "
highpass" -
$$ \begin{align*} b_0 &= \frac{1 + \cos\omega_0}{2} \\ b_1 &= -(1 + \cos\omega_0) \\ b_2 &= \frac{1 + \cos\omega_0}{2} \\ a_0 &= 1 + \alpha_{Q_{dB}} \\ a_1 &= -2 \cos\omega_0 \\ a_2 &= 1 - \alpha_{Q_{dB}} \end{align*} $$ - "
bandpass" -
$$ \begin{align*} b_0 &= \alpha_Q \\ b_1 &= 0 \\ b_2 &= -\alpha_Q \\ a_0 &= 1 + \alpha_Q \\ a_1 &= -2 \cos\omega_0 \\ a_2 &= 1 - \alpha_Q \end{align*} $$ - "
notch" -
$$ \begin{align*} b_0 &= 1 \\ b_1 &= -2\cos\omega_0 \\ b_2 &= 1 \\ a_0 &= 1 + \alpha_Q \\ a_1 &= -2 \cos\omega_0 \\ a_2 &= 1 - \alpha_Q \end{align*} $$ - "
allpass" -
$$ \begin{align*} b_0 &= 1 - \alpha_Q \\ b_1 &= -2\cos\omega_0 \\ b_2 &= 1 + \alpha_Q \\ a_0 &= 1 + \alpha_Q \\ a_1 &= -2 \cos\omega_0 \\ a_2 &= 1 - \alpha_Q \end{align*} $$ - "
peaking" -
$$ \begin{align*} b_0 &= 1 + \alpha_Q\, A \\ b_1 &= -2\cos\omega_0 \\ b_2 &= 1 - \alpha_Q\,A \\ a_0 &= 1 + \frac{\alpha_Q}{A} \\ a_1 &= -2 \cos\omega_0 \\ a_2 &= 1 - \frac{\alpha_Q}{A} \end{align*} $$ - "
lowshelf" -
$$ \begin{align*} b_0 &= A \left[ (A+1) - (A-1) \cos\omega_0 + 2 \alpha_S \sqrt{A})\right] \\ b_1 &= 2 A \left[ (A-1) - (A+1) \cos\omega_0 )\right] \\ b_2 &= A \left[ (A+1) - (A-1) \cos\omega_0 - 2 \alpha_S \sqrt{A}) \right] \\ a_0 &= (A+1) + (A-1) \cos\omega_0 + 2 \alpha_S \sqrt{A} \\ a_1 &= -2 \left[ (A-1) + (A+1) \cos\omega_0\right] \\ a_2 &= (A+1) + (A-1) \cos\omega_0 - 2 \alpha_S \sqrt{A}) \end{align*} $$ - "
highshelf" -
$$
    \begin{align*}
        b_0 &= A\left[ (A+1) + (A-1)\cos\omega_0 + 2\alpha_S\sqrt{A} )\right] \\
        b_1 &= -2A\left[ (A-1) + (A+1)\cos\omega_0 )\right] \\
        b_2 &= A\left[ (A+1) + (A-1)\cos\omega_0 - 2\alpha_S\sqrt{A} )\right] \\
        a_0 &= (A+1) - (A-1)\cos\omega_0 + 2\alpha_S\sqrt{A} \\
        a_1 &= 2\left[ (A-1) - (A+1)\cos\omega_0\right] \\
        a_2 &= (A+1) - (A-1)\cos\omega_0 - 2\alpha_S\sqrt{A}
    \end{align*}
$$
1.14.
ChannelMergerNode
接口
ChannelMergerNode
用于更高级的
应用程序,并且通常会与
ChannelSplitterNode
结合使用。
| 属性 | 值 | 备注 |
|---|---|---|
numberOfInputs
| 参见备注 | 默认为 6,但由 ChannelMergerOptions、numberOfInputs
或 createChannelMerger
指定的值决定。
|
numberOfOutputs
| 1 | |
channelCount
| 1 | 具有 channelCount 约束 |
channelCountMode
| "explicit"
| 具有 channelCountMode 约束 |
channelInterpretation
| "speakers"
| |
| 尾部时间 | 否 |
此接口表示一个 AudioNode,
用于将多个音频流的声道合并为单个音频
流。它具有可变数量的输入(默认为 6),但并非
所有输入都需要连接。它只有一个输出;当任意
输入正在主动处理时,该输出的音频
流具有与输入数量相同的声道数。如果没有任何输入正在
主动
处理,则输出为单声道静音。
要将多个输入合并为一个流,每个输入都根据指定的混音规则 降混为一个声道(单声道)。未连接的输入在 输出中仍算作一个静音声道。更改输入流不会影响 输出声道的顺序。
ChannelMergerNode
有
两个已连接的立体声输入,则第一个和第二个输入在合并前分别
降混为单声道。输出将是一个
6 声道流,其中前两个声道由
前两个(降混后的)输入填充,其余声道保持静音。
此外,ChannelMergerNode
还可以用于按照一定顺序排列
多个音频流,以供 5.1 环绕声等多声道
扬声器阵列使用。合并器不会
解释声道的含义(例如左、右等),而只是
按照输入顺序组合声道。

[Exposed =Window ]interface ChannelMergerNode :AudioNode {constructor (BaseAudioContext ,context optional ChannelMergerOptions = {}); };options
1.14.1. 构造函数
ChannelMergerNode(context, options)-
当使用
BaseAudioContextc 和 选项对象 option 调用构造函数时,用户代理必须以 context 和 options 作为参数, 初始化 AudioNode this。ChannelMergerNode.constructor() 方法的参数。 参数 类型 可为空 可选 说明 contextBaseAudioContext✘ ✘ 此新 ChannelMergerNode将关联的BaseAudioContext。optionsChannelMergerOptions✘ ✔ 此 ChannelMergerNode的可选初始参数值。
1.14.2.
ChannelMergerOptions
dictionary ChannelMergerOptions :AudioNodeOptions {unsigned long numberOfInputs = 6; };
1.14.2.1.
字典 ChannelMergerOptions
成员
numberOfInputs, 类型为 unsigned long,默认值为6-
ChannelMergerNode的输入数量。 有关此值的约束,请参阅createChannelMerger()。
1.15.
ChannelSplitterNode
接口
ChannelSplitterNode
用于更高级的
应用程序,并且通常会与
ChannelMergerNode
结合使用。
| 属性 | 值 | 备注 |
|---|---|---|
numberOfInputs
| 1 | |
numberOfOutputs
| 参见备注 | 默认为 6,但除此之外由 ChannelSplitterOptions.numberOfOutputs
或 createChannelSplitter
指定的值,或用于 constructor
的 ChannelSplitterOptions
字典的 numberOfOutputs
成员决定。
|
channelCount
| numberOfOutputs
| 具有 channelCount 约束 |
channelCountMode
| "explicit"
| 具有 channelCountMode 约束 |
channelInterpretation
| "discrete"
| 具有 channelInterpretation 约束 |
| 尾部时间 | 否 |
此接口表示一个 AudioNode,
用于访问路由
图中音频流的各个声道。它只有一个输入,以及若干“活动”输出,
活动输出数量等于输入音频流中的声道数量。例如,
如果将立体声输入连接到
ChannelSplitterNode,
则活动
输出的数量为两个(一个来自左声道,一个来自
右声道)。始终共有 N 个输出(由
AudioContext
方法 createChannelSplitter()
的 numberOfOutputs 参数决定)。
如果未提供此值,默认数量为 6。任何非
“活动”的输出都将输出静音,并且通常不会
连接到任何对象。
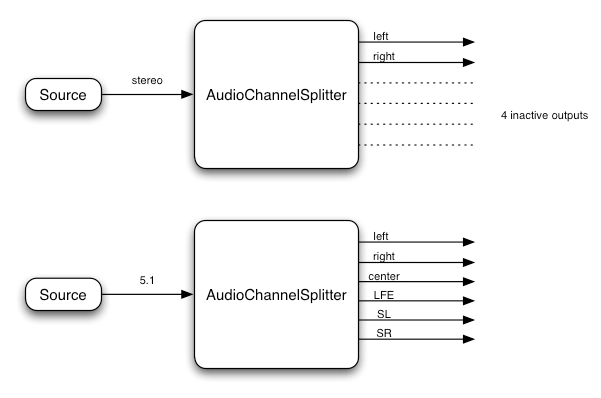
ChannelSplitterNode
的一种用途是进行
“矩阵混音”,以便单独控制每个声道的增益。
[Exposed =Window ]interface ChannelSplitterNode :AudioNode {constructor (BaseAudioContext ,context optional ChannelSplitterOptions = {}); };options
1.15.1. 构造函数
ChannelSplitterNode(context, options)-
当使用
BaseAudioContextc 和 选项对象 option 调用构造函数时,用户代理必须以 context 和 options 作为参数, 初始化 AudioNode this。ChannelSplitterNode.constructor() 方法的参数。 参数 类型 可为空 可选 说明 contextBaseAudioContext✘ ✘ 此新 ChannelSplitterNode将关联的BaseAudioContext。optionsChannelSplitterOptions✘ ✔ 此 ChannelSplitterNode的可选初始参数值。
1.15.2.
ChannelSplitterOptions
dictionary ChannelSplitterOptions :AudioNodeOptions {unsigned long numberOfOutputs = 6; };
1.15.2.1.
字典 ChannelSplitterOptions
成员
numberOfOutputs, 类型为 unsigned long,默认值为6-
ChannelSplitterNode的输出数量。 有关此值的约束,请参阅createChannelSplitter()。
1.16.
ConstantSourceNode
接口
此接口表示一个恒定音频源,其输出
名义上为恒定值。它通常可以用作恒定源节点,
并且可以通过自动化其
offset
或将另一个节点连接到它,而像一个可构造的
AudioParam
一样使用。
此节点的单个输出由一个声道(单声道)组成。
| 属性 | 值 | 备注 |
|---|---|---|
numberOfInputs
| 0 | |
numberOfOutputs
| 1 | |
channelCount
| 2 | |
channelCountMode
| "max"
| |
channelInterpretation
| "speakers"
| |
| 尾部时间 | 否 |
[Exposed =Window ]interface ConstantSourceNode :AudioScheduledSourceNode {constructor (BaseAudioContext ,context optional ConstantSourceOptions = {});options readonly attribute AudioParam offset ; };
1.16.1. 构造函数
ConstantSourceNode(context, options)-
当使用
BaseAudioContextc 和 选项对象 option 调用构造函数时,用户代理必须以 context 和 options 作为参数, 初始化 AudioNode this。ConstantSourceNode.constructor() 方法的参数。 参数 类型 可为空 可选 说明 contextBaseAudioContext✘ ✘ 此新 ConstantSourceNode将关联的BaseAudioContext。optionsConstantSourceOptions✘ ✔ 此 ConstantSourceNode的可选初始参数值。
1.16.2. 属性
offset, 类型为 AudioParam, 只读-
源的恒定值。
参数 值 备注 defaultValue1 minValue最小负单精度浮点数 约 -3.4028235e38 maxValue最大正单精度浮点数 约 3.4028235e38 automationRate" a-rate"
1.16.3.
ConstantSourceOptions
这指定了构造
ConstantSourceNode
时使用的选项。
所有成员均为可选;
如果未指定,则使用通常的默认值构造
节点。
dictionary ConstantSourceOptions {float offset = 1; };
1.16.3.1.
字典 ConstantSourceOptions
成员
offset, 类型为 float,默认值为1-
此节点的
offsetAudioParam 的初始值。
1.17.
ConvolverNode
接口
此接口表示一个处理节点,它在给定脉冲响应的情况下应用 线性卷积效果。
| 属性 | 值 | 备注 |
|---|---|---|
numberOfInputs
| 1 | |
numberOfOutputs
| 1 | |
channelCount
| 2 | 具有 channelCount 约束 |
channelCountMode
| "clamped-max"
| 具有 channelCountMode 约束 |
channelInterpretation
| "speakers"
| |
| 尾部时间 | 是 | 在输入为零时,会在 buffer
的持续时间内继续输出非静音音频。
|
此节点的输入可以是单声道(1 个声道)或立体声(2 个 声道),并且不能增加。来自具有更多 声道的节点的连接将被适当地降混。
此节点具有 channelCount 约束和 channelCountMode 约束。这些约束确保 节点的输入为单声道或立体声。
[Exposed =Window ]interface ConvolverNode :AudioNode {constructor (BaseAudioContext ,context optional ConvolverOptions = {});options attribute AudioBuffer ?buffer ;attribute boolean normalize ; };
1.17.1. 构造函数
ConvolverNode(context, options)-
当使用
BaseAudioContextcontext 和 选项对象 options 调用构造函数时,执行以下步骤:-
将属性
normalize设置为disableNormalization值的反值。 -
如果
buffer存在,则将buffer属性设置为其值。注: 这意味着 buffer 将根据
normalize属性的值进行归一化。 -
令 o 为新的
AudioNodeOptions字典。 -
如果
channelCount在 options 中存在,则将 o 上的channelCount设置为相同的值。 -
如果
channelCountMode在 options 中存在,则将 o 上的channelCountMode设置为相同的值。 -
如果
channelInterpretation在 options 中存在,则将 o 上的channelInterpretation设置为相同的值。 -
以 c 和 o 作为参数, 初始化 AudioNode this。
ConvolverNode.constructor() 方法的参数。 参数 类型 可为空 可选 说明 contextBaseAudioContext✘ ✘ 此新 ConvolverNode将关联的BaseAudioContext。optionsConvolverOptions✘ ✔ 此 ConvolverNode的可选初始参数值。 -
1.17.2. 属性
buffer, 类型为 AudioBuffer, 可为空-
设置此属性时,
buffer和normalize属性的状态将用于 配置ConvolverNode, 使用给定归一化方式处理此 脉冲响应。此属性的初始值为 null。设置buffer 属性时,同步执行以下步骤:-
如果 buffer 的
声道数量不是 1、2、4,或者 buffer 的采样率与其关联BaseAudioContext的采样率不同,则 必须抛出NotSupportedError。 -
获取
AudioBuffer的内容。
注: 如果将
buffer设置为新的 buffer,音频可能会出现故障。如果不希望出现这种情况, 建议创建一个新的ConvolverNode来 替换旧节点,并可能在两者之间进行交叉淡化。注:
ConvolverNode仅在 输入只有一个声道且buffer也只有一个声道的情况下才产生单声道输出。 在所有其他情况下, 输出均为立体声。特别是,当buffer有四个声道且有两个输入声道时,ConvolverNode会执行矩阵“真”立体声 卷积。有关规范性信息,请参阅 声道 配置图 -
normalize, 类型为 boolean-
控制在设置
buffer属性时,来自 buffer 的脉冲响应是否会按等功率归一化进行缩放。 其默认值为true,以便卷积器加载各种不同的脉冲响应时 获得更均匀的输出 电平。如果normalize设置为false,则卷积将在 不对脉冲响应进行预处理/缩放的情况下渲染。 此值的更改要到下一次设置buffer属性时才会生效。如果在设置
buffer属性时,normalize属性为 false,则ConvolverNode将根据buffer中包含的确切脉冲响应执行线性 卷积。否则,如果在设置
buffer属性时,normalize属性为 true,则ConvolverNode将首先对buffer中包含的音频数据执行缩放后的 RMS 功率分析,以根据以下算法计算 normalizationScale:function calculateNormalizationScale( buffer) { const GainCalibration= 0.00125 ; const GainCalibrationSampleRate= 44100 ; const MinPower= 0.000125 ; // 按 RMS 功率归一化。 const numberOfChannels= buffer. numberOfChannels; const length= buffer. length; let power= 0 ; for ( let i= 0 ; i< numberOfChannels; i++ ) { let channelPower= 0 ; const channelData= buffer. getChannelData( i); for ( let j= 0 ; j< length; j++ ) { const sample= channelData[ j]; channelPower+= sample* sample; } power+= channelPower; } power= Math. sqrt( power/ ( numberOfChannels* length)); // 防止意外过载。 if ( ! isFinite( power) || isNaN( power) || power< MinPower) power= MinPower; let scale= 1 / power; // 校准以使感知音量与未处理时相同。 scale*= GainCalibration; // 缩放取决于采样率。 if ( buffer. sampleRate) scale*= GainCalibrationSampleRate/ buffer. sampleRate; // 真立体声补偿。 if ( numberOfChannels== 4 ) scale*= 0.5 ; return scale; } 随后在处理期间,ConvolverNode 会取此 计算得到的 normalizationScale 值,并将其乘以 使用脉冲响应(由
buffer表示)处理输入所产生的线性卷积结果, 以生成最终输出。或者也可以使用任何 数学上等价的操作,例如 预先将输入乘以 normalizationScale,或者 预先将某个版本的脉冲响应乘以 normalizationScale。
1.17.3.
ConvolverOptions
这指定了构造
ConvolverNode
时使用的选项。
所有成员均为可选;如果未
指定,则使用通常的默认值构造节点。
dictionary ConvolverOptions :AudioNodeOptions {AudioBuffer ?buffer ;boolean disableNormalization =false ; };
1.17.3.1.
字典 ConvolverOptions
成员
buffer, 类型为 AudioBuffer, 可为空-
ConvolverNode所需的 buffer。 此 buffer 将根据disableNormalization的值进行归一化。 disableNormalization, 类型为 boolean,默认值为false-
ConvolverNode的normalize属性所需初始值的反值。
1.17.4. 输入、脉冲响应和输出的声道配置
实现必须支持
ConvolverNode
中以下允许的脉冲响应声道配置,
以便使用 1 或 2 个输入声道实现各种混响效果。
如下图所示,单声道卷积作用于单声道音频输入,使用
单声道脉冲响应,并生成单声道输出。图中的其余
图像说明了所支持的单声道和
立体声播放情况,其中输入的声道数量为 1 或 2,而 buffer
中的声道数量为 1、2 或 4。
需要更复杂且任意矩阵处理的开发者可以使用
ChannelSplitterNode、
多个单声道
ConvolverNode
和
ChannelMergerNode。
如果此节点未主动处理,则输出为单声道 静音。
注: 下图显示了主动 处理时的输出。
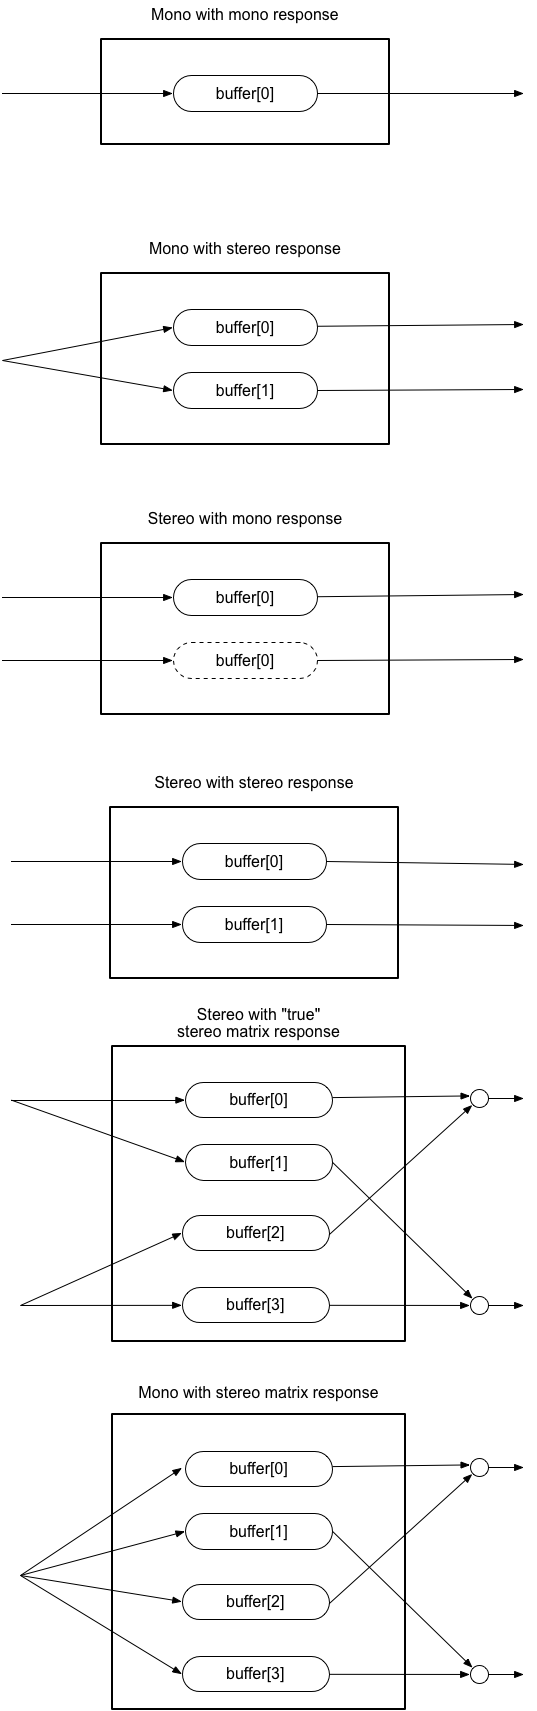
ConvolverNode
时支持的输入和输出声道
数量组合的图形表示。
1.18.
DelayNode
接口
延迟线是音频应用程序中的基本构建块。
此接口是一个具有单个
输入和单个输出的 AudioNode。
| 属性 | 值 | 备注 |
|---|---|---|
numberOfInputs
| 1 | |
numberOfOutputs
| 1 | |
channelCount
| 2 | |
channelCountMode
| "max"
| |
channelInterpretation
| "speakers"
| |
| 尾部时间 | 是 | 在输入为零时,会继续输出非静音音频,最长可达节点的 maxDelayTime。
|
输出的声道数量始终等于 输入的声道数量。
它将传入的音频信号延迟一定时间。
具体而言,在每个时间 t,给定输入信号
input(t)、延迟时间 delayTime(t) 和输出信号
output(t),输出为 output(t) = input(t -
delayTime(t))。默认 delayTime 为 0 秒
(无延迟)。
当 DelayNode
输入中的声道数量发生变化
(从而输出声道数量也发生变化)时,节点内部状态中可能存在
尚未由节点输出的延迟音频采样。如果这些采样
先前是在不同的声道数量下接收的,则在与
新接收的输入合并之前必须进行升混或降混,以便所有内部
延迟线混音都使用单一的当前声道
布局。
注: 根据定义,DelayNode
会引入等于延迟时间量的音频处理
延迟。
[Exposed =Window ]interface DelayNode :AudioNode {constructor (BaseAudioContext ,context optional DelayOptions = {});options readonly attribute AudioParam delayTime ; };
1.18.1. 构造函数
DelayNode(context, options)-
当使用
BaseAudioContextc 和 选项对象 option 调用构造函数时,用户代理必须以 context 和 options 作为参数, 初始化 AudioNode this。DelayNode.constructor() 方法的参数。 参数 类型 可为空 可选 说明 contextBaseAudioContext✘ ✘ 此新 DelayNode将关联的BaseAudioContext。optionsDelayOptions✘ ✔ 此 DelayNode的可选初始参数值。
1.18.2. 属性
delayTime, 类型为 AudioParam, 只读-
一个
AudioParam对象,表示要应用的 延迟量(以秒为单位)。其默认value为 0(无延迟)。最小值为 0, 最大值由maxDelayTime参数决定,该参数来自AudioContext方法createDelay()或DelayOptions字典中用于constructor的maxDelayTime成员。如果
DelayNode是循环的一部分, 则delayTime属性的值 会被钳制到至少一个渲染量子。参数 值 备注 defaultValue0 minValue0 maxValuemaxDelayTimeautomationRate" a-rate"
1.18.3.
DelayOptions
这指定了构造
DelayNode
时使用的选项。
所有成员均为可选;如果未
给出,则使用通常的默认值构造节点。
dictionary DelayOptions :AudioNodeOptions {double maxDelayTime = 1;double delayTime = 0; };
1.18.3.1.
字典 DelayOptions
成员
delayTime, 类型为 double,默认值为0-
节点的初始延迟时间。
maxDelayTime, 类型为 double,默认值为1-
节点的最大延迟时间。有关约束,请参阅
createDelay(maxDelayTime)。
1.18.4. 处理
DelayNode
具有一个内部缓冲区,用于保存 delayTime
秒的音频。
DelayNode 的处理
分为两部分:写入
延迟线,以及从延迟线读取。这通过两个内部
AudioNode
完成(作者无法访问它们,它们仅用于便于
描述节点的内部工作方式)。二者都从
DelayNode
创建。
为
DelayNode
创建一个 DelayWriter
意味着创建一个
与 AudioNode
具有相同接口的对象,
并将输入音频写入
DelayNode
的内部缓冲区。它
与创建它的
DelayNode
具有相同的输入连接。
为
DelayNode
创建一个 DelayReader
意味着创建一个
与 AudioNode
具有相同接口的对象,
并且可以从
DelayNode
的内部缓冲区读取音频
数据。它连接到与创建它的
DelayNode
相同的
AudioNode。
DelayReader
是一个源节点。
处理输入缓冲区时,DelayWriter 必须将音频写入
DelayNode
的内部缓冲区。
生成输出缓冲区时,DelayReader 必须准确产生
在 delayTime
秒前写入相应 DelayWriter
的音频。
注: 这意味着声道数量的变化会在 延迟时间 经过后体现出来。
1.19.
DynamicsCompressorNode
接口
DynamicsCompressorNode
是一个
AudioNode
处理器,实现动态
压缩效果。
动态压缩在音乐制作和 游戏音频中非常常用。它会降低信号中最响部分的音量, 并提高最轻部分的音量。总体上,可以获得更响亮、 更丰富、更饱满的声音。它在游戏和音乐应用程序中尤其重要, 因为这些应用程序会同时播放大量单独的 声音,需要控制整体信号电平, 并帮助避免向扬声器输出的音频发生削波(失真)。
| 属性 | 值 | 备注 |
|---|---|---|
numberOfInputs
| 1 | |
numberOfOutputs
| 1 | |
channelCount
| 2 | 具有 channelCount 约束 |
channelCountMode
| "clamped-max"
| 具有 channelCountMode 约束 |
channelInterpretation
| "speakers"
| |
| 尾部时间 | 是 | 此节点具有尾部时间,因此由于预读延迟, 此节点在输入为零时仍会继续输出非静音音频。 |
[Exposed =Window ]interface DynamicsCompressorNode :AudioNode {constructor (BaseAudioContext ,context optional DynamicsCompressorOptions = {});options readonly attribute AudioParam threshold ;readonly attribute AudioParam knee ;readonly attribute AudioParam ratio ;readonly attribute float reduction ;readonly attribute AudioParam attack ;readonly attribute AudioParam release ; };
1.19.1. 构造函数
DynamicsCompressorNode(context, options)-
当使用
BaseAudioContextc 和 选项对象 option 调用构造函数时,用户代理必须以 context 和 options 作为参数, 初始化 AudioNode this。令
[[internal reduction]]为 this 上的私有槽,用于保存以 分贝为单位的浮点数。将[[internal reduction]]设置为 0.0。DynamicsCompressorNode.constructor() 方法的参数。 参数 类型 可为空 可选 说明 contextBaseAudioContext✘ ✘ 此新 DynamicsCompressorNode将关联的BaseAudioContext。optionsDynamicsCompressorOptions✘ ✔ 此 DynamicsCompressorNode的可选初始参数值。
1.19.2. 属性
attack, 类型为 AudioParam, 只读-
将增益降低 10dB 所需的时间(以秒为单位)。
参数 值 备注 defaultValue.003 minValue0 maxValue1 automationRate" k-rate"具有 自动化速率 约束 knee, 类型为 AudioParam,只读-
一个分贝值,表示高于阈值且曲线 平滑过渡到“ratio”部分的范围。
参数 值 备注 defaultValue30 minValue0 maxValue40 automationRate" k-rate"具有 自动化速率 约束 ratio, 类型为 AudioParam, 只读-
输出变化 1 dB 时对应的输入 dB 变化量。
参数 值 备注 defaultValue12 minValue1 maxValue20 automationRate" k-rate"具有 自动化速率 约束 reduction, 类型为 float,只读-
用于计量的只读分贝值,表示压缩器当前 对信号施加的增益衰减量。如果没有输入信号, 该值为 0(无增益 衰减)。读取此属性时,返回 私有槽
[[internal reduction]]的值。 release, 类型为 AudioParam, 只读-
将增益提高 10dB 所需的时间(以秒为单位)。
参数 值 备注 defaultValue.25 minValue0 maxValue1 automationRate" k-rate"具有 自动化速率 约束 threshold, 类型为 AudioParam, 只读-
超过该值后压缩开始生效的分贝值。
参数 值 备注 defaultValue-24 minValue-100 maxValue0 automationRate" k-rate"具有 自动化速率 约束
1.19.3.
DynamicsCompressorOptions
这指定了构造
DynamicsCompressorNode
时使用的选项。
所有成员均为
可选;如果未指定,则使用通常的默认值
构造节点。
dictionary DynamicsCompressorOptions :AudioNodeOptions {float attack = 0.003;float knee = 30;float ratio = 12;float release = 0.25;float threshold = -24; };
1.19.3.1.
字典 DynamicsCompressorOptions
成员
attack, 类型为 float,默认值为0.003-
attackAudioParam 的初始值。 knee, 类型为 float,默认值为30-
kneeAudioParam 的初始值。 ratio, 类型为 float,默认值为12-
ratioAudioParam 的初始值。 release, 类型为 float,默认值为0.25-
releaseAudioParam 的初始值。 threshold, 类型为 float,默认值为-24-
thresholdAudioParam 的初始值。
1.19.4. 处理
动态压缩可以通过多种方式实现。
DynamicsCompressorNode
实现了一个具有
以下特性的动态处理器:
-
固定预读(这意味着
DynamicsCompressorNode会向信号链 添加固定延迟)。 -
可配置的起音速度、释音速度、阈值、拐点 硬度和压缩比。
-
不支持侧链。
-
增益衰减通过
DynamicsCompressorNode上的reduction属性 报告。 -
压缩曲线分为三个部分:
-
第一部分是恒等函数:\(f(x) = x\)。
-
第二部分是软拐点部分,它必须是 单调递增函数。
-
第三部分是线性函数:\(f(x) = \frac{1}{ratio} \cdot x \)。
此曲线必须连续且分段可微, 并根据输入 电平对应一个目标输出电平。
-
从图形上看,这样的曲线大致如下:

在内部,DynamicsCompressorNode
使用其他 AudioNode
的组合以及一个特殊
算法来描述,以计算增益衰减值。
内部使用以下 AudioNode
图,其中
input 和 output 分别是输入和输出
AudioNode,
context 是此 DynamicsCompressorNode
的
BaseAudioContext,
以及一个新类 EnvelopeFollower,它实例化一个
行为类似于 AudioNode
的特殊对象,
如下所述:
const delay = new DelayNode(context, {delayTime: 0.006});
const gain = new GainNode(context);
const compression = new EnvelopeFollower();

input.connect(delay).connect(gain).connect(output);
input.connect(compression).connect(gain.gain);

DynamicsCompressorNode
处理算法一部分使用的内部 AudioNode
图。
注: 这实现了预延迟以及 衰减增益的应用。
以下算法描述了 EnvelopeFollower 对象执行的处理, 该处理应用于输入 信号以产生增益衰减值。一个 EnvelopeFollower 具有两个 保存浮点 值的槽。这些值会在此算法的多次调用之间持续存在。
-
令
[[detector average]]为 一个浮点 数,初始化为 0.0。 -
令
[[compressor gain]]为一个 浮点 数,初始化为 1.0。
-
令 attack 和 release 分别具有
attack和release在处理时采样的值 (它们是 k-rate 参数),再乘以此DynamicsCompressorNode所关联的BaseAudioContext的采样率。 -
令 detector average 为槽
[[detector average]]的值。 -
令 compressor gain 为槽
[[compressor gain]]的值。 -
对于要处理的渲染量子的每个 采样 input,执行以下步骤:
-
如果 input 的绝对值小于 0.0001,则令 attenuation 为 1.0。否则,令 shaped input 为将压缩曲线应用于 input 绝对值所得的值。令 attenuation 为 shaped input 除以 input 的绝对值。
-
如果 attenuation 大于 compressor gain,则令 releasing 为
true, 否则为false。 -
令 detector rate 为将 检测器曲线应用于 attenuation 所得的结果。
-
从 attenuation 中减去 detector average,并将结果乘以 detector rate。将这个新结果加到 detector average。
-
将 detector average 钳制到最大值 1.0。
-
令 envelope rate 为基于 attack 和 release 的值 计算包络速率所得的结果。
-
如果 releasing 为
true,则将 compressor gain 设置为 compressor gain 与 envelope rate 的乘积,并 钳制到最大值 1.0。 -
否则,如果 releasing 为
false,令 gain increment 为 detector average 减去 compressor gain。将 gain increment 乘以 envelope rate,并将结果 加到 compressor gain。 -
计算 reduction gain,令其为 compressor gain 乘以计算 补偿增益的返回值。
-
计算 metering gain,令其为 reduction gain 转换为 分贝后的值。
-
-
将
[[compressor gain]]设置为 compressor gain。 -
将
[[detector average]]设置为 detector average。 -
原子地将 内部槽
[[internal reduction]]设置为 metering gain 的值。注: 此步骤使计量增益 每个块更新一次,即在 块处理结束时更新。
补偿增益是一个固定增益级,只取决于压缩器的 ratio、knee 和 threshold 参数,而不取决于 输入信号。这里的目的是提高压缩器的输出电平, 使其与输入电平相当。
-
令 full range gain 为将 压缩曲线应用于值 1.0 所返回的值。
-
令 full range makeup gain 为 full range gain 的倒数。
-
返回 full range makeup gain 的 0.6 次幂结果。
-
包络速率必须根据 compressor gain 与 detector average 的比值计算。
注: 在起音时,此数值小于 或等于 1;在 释音时,此数值严格大于 1。
-
起音曲线必须是在范围 \([0, 1]\) 内连续、单调递增的 函数。此曲线的形状可以由
attack控制。 -
释音曲线必须是连续、单调 递减且始终大于 1 的函数。此曲线的形状可以由
release控制。
此操作返回将该函数应用于 compressor gain 与 detector average 的比值所得的值。
将检测器 曲线应用于 起音或释音时的变化速率,可以实现 自适应释音。它是一个必须遵守 以下约束的函数:
-
函数的输出必须位于 \([0,1]\) 范围内。
-
函数必须单调递增且连续。
注: 例如,允许压缩器执行 自适应释音,即压缩越强时 释音越快,或者采用 不同形状的起音和释音曲线。
-
令 threshold 和 knee 分别具有
threshold和knee的值, 将它们转换为线性 单位,并在此 块处理时采样(作为 k-rate 参数)。 -
令 knee end threshold 为此 和转换为线性 单位后的值。
-
在达到线性 threshold 值之前,此函数是恒等函数(即 \(f(x) = x\))。
-
从 threshold 到 knee end threshold,用户代理可以选择 曲线形状。整个函数必须单调 递增且连续。
注: 如果 knee 为 0,则
DynamicsCompressorNode称为硬拐点压缩器。 -
在 threshold 和软拐点之后,此函数基于 ratio 呈线性(即 \(f(x) = \frac{1}{ratio} \cdot x \))。
-
如果 \(v\) 等于零,则返回 -1000。
-
否则,返回 \( 20 \, \log_{10}{v} \)。
1.20.
GainNode
接口
改变音频信号的增益是音频应用程序中的基本操作。此
接口是一个具有单个输入和
单个输出的 AudioNode:
| 属性 | 值 | 备注 |
|---|---|---|
numberOfInputs
| 1 | |
numberOfOutputs
| 1 | |
channelCount
| 2 | |
channelCountMode
| "max"
| |
channelInterpretation
| "speakers"
| |
| 尾部时间 | 否 |
GainNode
输入数据的每个声道中的每个采样都必须乘以
gain
AudioParam
的 computedValue。
[Exposed =Window ]interface GainNode :AudioNode {constructor (BaseAudioContext ,context optional GainOptions = {});options readonly attribute AudioParam gain ; };
1.20.1. 构造函数
GainNode(context, options)-
当使用
BaseAudioContextc 和 选项对象 option 调用构造函数时,用户代理必须以 context 和 options 作为参数, 初始化 AudioNode this。GainNode.constructor() 方法的参数。 参数 类型 可为空 可选 说明 contextBaseAudioContext✘ ✘ 此新 GainNode将关联的BaseAudioContext。optionsGainOptions✘ ✔ 此 GainNode的可选初始参数值。
1.20.2. 属性
gain, 类型为 AudioParam,只读-
表示要应用的增益量。
参数 值 备注 defaultValue1 minValue最小负单精度浮点数 约 -3.4028235e38 maxValue最大正单精度浮点数 约 3.4028235e38 automationRate" a-rate"
1.20.3.
GainOptions
这指定了构造
GainNode
时使用的选项。所有
成员均为可选;如果未
指定,则使用通常的默认值构造节点。
dictionary GainOptions :AudioNodeOptions {float gain = 1.0; };
1.20.3.1.
字典 GainOptions
成员
gain, 类型为 float,默认值为1.0-
gainAudioParam 的初始增益值。
1.21.
IIRFilterNode
接口
IIRFilterNode
是一个 AudioNode
处理器,实现通用的 IIR
滤波器。通常,最好
使用多个 BiquadFilterNode
来实现
高阶滤波器,原因如下:
-
通常对数值问题不那么敏感
-
滤波器参数可以自动化
-
可用于创建所有偶数阶 IIR 滤波器
但是,无法创建奇数阶滤波器,因此如果需要此类滤波器 或者不需要自动化,那么 IIR 滤波器可能 更合适。
IIR 滤波器一旦创建,其系数便无法更改。
| 属性 | 值 | 备注 |
|---|---|---|
numberOfInputs
| 1 | |
numberOfOutputs
| 1 | |
channelCount
| 2 | |
channelCountMode
| "max"
| |
channelInterpretation
| "speakers"
| |
| 尾部时间 | 是 | 在输入为零时仍会继续输出非静音音频。由于这是一个 IIR 滤波器, 滤波器会无限地产生非零输出,但在实践中,可以在经过某个有限 时间后、输出已经足够接近零时停止。实际时间取决于 滤波器系数。 |
输出的声道数量始终等于 输入的声道数量。
[Exposed =Window ]interface IIRFilterNode :AudioNode {constructor (BaseAudioContext ,context IIRFilterOptions );options undefined getFrequencyResponse (Float32Array ,frequencyHz Float32Array ,magResponse Float32Array ); };phaseResponse
1.21.1. 构造函数
IIRFilterNode(context, options)-
当使用
BaseAudioContextc 和 选项对象 option 调用构造函数时,用户代理必须以 context 和 options 作为参数, 初始化 AudioNode this。IIRFilterNode.constructor() 方法的参数。 参数 类型 可为空 可选 说明 contextBaseAudioContext✘ ✘ 此新 IIRFilterNode将关联的BaseAudioContext。optionsIIRFilterOptions✘ ✘ 此 IIRFilterNode的初始参数值。
1.21.2. 方法
getFrequencyResponse(frequencyHz, magResponse, phaseResponse)-
给定当前滤波器参数 设置,同步计算 指定频率的频率响应。这三个参数必须是 长度相同的
Float32Array, 否则必须抛出InvalidAccessError。IIRFilterNode.getFrequencyResponse() 方法的参数。 参数 类型 可为空 可选 说明 frequencyHzFloat32Array✘ ✘ 此参数指定一个频率数组,以 Hz 为单位,将在这些频率处计算响应值。 magResponseFloat32Array✘ ✘ 此参数指定一个用于接收线性幅度响应值的输出数组。 如果 frequencyHz参数中的某个值不在 [0, sampleRate/2] 范围内, 其中sampleRate是sampleRate属性在AudioContext中的值, 则magResponse数组中相同索引处的对应值必须为NaN。phaseResponseFloat32Array✘ ✘ 此参数指定一个用于接收以弧度为单位的相位响应值的输出数组。 如果 frequencyHz参数中的某个值不在 [0; sampleRate/2] 范围内, 其中sampleRate是sampleRate属性在AudioContext中的值, 则phaseResponse数组中相同索引处的对应值必须 为NaN。返回类型:undefined
1.21.3.
IIRFilterOptions
IIRFilterOptions 字典用于指定
IIRFilterNode
的滤波器系数。
dictionary IIRFilterOptions :AudioNodeOptions {required sequence <double >feedforward ;required sequence <double >feedback ; };
1.21.3.1.
字典 IIRFilterOptions
成员
feedforward, 类型为 sequence<double>-
IIRFilterNode的前馈系数。 此成员是必需的。有关其他约束,请参阅createIIRFilter()的feedforward参数。 feedback, 类型为 sequence<double>-
IIRFilterNode的反馈系数。 此成员是必需的。有关其他约束,请参阅createIIRFilter()的feedback参数。
1.21.4. 滤波器定义
令 \(b_m\) 为由
createIIRFilter()
或用于 constructor
的 IIRFilterOptions
字典指定的 feedforward 系数,
\(a_n\) 为 feedback 系数。
则通用 IIR 滤波器的
传递函数为
$$
    H(z) = \frac{\sum_{m=0}^{M} b_m z^{-m}}{\sum_{n=0}^{N} a_n z^{-n}}
$$
其中 \(M + 1\) 是 \(b\) 数组的长度,而 \(N + 1\) 是
\(a\) 数组的长度。系数 \(a_0\) 必须不为 0(参见
createIIRFilter()
的 feedback 参数)。
至少一个 \(b_m\) 必须非零(参见
createIIRFilter()
的 feedforward 参数)。
等价地,时域方程为:
$$
    \sum_{k=0}^{N} a_k y(n-k) = \sum_{k=0}^{M} b_k x(n-k)
$$
滤波器的初始状态为全零状态。
注: 用户代理可以生成警告,通知用户 滤波器状态中出现了 NaN 值。这通常表示滤波器不稳定。
1.22.
MediaElementAudioSourceNode
接口
| 属性 | 值 | 备注 |
|---|---|---|
numberOfInputs
| 0 | |
numberOfOutputs
| 1 | |
| 尾部时间引用 | 否 |
输出的声道数量与
HTMLMediaElement
引用的媒体的声道数量相对应。
因此,更改媒体元素的
src 属性可以改变此节点输出的声道数量。
如果 HTMLMediaElement
的采样率与关联
AudioContext
的采样率不同,
则来自
HTMLMediaElement
的输出必须重新采样,以匹配上下文的
采样率。
给定一个
HTMLMediaElement,
可以使用 AudioContext
的
createMediaElementSource()
方法,或用于
constructor
的 MediaElementAudioSourceOptions
字典的 mediaElement
成员创建
MediaElementAudioSourceNode。
单个输出的声道数量等于作为
createMediaElementSource()
参数传入的 HTMLMediaElement
所引用音频的声道数量,
如果 HTMLMediaElement
没有音频,则为 1。
创建
MediaElementAudioSourceNode
后,HTMLMediaElement
必须保持完全相同的行为,
但渲染后的音频将不再被直接听到,
而是由于
MediaElementAudioSourceNode
通过路由图
连接后而被听到。因此,暂停、定位、音量、src
属性更改以及
HTMLMediaElement
的其他方面,必须像
未与 MediaElementAudioSourceNode
一起使用时那样正常运行。
const mediaElement= document. getElementById( 'mediaElementID' ); const sourceNode= context. createMediaElementSource( mediaElement); sourceNode. connect( filterNode);
[Exposed =Window ]interface MediaElementAudioSourceNode :AudioNode {constructor (AudioContext ,context MediaElementAudioSourceOptions ); [options SameObject ]readonly attribute HTMLMediaElement mediaElement ; };
1.22.1. 构造函数
MediaElementAudioSourceNode(context, options)-
-
以 context 和 options 作为参数, 初始化 AudioNode this。
MediaElementAudioSourceNode.constructor() 方法的参数。 参数 类型 可为空 可选 说明 contextAudioContext✘ ✘ 此新 MediaElementAudioSourceNode将关联的AudioContext。optionsMediaElementAudioSourceOptions✘ ✘ 此 MediaElementAudioSourceNode的初始参数值。 -
1.22.2. 属性
mediaElement, 类型为 HTMLMediaElement,只读-
构造此
MediaElementAudioSourceNode时使用的HTMLMediaElement。
1.22.3.
MediaElementAudioSourceOptions
这指定了构造
MediaElementAudioSourceNode
时使用的选项。
dictionary MediaElementAudioSourceOptions {required HTMLMediaElement mediaElement ; };
1.22.3.1.
字典 MediaElementAudioSourceOptions
成员
mediaElement, 类型为 HTMLMediaElement-
将被重新路由的媒体元素。必须指定此成员。
1.22.4. MediaElementAudioSourceNode 与跨源资源的安全性
HTMLMediaElement
允许播放跨源
资源。由于 Web Audio 允许检查
资源的内容(例如,使用 MediaElementAudioSourceNode
和
AudioWorkletNode
或 ScriptProcessorNode
来读取采样),如果来自某个源的脚本
检查来自另一个
源的资源内容,
就可能发生信息泄露。
为防止这种情况,一个 MediaElementAudioSourceNode
必须输出
静音,而不是
HTMLMediaElement
的正常输出,前提是它是使用一个
HTMLMediaElement
创建的,并且对该元素执行
fetch
算法 [FETCH] 将
该资源标记为
CORS-cross-origin。
1.23.
MediaStreamAudioDestinationNode
接口
此接口是一个音频目标,表示一个
MediaStream,
其中包含一个 MediaStreamTrack,
且其 kind 为 "audio"。此 MediaStream
会在节点创建时创建,并可通过
stream
属性访问。此流的使用方式类似于通过
getUserMedia()
获得的 MediaStream,
例如,可以使用 RTCPeerConnection(在
[webrtc] 中描述)的
addStream() 方法
将其发送给远程对等方。
| 属性 | 值 | 备注 |
|---|---|---|
numberOfInputs
| 1 | |
numberOfOutputs
| 0 | |
channelCount
| 2 | |
channelCountMode
| "explicit"
| |
channelInterpretation
| "speakers"
| |
| 尾部时间 | 否 |
输入的声道数量默认为 2(立体声)。
[Exposed =Window ]interface MediaStreamAudioDestinationNode :AudioNode {constructor (AudioContext ,context optional AudioNodeOptions = {});options readonly attribute MediaStream stream ; };
1.23.1. 构造函数
MediaStreamAudioDestinationNode(context, options)-
-
以 context 和 options 作为参数, 初始化 AudioNode this。
MediaStreamAudioDestinationNode.constructor() 方法的参数。 参数 类型 可为空 可选 说明 contextAudioContext✘ ✘ 此新 MediaStreamAudioDestinationNode将关联的BaseAudioContext。optionsAudioNodeOptions✘ ✔ 此 MediaStreamAudioDestinationNode的可选初始参数值。 -
1.23.2. 属性
stream, 类型为 MediaStream,只读-
一个
MediaStream, 包含一个MediaStreamTrack, 其声道数量与节点本身 相同,且其kind属性值为"audio"。
1.24.
MediaStreamAudioSourceNode
接口
此接口表示来自
MediaStream
的音频源。
| 属性 | 值 | 备注 |
|---|---|---|
numberOfInputs
| 0 | |
numberOfOutputs
| 1 | |
| 尾部时间引用 | 否 |
输出的声道数量与
MediaStreamTrack
的声道数量相对应。
当
MediaStreamTrack
结束时,此
AudioNode
输出一个声道的静音。
如果 MediaStreamTrack
的采样率与关联
AudioContext
的采样率不同,
则
MediaStreamTrack
的输出会重新采样,以匹配上下文的
采样率。
[Exposed =Window ]interface MediaStreamAudioSourceNode :AudioNode {constructor (AudioContext ,context MediaStreamAudioSourceOptions ); [options SameObject ]readonly attribute MediaStream mediaStream ; };
1.24.1. 构造函数
MediaStreamAudioSourceNode(context, options)-
-
如果
options的mediaStream成员未引用至少具有一个MediaStreamTrack且其kind属性值为"audio"的MediaStream, 则抛出InvalidStateError并中止这些步骤。否则,令 此流为 inputStream。 -
令 tracks 为 inputStream 中所有
MediaStreamTrack的列表,其中kind为"audio"。 -
使用代码单元 值序列上的排序,根据其
id属性对 tracks 中的元素排序。 -
以 context 和 options 作为参数, 初始化 AudioNode this。
-
在此
MediaStreamAudioSourceNode上设置内部槽[[input track]], 使其为 tracks 的第一个元素。这是作为此MediaStreamAudioSourceNode输入音频使用的轨道。
构造完成后,对传递给 构造函数的
MediaStream所做的任何更改都不会影响此AudioNode的底层输出。槽
[[input track]]仅用于保持对MediaStreamTrack的引用。注: 这意味着,当从传入此 构造函数的
MediaStream中移除MediaStreamAudioSourceNode构造函数所选择的轨道时,MediaStreamAudioSourceNode仍会从 同一轨道获取输入。注: 出于遗留原因,用于选择要 输出的轨道的行为是任意的。可以改用
MediaStreamTrackAudioSourceNode来明确指定使用哪个轨道作为输入。MediaStreamAudioSourceNode.constructor() 方法的参数。 参数 类型 可为空 可选 说明 contextAudioContext✘ ✘ 此新 MediaStreamAudioSourceNode将关联的AudioContext。optionsMediaStreamAudioSourceOptions✘ ✘ 此 MediaStreamAudioSourceNode的初始参数值。 -
1.24.2. 属性
mediaStream, 类型为 MediaStream,只读-
构造此
MediaStreamAudioSourceNode时使用的MediaStream。
1.24.3.
MediaStreamAudioSourceOptions
这指定了构造 MediaStreamAudioSourceNode
时使用的选项。
dictionary MediaStreamAudioSourceOptions {required MediaStream mediaStream ; };
1.24.3.1.
字典 MediaStreamAudioSourceOptions
成员
mediaStream, 类型为 MediaStream-
将作为源的媒体流。必须指定此成员。
1.25.
MediaStreamTrackAudioSourceNode
接口
此接口表示来自 MediaStreamTrack
的音频源。
| 属性 | 值 | 备注 |
|---|---|---|
numberOfInputs
| 0 | |
numberOfOutputs
| 1 | |
| 尾部时间引用 | 否 |
输出的声道数量与
mediaStreamTrack
的声道数量相对应。
如果 MediaStreamTrack
的采样率与关联
AudioContext
的采样率不同,
则
mediaStreamTrack
的输出会重新采样,
以匹配上下文的 采样率。
[Exposed =Window ]interface MediaStreamTrackAudioSourceNode :AudioNode {constructor (AudioContext ,context MediaStreamTrackAudioSourceOptions ); };options
1.25.1. 构造函数
MediaStreamTrackAudioSourceNode(context, options)-
-
如果
mediaStreamTrack的kind属性不是"audio",则抛出InvalidStateError并中止这些步骤。 -
以 context 和 options 作为参数, 初始化 AudioNode this。
MediaStreamTrackAudioSourceNode.constructor() 方法的参数。 参数 类型 可为空 可选 说明 contextAudioContext✘ ✘ 此新 MediaStreamTrackAudioSourceNode将关联的AudioContext。optionsMediaStreamTrackAudioSourceOptions✘ ✘ 此 MediaStreamTrackAudioSourceNode的初始参数值。 -
1.25.2.
MediaStreamTrackAudioSourceOptions
这指定了构造
MediaStreamTrackAudioSourceNode
时使用的选项。
此选项是
必需的。
dictionary MediaStreamTrackAudioSourceOptions {required MediaStreamTrack mediaStreamTrack ; };
1.25.2.1.
字典 MediaStreamTrackAudioSourceOptions
成员
mediaStreamTrack, 类型为 MediaStreamTrack-
将作为源的媒体流轨道。如果此
MediaStreamTrack的kind属性 不是"audio",则必须抛出InvalidStateError。
1.26.
OscillatorNode
接口
OscillatorNode
表示一个生成周期波形的音频源。
它可以设置为几种常用
波形。此外,还可以通过使用
PeriodicWave
对象将其设置为任意周期
波形。
振荡器是音频合成中常见的基础构建块。
OscillatorNode 将在
start()
方法指定的时间开始发声。
从数学上说,连续时间周期波形 在频域中考虑时可能具有非常高(甚至无限高)的频率信息。 当此波形以特定采样率 采样为离散时间数字音频信号时, 在将波形转换为数字形式之前,必须注意丢弃(滤除) 高于奈奎斯特频率的高频 信息。如果不这样做,则高于混叠频率(高于 奈奎斯特 频率)的成分将以镜像形式折叠到低于 奈奎斯特 频率的频率中。在许多情况下,这会造成 听感上令人不适的伪影。这是音频 DSP 中一个基本且已被充分理解的 原理。
实现可以采用多种实用方法来避免这种混叠。 无论采用何种方法,理想化的离散时间数字音频信号 都有明确的数学定义。实现所面临的权衡,是 实现成本(以 CPU 使用量计)与 实现这一理想状态的保真度之间的权衡。
期望实现会采取一定措施 以达到这一理想状态,但在低端硬件上采用质量较低、 成本较低的方法也是合理的。
frequency
和 detune
都是 a-rate
参数,并构成一个复合参数。它们共同用于
确定 computedOscFrequency 值:
computedOscFrequency(t) = frequency(t) * pow(2, detune(t) / 1200)
OscillatorNode 在每一时刻的瞬时相位,是 computedOscFrequency 关于时间的定积分, 假设节点精确启动时刻的相位角为零。其标称范围为 [-奈奎斯特 频率, 奈奎斯特频率]。
此节点的单个输出由一个声道(单声道)组成。
| 属性 | 值 | 备注 |
|---|---|---|
numberOfInputs
| 0 | |
numberOfOutputs
| 1 | |
channelCount
| 2 | |
channelCountMode
| "max"
| |
channelInterpretation
| "speakers"
| |
| 尾部时间 | 否 |
enum {OscillatorType "sine" ,"square" ,"sawtooth" ,"triangle" ,"custom" };
| 枚举值 | 说明 |
|---|---|
"sine"
| 正弦波 |
"square"
| 占空周期为 0.5 的方波 |
"sawtooth"
| 锯齿波 |
"triangle"
| 三角波 |
"custom"
| 自定义周期波 |
[Exposed =Window ]interface OscillatorNode :AudioScheduledSourceNode {constructor (BaseAudioContext ,context optional OscillatorOptions = {});options attribute OscillatorType type ;readonly attribute AudioParam frequency ;readonly attribute AudioParam detune ;undefined setPeriodicWave (PeriodicWave ); };periodicWave
1.26.1. 构造函数
OscillatorNode(context, options)-
当使用
BaseAudioContextc 和 选项对象 option 调用构造函数时,用户代理必须以 context 和 options 作为参数, 初始化 AudioNode this。OscillatorNode.constructor() 方法的参数。 参数 类型 可为空 可选 说明 contextBaseAudioContext✘ ✘ 此新 OscillatorNode将关联的BaseAudioContext。optionsOscillatorOptions✘ ✔ 此 OscillatorNode的可选初始参数值。
1.26.2. 属性
detune, 类型为 AudioParam, 只读-
一个失谐值(以音分为单位),它会将
frequency偏移给定的量。其默认value为 0。此参数是 a-rate。它 与frequency构成一个复合参数, 以形成 computedOscFrequency。下面列出的标称范围允许此参数在所有可能的 频率范围内对frequency进行失谐。参数 值 备注 defaultValue0 minValue\(\approx -153600\) maxValue\(\approx 153600\) 此值约为 \(1200\ \log_2 \mathrm{FLT\_MAX}\),其中 FLT_MAX 是最大的 float值。automationRate" a-rate" frequency, 类型为 AudioParam, 只读-
周期波形的频率(以赫兹为单位)。其默认
value为 440。此参数是 a-rate。它 与detune构成一个复合参数, 以形成 computedOscFrequency。其标称范围 为 [-奈奎斯特 频率, 奈奎斯特频率]。参数 值 备注 defaultValue440 minValue-奈奎斯特频率 maxValue奈奎斯特频率 automationRate" a-rate" type, 类型为 OscillatorType-
周期波形的形状。它可以直接设置为除 "
custom" 之外的任何类型常量值。 将其设置为该值必须抛出InvalidStateError异常。setPeriodicWave()方法可以用于设置自定义波形,这会使此属性 被设置为 "custom"。 默认值为 "sine"。 设置此 属性时,振荡器的相位必须保持不变。
1.26.3. 方法
setPeriodicWave(periodicWave)-
使用给定的
PeriodicWave设置任意自定义周期波形。OscillatorNode.setPeriodicWave() 方法的参数。 参数 类型 可为空 可选 说明 periodicWavePeriodicWave✘ ✘ 振荡器要使用的自定义波形 返回类型:undefined
1.26.4.
OscillatorOptions
这指定了构造
OscillatorNode
时使用的选项。
所有成员均为
可选;如果未指定,则使用通常的默认值
构造振荡器。
dictionary OscillatorOptions :AudioNodeOptions {OscillatorType type = "sine";float frequency = 440;float detune = 0;PeriodicWave periodicWave ; };
1.26.4.1.
字典 OscillatorOptions
成员
detune, 类型为 float,默认值为0-
OscillatorNode的初始 detune 值。 frequency, 类型为 float,默认值为440-
OscillatorNode的初始频率。 periodicWave, 类型为 PeriodicWave-
用于
OscillatorNode的PeriodicWave。 如果指定了此成员,则type的任何有效值都会被忽略;其 处理方式就像指定了 "custom" 一样。 type, 类型为 OscillatorType,默认值为"sine"-
要构造的振荡器类型。如果将其设置为 "custom" 而没有同时指定
periodicWave, 则 必须抛出InvalidStateError异常。如果指定了periodicWave, 则type的任何有效值都会被忽略;其 处理方式就像被设置为 "custom" 一样。
1.26.5. 基本波形相位
各种振荡器 类型的理想化数学波形定义如下。概括而言,所有波形在数学上都被定义为 在时间 0 处具有正斜率的奇函数。 振荡器实际产生的波形可能会有所不同,以 防止混叠效应。
振荡器必须产生与使用一个 PeriodicWave
并配有适当的傅里叶
级数且将 disableNormalization
设置为 false 来创建这些
基本波形时相同的结果。
- "
sine" -
正弦振荡器的波形为:
$$ x(t) = \sin t $$ - "
square" -
方波振荡器的波形为:
$$
    x(t) = \begin{cases}
                 1 & \mbox{for } 0≤ t < \pi \\
                 -1 & \mbox{for } -\pi < t < 0.
                 \end{cases}
$$
利用该波形是周期为 \(2\pi\) 的奇函数这一事实, 将其扩展到所有 \(t\)。
- "
sawtooth" -
锯齿波振荡器的波形是斜坡:
$$
    x(t) = \frac{t}{\pi} \mbox{ for } -\pi < t ≤ \pi;
$$
利用该波形是周期为 \(2\pi\) 的奇函数这一事实, 将其扩展到所有 \(t\)。
- "
triangle" -
三角波振荡器的波形为:
$$
    x(t) = \begin{cases}
                     \frac{2}{\pi} t & \mbox{for } 0 ≤ t ≤ \frac{\pi}{2} \\
                     1-\frac{2}{\pi} \left(t-\frac{\pi}{2}\right) & \mbox{for }
                     \frac{\pi}{2} < t ≤ \pi.
                 \end{cases}
$$
利用该波形是周期为 \(2\pi\) 的奇函数这一事实, 将其扩展到所有 \(t\)。
1.27.
PannerNode
接口
此接口表示一个处理节点,它在三维空间中
定位/空间化传入的音频
流。空间化是相对于
BaseAudioContext
的
AudioListener
(listener
属性)进行的。
| 属性 | 值 | 备注 |
|---|---|---|
numberOfInputs
| 1 | |
numberOfOutputs
| 1 | |
channelCount
| 2 | 具有 channelCount 约束 |
channelCountMode
| "clamped-max"
| 具有 channelCountMode 约束 |
channelInterpretation
| "speakers"
| |
| 尾部时间 | 可能有 | 如果 panningModel
设置为 "HRTF",
由于头部响应固有的处理,节点会在输入静音时产生非静音输出。
否则尾部时间为零。
|
此节点的输入为单声道(1 个声道)或立体声(2 个 声道),且不能增加。来自声道数更少 或更多节点的连接将被适当地升混或降混。
如果节点正在主动处理,则此节点的输出 固定为立体声(2 个声道),且无法配置。如果节点 未主动 处理,则输出为单声道 静音。
PanningModelType
枚举决定使用哪种
空间化算法在 3D
空间中定位音频。默认值为 "equalpower"。
enum {PanningModelType "equalpower" ,"HRTF" };
| 枚举值 | 说明 |
|---|---|
"equalpower"
|
一种使用等功率
声像定位的简单高效空间化算法。
注: 使用此声像定位模型时,
用于计算此节点输出的所有 |
"HRTF"
|
一种质量更高的空间化算法,使用
从人体受试者测得的脉冲响应进行卷积。此声像定位
方法渲染立体声输出。
注:使用此声像定位模型时,
用于计算此节点输出的所有 |
PannerNode
的某个
AudioParam
的有效
自动化速率由
panningModel
和
AudioParam
的
automationRate
决定。如果
panningModel
为 "HRTF",
则
有效
自动化速率为 "k-rate",
与 automationRate
的设置无关。
否则,有效自动化速率就是
automationRate
的值。
DistanceModelType
枚举决定在音频源
远离监听者时,使用哪种
算法降低音量。默认值为 "inverse"。
在下面每种距离模型的说明中,令 \(d\) 为
监听者与声像节点之间的距离;\(d_{ref}\) 为
refDistance
属性的值;\(d_{max}\) 为
maxDistance
属性的值;\(f\) 为
rolloffFactor
属性的值。
enum {DistanceModelType "linear" ,"inverse" ,"exponential" };
| 枚举值 | 说明 |
|---|---|
"linear"
|
一个线性距离模型,它按照以下公式计算
distanceGain:
$$
    1 - f\ \frac{\max\left[\min\left(d, d'_{max}\right), d'_{ref}\right] - d'_{ref}}{d'_{max} - d'_{ref}}
$$
其中 \(d’_{ref} = \min\left(d_{ref}, d_{max}\right)\),\(d’_{max} = \max\left(d_{ref}, d_{max}\right)\)。在 \(d’_{ref} = d’_{max}\) 的情况下,线性模型的值取为 \(1-f\)。 请注意,\(d\) 被钳制到区间 \(\left[d’_{ref},\, d’_{max}\right]\)。 |
"inverse"
|
一个反距离模型,它按照以下公式计算
distanceGain:
$$
    \frac{d_{ref}}{d_{ref} + f\ \left[\max\left(d, d_{ref}\right) - d_{ref}\right]}
$$
也就是说,\(d\) 被钳制到区间 \(\left[d_{ref},\, \infty\right)\)。如果 \(d_{ref} = 0\),则反距离模型的值 取为 0,与 \(d\) 和 \(f\) 的值无关。 |
"exponential"
|
一个指数距离模型,它按照以下公式计算
distanceGain:
$$
    \left[\frac{\max\left(d, d_{ref}\right)}{d_{ref}}\right]^{-f}
$$
也就是说,\(d\) 被钳制到区间 \(\left[d_{ref},\, \infty\right)\)。如果 \(d_{ref} = 0\),则指数模型的值 取为 0,与 \(d\) 和 \(f\) 无关。 |
[Exposed =Window ]interface PannerNode :AudioNode {constructor (BaseAudioContext ,context optional PannerOptions = {});options attribute PanningModelType panningModel ;readonly attribute AudioParam positionX ;readonly attribute AudioParam positionY ;readonly attribute AudioParam positionZ ;readonly attribute AudioParam orientationX ;readonly attribute AudioParam orientationY ;readonly attribute AudioParam orientationZ ;attribute DistanceModelType distanceModel ;attribute double refDistance ;attribute double maxDistance ;attribute double rolloffFactor ;attribute double coneInnerAngle ;attribute double coneOuterAngle ;attribute double coneOuterGain ;undefined setPosition (float ,x float ,y float );z undefined setOrientation (float ,x float ,y float ); };z
1.27.1. 构造函数
PannerNode(context, options)-
当使用
BaseAudioContextc 和 选项对象 option 调用构造函数时,用户代理必须以 context 和 options 作为参数, 初始化 AudioNode this。PannerNode.constructor() 方法的参数。 参数 类型 可为空 可选 说明 contextBaseAudioContext✘ ✘ 此新 PannerNode将关联的BaseAudioContext。optionsPannerOptions✘ ✔ 此 PannerNode的可选初始参数值。
1.27.2. 属性
coneInnerAngle, 类型为 double-
定向音频源的一个参数,它是一个以 度为单位的角度,在该角度范围内音量不会降低。其 默认值为 360。如果角度超出 区间 [0, 360],则行为未定义。
coneOuterAngle, 类型为 double-
定向音频源的一个参数,它是一个以 度为单位的角度,在该角度之外,音量会降低到
coneOuterGain的恒定值。 默认 值为 360。如果角度超出 区间 [0, 360],则行为未定义。 coneOuterGain, 类型为 double-
定向音频源的一个参数,表示
coneOuterAngle之外的增益。 默认 值为 0。它是范围 [0, 1] 内的线性值(不是 dB)。如果参数 超出此范围,则必须抛出InvalidStateError。 distanceModel, 类型为 DistanceModelType-
指定此
PannerNode使用的距离模型。 默认值为 "inverse"。 maxDistance, 类型为 double-
音源与监听者之间的最大距离,超过该距离后 音量将不再进一步降低。默认值为 10000。 如果将其设置为非正值,则必须抛出
RangeError异常。 orientationX, 类型为 AudioParam, 只读-
描述音频源在 3D 笛卡尔坐标空间中所指方向向量的 \(x\) 分量。
参数 值 备注 defaultValue1 minValue最小负单精度浮点数 约 -3.4028235e38 maxValue最大正单精度浮点数 约 3.4028235e38 automationRate" a-rate"具有 自动化速率 约束 orientationY, 类型为 AudioParam, 只读-
描述音频源在 3D 笛卡尔坐标空间中所指方向向量的 \(y\) 分量。
参数 值 备注 defaultValue0 minValue最小负单精度浮点数 约 -3.4028235e38 maxValue最大正单精度浮点数 约 3.4028235e38 automationRate" a-rate"具有 自动化速率 约束 orientationZ, 类型为 AudioParam, 只读-
描述音频源在 3D 笛卡尔坐标空间中所指方向向量的 \(z\) 分量。
参数 值 备注 defaultValue0 minValue最小负单精度浮点数 约 -3.4028235e38 maxValue最大正单精度浮点数 约 3.4028235e38 automationRate" a-rate"具有 自动化速率 约束 panningModel, 类型为 PanningModelType-
指定此
PannerNode使用的声像定位模型。 默认值为 "equalpower"。 positionX, 类型为 AudioParam, 只读-
设置音频源在 3D 笛卡尔坐标系中的 \(x\) 坐标位置。
参数 值 备注 defaultValue0 minValue最小负单精度浮点数 约 -3.4028235e38 maxValue最大正单精度浮点数 约 3.4028235e38 automationRate" a-rate"具有 自动化速率 约束 positionY, 类型为 AudioParam, 只读-
设置音频源在 3D 笛卡尔坐标系中的 \(y\) 坐标位置。
参数 值 备注 defaultValue0 minValue最小负单精度浮点数 约 -3.4028235e38 maxValue最大正单精度浮点数 约 3.4028235e38 automationRate" a-rate"具有 自动化速率 约束 positionZ, 类型为 AudioParam, 只读-
设置音频源在 3D 笛卡尔坐标系中的 \(z\) 坐标位置。
参数 值 备注 defaultValue0 minValue最小负单精度浮点数 约 -3.4028235e38 maxValue最大正单精度浮点数 约 3.4028235e38 automationRate" a-rate"具有 自动化速率 约束 refDistance, 类型为 double-
随着音源远离监听者而降低音量时使用的参考距离。 对于小于此距离的距离,音量不会降低。默认值为 1。 如果将其设置 为负值,则必须抛出
RangeError异常。 rolloffFactor, 类型为 double-
描述音源远离监听者时音量降低的速度。 默认值为 1。如果将其设置为 负值,则必须抛出
RangeError异常。rolloffFactor的标称范围指定rolloffFactor可以具有的最小值和最大值。 超出该范围的值会被钳制在 此范围内。标称范围取决于distanceModel, 如下:- "
linear" -
标称范围为 \([0, 1]\)。
- "
inverse" -
标称范围为 \([0, \infty)\)。
- "
exponential" -
标称范围为 \([0, \infty)\)。
请注意,钳制是在距离计算 处理过程中发生的。该属性 反映所设置的值,并不会被修改。
- "
1.27.3. 方法
setOrientation(x, y, z)-
此方法已弃用。它等同于分别使用
x、y和z参数直接设置orientationX.value、orientationY.value和orientationZ.value属性。因此,如果在调用此方法时,
orientationX、orientationY和orientationZAudioParam中的任何一个已使用setValueCurveAtTime()设置自动化曲线, 则必须抛出NotSupportedError。描述音频源在 3D 笛卡尔坐标空间中所指的方向。根据 声音的方向性强弱(由锥体属性控制), 指向远离监听者方向的声音可能非常轻,甚至完全 静音。
x, y, z参数表示 3D 空间中的方向 向量。默认值为 (1,0,0)。
PannerNode.setOrientation() 方法的参数。 参数 类型 可为空 可选 说明 xfloat✘ ✘ yfloat✘ ✘ zfloat✘ ✘ 返回类型:undefined setPosition(x, y, z)-
此方法已弃用。它等同于分别使用
x、y和z参数直接设置positionX.value、positionY.value和positionZ.value属性。因此,如果在调用此方法时,
positionX、positionY和positionZAudioParam中的任何一个已使用setValueCurveAtTime()设置自动化 曲线, 则必须抛出NotSupportedError。设置音频源相对于
listener属性的位置。使用 3D 笛卡尔 坐标系。x, y, z参数表示 3D 空间中的坐标。默认值为 (0,0,0)。
PannerNode.setPosition() 方法的参数。 参数 类型 可为空 可选 说明 xfloat✘ ✘ yfloat✘ ✘ zfloat✘ ✘ 返回类型:undefined
1.27.4.
PannerOptions
这指定了构造
PannerNode
时使用的选项。
所有成员均为可选;如果未
指定,则使用通常的默认值构造节点。
dictionary PannerOptions :AudioNodeOptions {PanningModelType panningModel = "equalpower";DistanceModelType distanceModel = "inverse";float positionX = 0;float positionY = 0;float positionZ = 0;float orientationX = 1;float orientationY = 0;float orientationZ = 0;double refDistance = 1;double maxDistance = 10000;double rolloffFactor = 1;double coneInnerAngle = 360;double coneOuterAngle = 360;double coneOuterGain = 0; };
1.27.4.1.
字典 PannerOptions
成员
coneInnerAngle, 类型为 double,默认值为360-
节点的
coneInnerAngle属性的初始值。 coneOuterAngle, 类型为 double,默认值为360-
节点的
coneOuterAngle属性的初始值。 coneOuterGain, 类型为 double,默认值为0-
节点的
coneOuterGain属性的初始值。 distanceModel, 类型为 DistanceModelType,默认值为"inverse"-
节点要使用的距离模型。
maxDistance, 类型为 double,默认值为10000-
节点的
maxDistance属性的初始值。 orientationX, 类型为 float,默认值为1-
orientationXAudioParam 的初始 \(x\) 分量值。 orientationY, 类型为 float,默认值为0-
orientationYAudioParam 的初始 \(y\) 分量值。 orientationZ, 类型为 float,默认值为0-
orientationZAudioParam 的初始 \(z\) 分量值。 panningModel, 类型为 PanningModelType,默认值为"equalpower"-
节点要使用的声像定位模型。
positionX, 类型为 float,默认值为0-
positionXAudioParam 的初始 \(x\) 坐标值。 positionY, 类型为 float,默认值为0-
positionYAudioParam 的初始 \(y\) 坐标值。 positionZ, 类型为 float,默认值为0-
positionZAudioParam 的初始 \(z\) 坐标值。 refDistance, 类型为 double,默认值为1-
节点的
refDistance属性的初始值。 rolloffFactor, 类型为 double,默认值为1-
节点的
rolloffFactor属性的初始值。
1.27.5. 声道限制
适用于 StereoPannerNode
的声道
限制集合也适用于
PannerNode。
1.28.
PeriodicWave
接口
PeriodicWave
表示一个任意周期波形,供
OscillatorNode
使用。
符合规范的实现必须支持至少具有 8192 个元素的 PeriodicWave。
[Exposed =Window ]interface PeriodicWave {constructor (BaseAudioContext ,context optional PeriodicWaveOptions = {}); };options
1.28.1. 构造函数
PeriodicWave(context, options)-
-
令 p 为一个新的
PeriodicWave对象。令[[real]]和[[imag]]为两个 类型为Float32Array的内部槽,并令[[normalize]]为一个内部 槽。 -
根据以下情况之一处理
options:-
如果
options.real和options.imag均存在-
如果
options.real和options.imag的长度不同,或者任一长度小于 2,则抛出IndexSizeError并中止此算法。 -
将
[[real]]和[[imag]]设置为与options.real长度相同的新数组。 -
将
options.real中的所有元素复制到[[real]], 并将options.imag中的所有元素复制到[[imag]]。
-
-
如果仅
options.real存在-
如果
options.real的长度小于 2,则抛出IndexSizeError并中止此算法。 -
将
[[real]]和[[imag]]设置为与options.real长度相同的数组。 -
将
options.real复制到[[real]], 并将[[imag]]设置为全零。
-
-
如果仅
options.imag存在-
如果
options.imag的长度小于 2,则抛出IndexSizeError并中止此算法。 -
将
[[real]]和[[imag]]设置为与options.imag长度相同的数组。 -
将
options.imag复制到[[imag]], 并将[[real]]设置为全零。
-
-
否则
注: 当将此
PeriodicWave设置到OscillatorNode上时,这等同于使用内置类型 "sine"。
-
-
将
[[normalize]]初始化为PeriodicWaveOptions上PeriodicWaveConstraints的disableNormalization属性的反值。 -
返回 p。
PeriodicWave.constructor() 方法的参数。 参数 类型 可为空 可选 说明 contextBaseAudioContext✘ ✘ 此新 PeriodicWave将关联的BaseAudioContext。与AudioBuffer不同,PeriodicWave不能在不同的AudioContext或OfflineAudioContext之间共享。 它与一个特定的BaseAudioContext关联。optionsPeriodicWaveOptions✘ ✔ 此 PeriodicWave的可选初始参数值。 -
1.28.2.
PeriodicWaveConstraints
PeriodicWaveConstraints
字典用于
指定如何对波形进行归一化。
dictionary PeriodicWaveConstraints {boolean disableNormalization =false ; };
1.28.2.1.
字典 PeriodicWaveConstraints
成员
disableNormalization, 类型为 boolean,默认值为false-
控制是否对周期波进行归一化。如果
true,则不对波形进行归一化;否则, 对波形进行归一化。
1.28.3.
PeriodicWaveOptions
PeriodicWaveOptions
字典用于指定
如何构造波形。如果仅指定 real
或 imag
中的一个。另一个会被视为
一个长度相同且全部为零的数组,如下文
字典成员的
说明中所述。如果二者均未给出,则创建一个
PeriodicWave,
它必须等价于
一个 OscillatorNode,其
type
为 "sine"。
如果
二者均已给出,则序列必须具有相同长度;否则
必须抛出类型为
NotSupportedError
的错误。
dictionary PeriodicWaveOptions :PeriodicWaveConstraints {sequence <float >real ;sequence <float >imag ; };
1.28.3.1.
字典 PeriodicWaveOptions
成员
imag, 类型为 sequence<float>-
imag参数表示一个sine项数组。第一个元素(索引 0)在 傅里叶级数中不存在。第二个元素 (索引 1)表示基频。 第三个元素表示第一泛音,依此类推。 real, 类型为 sequence<float>-
real参数表示一个cosine项数组。第一个元素(索引 0)是 周期波形的 DC 偏移。第二个元素 (索引 1)表示基频。 第三个元素表示第一泛音,依此类推。
1.28.4. 波形生成
createPeriodicWave()
方法接受两个数组,用于指定
PeriodicWave
的傅里叶系数。
令 \(a\) 和 \(b\) 分别表示长度为 \(L\) 的 [[real]]
和 [[imag]]
数组。则基本时域波形
\(x(t)\) 可以使用以下公式计算:
$$
    x(t) = \sum_{k=1}^{L-1} \left[a[k]\cos2\pi k t + b[k]\sin2\pi k t\right]
$$
这是基本(未归一化)波形。
1.28.5. 波形归一化
如果此
PeriodicWave
的内部槽 [[normalize]]
为 true(默认值),则
对上一节中定义的波形进行归一化,使其
最大值为 1。归一化过程如下。
令
$$
    \tilde{x}(n) = \sum_{k=1}^{L-1} \left(a[k]\cos\frac{2\pi k n}{N} + b[k]\sin\frac{2\pi k n}{N}\right)
$$
其中 \(N\) 是 2 的幂。(注:\(\tilde{x}(n)\) 可以 方便地使用逆 FFT 计算。)固定 归一化因子 \(f\) 的计算方式如下。
$$
    f = \max_{n = 0, \ldots, N - 1} |\tilde{x}(n)|
$$
因此,实际归一化后的波形 \(\hat{x}(n)\) 为:
$$
    \hat{x}(n) = \frac{\tilde{x}(n)}{f}
$$
此固定归一化因子必须应用于所有生成的 波形。
1.28.6. 振荡器系数
内置振荡器类型使用 PeriodicWave
对象创建。为完整起见,这里给出了
每种内置振荡器类型的 PeriodicWave
系数。如果需要使用
内置类型但不希望进行默认归一化,这会很有用。
在以下说明中,令 \(a\) 为实数
系数数组,\(b\) 为
createPeriodicWave()
的虚数系数数组。在
所有情况下,对于所有 \(n\),\(a[n] = 0\),因为波形是奇
函数。此外,在所有情况下 \(b[0] = 0\)。因此,下面仅指定
\(n \ge 1\) 时的 \(b[n]\)。
- "
sine" -
$$ b[n] = \begin{cases} 1 & \mbox{for } n = 1 \\ 0 & \mbox{otherwise} \end{cases} $$ - "
square" -
$$ b[n] = \frac{2}{n\pi}\left[1 - (-1)^n\right] $$ - "
sawtooth" -
$$ b[n] = (-1)^{n+1} \dfrac{2}{n\pi} $$ - "
triangle" -
$$
    b[n] = \frac{8\sin\dfrac{n\pi}{2}}{(\pi n)^2}
$$
1.29.
ScriptProcessorNode
接口 - 已弃用
此接口是一个 AudioNode,
可以
使用脚本直接生成、处理或分析音频。此
节点类型已弃用,将由
AudioWorkletNode
取代;在实现移除此节点类型之前,
此文本仅用于提供信息。
| 属性 | 值 | 备注 |
|---|---|---|
numberOfInputs
| 1 | |
numberOfOutputs
| 1 | |
channelCount
| numberOfInputChannels
| 这是构造此节点时指定的声道数量。具有 channelCount 约束。 |
channelCountMode
| "explicit"
| 具有 channelCountMode 约束 |
channelInterpretation
| "speakers"
| |
| 尾部时间 | 否 |
ScriptProcessorNode
在构造时带有一个
bufferSize,
其值必须是以下值之一:256、
512、1024、2048、4096、8192、16384。此值控制
audioprocess
事件的派发频率,以及
每次调用需要处理多少采样帧。仅当
ScriptProcessorNode
至少连接了一个输入或一个输出时,
才会派发
audioprocess
事件。较小的
bufferSize
值会产生
更低(更好)的延迟。较大的值
对避免音频中断和故障是必要的。如果
未传入
createScriptProcessor()
的 bufferSize 参数,或者将其设置为 0,
则该值由实现选择。
numberOfInputChannels
和 numberOfOutputChannels
决定输入和输出声道的数量。
numberOfInputChannels
和 numberOfOutputChannels
同时为零是无效的。
[Exposed =Window ]interface ScriptProcessorNode :AudioNode {attribute EventHandler onaudioprocess ;readonly attribute long bufferSize ; };
1.29.1. 属性
bufferSize, 类型为 long,只读-
每次触发
audioprocess时需要处理的缓冲区大小(以采样帧为单位)。 合法值为 (256, 512, 1024, 2048, 4096, 8192, 16384)。 onaudioprocess, 类型为 EventHandler-
一个用于为
audioprocess事件类型设置事件处理程序的属性,该事件会派发到ScriptProcessorNode节点类型。派发给事件 处理程序的事件使用AudioProcessingEvent接口。
1.30.
StereoPannerNode
接口
此接口表示一个处理节点,它使用低成本声像定位 算法在立体声声像中定位 传入的音频流。这种声像定位效果常用于在 立体声音频流中定位音频组件。
| 属性 | 值 | 备注 |
|---|---|---|
numberOfInputs
| 1 | |
numberOfOutputs
| 1 | |
channelCount
| 2 | 具有 channelCount 约束 |
channelCountMode
| "clamped-max"
| 具有 channelCountMode 约束 |
channelInterpretation
| "speakers"
| |
| 尾部时间 | 否 |
此节点的输入为立体声(2 个声道),且不能 增加。来自具有更少或更多声道的节点的连接将被 适当地升混或降混。
此节点的输出固定为立体声(2 个声道),且 无法配置。
[Exposed =Window ]interface StereoPannerNode :AudioNode {constructor (BaseAudioContext ,context optional StereoPannerOptions = {});options readonly attribute AudioParam pan ; };
1.30.1. 构造函数
StereoPannerNode(context, options)-
当使用
BaseAudioContextc 和 选项对象 option 调用构造函数时,用户代理必须以 context 和 options 作为参数, 初始化 AudioNode this。StereoPannerNode.constructor() 方法的参数。 参数 类型 可为空 可选 说明 contextBaseAudioContext✘ ✘ 此新 StereoPannerNode将关联的BaseAudioContext。optionsStereoPannerOptions✘ ✔ 此 StereoPannerNode的可选初始参数值。
1.30.2. 属性
pan, 类型为 AudioParam, 只读-
输入在输出立体声声像中的位置。-1 表示完全靠左,+1 表示完全靠右。
参数 值 备注 defaultValue0 minValue-1 maxValue1 automationRate" a-rate"
1.30.3.
StereoPannerOptions
这指定了构造
StereoPannerNode
时使用的选项。
所有成员均为可选;如果
未指定,则使用通常的默认值构造节点。
dictionary StereoPannerOptions :AudioNodeOptions {float pan = 0; };
1.30.3.1.
字典 StereoPannerOptions
成员
pan, 类型为 float,默认值为0-
panAudioParam 的初始值。
1.30.4. 声道限制
由于其处理受上述定义约束,
StereoPannerNode
最多只能混合
2 个音频声道,并且恰好产生 2 个声道。可以使用 ChannelSplitterNode、
由
GainNode
和/或其他节点组成的子图进行中间处理,然后
通过 ChannelMergerNode
重新组合,从而实现任意
声像定位和混音方法。
1.31.
WaveShaperNode
接口
WaveShaperNode
是一个
AudioNode
处理器,用于实现非线性
失真效果。
非线性波形整形失真通常既可用于细微的 非线性增暖效果,也可用于更明显的失真效果。可以指定任意 非线性整形曲线。
| 属性 | 值 | 备注 |
|---|---|---|
numberOfInputs
| 1 | |
numberOfOutputs
| 1 | |
channelCount
| 2 | |
channelCountMode
| "max"
| |
channelInterpretation
| "speakers"
| |
| 尾部时间 | 可能有 | 仅当 oversample
属性设置为 "2x"
或 "4x"
时才存在尾部时间。
此尾部时间的实际持续时间取决于实现。
|
输出的声道数量始终等于 输入的声道数量。
enum {OverSampleType "none" ,"2x" ,"4x" };
| 枚举值 | 说明 |
|---|---|
"none"
| 不进行过采样 |
"2x"
| 进行两倍过采样 |
"4x"
| 进行四倍过采样 |
[Exposed =Window ]interface WaveShaperNode :AudioNode {constructor (BaseAudioContext ,context optional WaveShaperOptions = {});options attribute Float32Array ?curve ;attribute OverSampleType oversample ; };
1.31.1. 构造函数
WaveShaperNode(context, options)-
当使用
BaseAudioContextc 和 选项对象 option 调用构造函数时,用户代理必须以 context 和 options 作为参数, 初始化 AudioNode this。另外,令
[[curve set]]为此WaveShaperNode的内部 槽。 将此槽初始化为false。如果给定了options并指定了curve, 则将[[curve set]]设置为true。WaveShaperNode.constructor() 方法的参数。 参数 类型 可为空 可选 说明 contextBaseAudioContext✘ ✘ 此新 WaveShaperNode将关联的BaseAudioContext。optionsWaveShaperOptions✘ ✔ 此 WaveShaperNode的可选初始参数值。
1.31.2. 属性
curve, 类型为 Float32Array,可为空-
用于波形整形效果的整形曲线。输入 信号标称位于范围 [-1, 1] 内。此范围内的每个输入采样 都会索引到整形曲线中;如果数组中的条目数为奇数, 则信号电平为零时对应曲线数组的 中心值;如果数组中的条目数为偶数,则在 最中间的两个值之间进行插值。任何小于 -1 的采样值都对应曲线数组中的第一个值。任何 大于 +1 的采样值都对应曲线数组中的最后一个值。
实现必须在曲线中的 相邻点之间执行线性插值。最初 curve 属性为 null,这意味着 WaveShaperNode 会将其输入 原样传递到输出。
curve 的值以等间距分布在 [-1; 1] 范围内。这意味着,具有 偶数个值的
curve在信号为 零时不会有对应值,而具有奇数个 值的curve在信号为零时会有对应值。输出 由以下算法确定。-
令 \(x\) 为输入采样,\(y\) 为节点的 对应输出,\(c_k\) 为
curve的第 \(k\) 个元素,而 \(N\) 为curve的长度。 -
令
$$ \begin{align*} v &= \frac{N-1}{2}(x + 1) \\ k &= \lfloor v \rfloor \\ f &= v - k \end{align*} $$ -
则
$$
    \begin{align*}
    y &=
        \begin{cases}
        c_0 & v \lt 0 \\
        c_{N-1} & v \ge N - 1 \\
        (1-f)\,c_k + fc_{k+1} & \mathrm{otherwise}
        \end{cases}
    \end{align*}
$$
如果将此 属性设置为一个
Float32Array, 且其length小于 2,则必须抛出InvalidStateError。设置此属性时,
WaveShaperNode会创建曲线的内部副本。因此, 随后对用于设置该 属性的数组内容所做的修改不会产生影响。要设置curve属性,请执行以下步骤:-
令 new curve 为要赋给
curve的Float32Array或null。 . -
如果 new curve 不是
null,并且[[curve set]]为 true,则抛出InvalidStateError并中止这些步骤。 -
如果 new curve 不是
null,则将[[curve set]]设置为 true。 -
将 new curve 赋给
curve属性。
注: 使用在输入值为零时产生 非零 输出值的曲线,会导致此节点 即使没有任何输入 连接到此节点,也产生 DC 信号。这种情况将持续到 节点与下游节点断开连接为止。
-
oversample, 类型为 OverSampleType-
指定应用整形曲线时应使用哪种 过采样类型(如果有)。默认值为 "
none", 表示曲线将直接应用于输入 采样。值为 "2x" 或 "4x" 可以通过避免部分混叠来提高 处理质量,其中 "4x" 值 可提供最高质量。对于某些应用,最好 不使用过采样,以获得非常精确的 整形曲线。值为 "2x" 或 "4x" 意味着必须执行 以下步骤:-
将输入采样升采样至
AudioContext采样率的 2 倍或 4 倍。 因此,对于每个渲染 量子,生成两倍(对于 2x)或四倍(对于 4x)的采样。 -
应用整形曲线。
-
将结果降采样回
AudioContext的采样率。 因此,取之前已处理的采样 已处理的采样,生成一个渲染量子数量的 采样作为最终结果。
未指定确切的升采样和降采样滤波器, 可针对音质(低混叠等)、低延迟 或性能进行调优。
注: 使用过采样会由于 升采样和降采样滤波器而引入一定程度的音频处理 延迟。此延迟的大小可能因 实现而异。
-
1.31.3.
WaveShaperOptions
这指定了构造
WaveShaperNode
时使用的选项。
所有成员均为可选;如果
未指定,则使用通常的默认值构造节点。
dictionary WaveShaperOptions :AudioNodeOptions {sequence <float >curve ;OverSampleType oversample = "none"; };
1.31.3.1.
字典 WaveShaperOptions
成员
curve, 类型为 sequence<float>-
波形整形效果的整形曲线。
oversample, 类型为 OverSampleType,默认值为"none"-
用于整形曲线的过采样类型。
1.32.
AudioWorklet
接口
[Exposed =Window ,SecureContext ]interface AudioWorklet :Worklet {readonly attribute MessagePort port ; };
1.32.1. 属性
port, 类型为 MessagePort,只读-
一个
MessagePort, 连接到AudioWorkletGlobalScope上的端口。注: 在此
port的"message"事件上注册事件监听器的作者, 应当在MessageChannel的任一端(在AudioWorklet端或AudioWorkletGlobalScope端)调用close, 以便资源可以被 回收。
1.32.2. 概念
AudioWorklet
对象允许开发者提供脚本
(例如 JavaScript 或 WebAssembly 代码),以在
渲染线程上处理音频,
从而支持自定义 AudioNode。
此
处理机制确保脚本代码与音频
图中的其他内置 AudioNode
同步执行。
为了实现
此机制,必须定义一对相互关联的对象:AudioWorkletNode
和
AudioWorkletProcessor。
前者表示主全局作用域的接口,
与其他 AudioNode
对象类似,而后者在名为 AudioWorkletGlobalScope
的特殊作用域内实现内部音频处理。
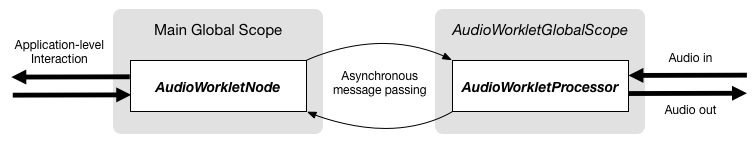
AudioWorkletNode
和
AudioWorkletProcessor
每个 BaseAudioContext
恰好拥有一个
AudioWorklet。
AudioWorklet
的
worklet 全局作用域类型为
AudioWorkletGlobalScope。
AudioWorklet
的
worklet 目标类型为
"audioworklet"。
通过 addModule(moduleUrl)
方法导入脚本,会在
AudioWorkletGlobalScope
下注册 AudioWorkletProcessor
的类定义。
对于导入的类构造函数以及由该构造函数创建的活动
实例,有两个内部
存储区域。
AudioWorklet
有一个内部槽:
-
节点名称到参数描述符映射,它是 一个包含 与节点名称到处理器 构造函数映射中完全相同字符串键集合的映射,这些键与相应的 parameterDescriptors 值关联。此内部存储 由于在渲染线程中调用
registerProcessor()方法而被填充。保证在 上下文的audioWorklet上调用addModule()所返回的 promise 解决之前完成填充。
// bypass-processor.js 脚本文件,在 AudioWorkletGlobalScope 上运行 class BypassProcessorextends AudioWorkletProcessor{ process( inputs, outputs) { // 单个输入,单个声道。 const input= inputs[ 0 ]; const output= outputs[ 0 ]; output[ 0 ]. set( input[ 0 ]); // 仅在存在活动输入时处理。 return false ; } }; registerProcessor( 'bypass-processor' , BypassProcessor);
// 主全局作用域 const context= new AudioContext(); context. audioWorklet. addModule( 'bypass-processor.js' ). then(() => { const bypassNode= new AudioWorkletNode( context, 'bypass-processor' ); });
在主全局
作用域中实例化 AudioWorkletNode
时,对应的 AudioWorkletProcessor
也会在 AudioWorkletGlobalScope
中创建。这两个对象
通过 § 2 处理模型中描述的异步消息传递进行通信。
1.32.3.
AudioWorkletGlobalScope
接口
此特殊执行上下文旨在使
音频数据能够在音频渲染线程中直接使用
脚本进行生成、处理和分析。用户提供的
脚本代码在此作用域中求值,以定义一个或多个
AudioWorkletProcessor
子类,这些子类随后用于
实例化 AudioWorkletProcessor,
它们与主作用域中的
AudioWorkletNode
形成 1:1 关联。
对于每个包含一个或多个
AudioWorkletNode
的
AudioContext,
恰好存在一个 AudioWorkletGlobalScope。
导入脚本的运行
由用户代理按照 [HTML] 中的定义执行。覆盖
[HTML] 中指定的默认行为,AudioWorkletGlobalScope
不得被
用户代理任意终止。
AudioWorkletGlobalScope
具有以下内部槽:
-
节点名称到处理器构造函数映射, 它是一个 存储 处理器名称 →
AudioWorkletProcessorConstructor实例键值对的映射。 最初此映射为空,并在调用registerProcessor()方法时填充。 -
待处理的处理器构造数据存储 由
AudioWorkletNode构造函数为实例化相应AudioWorkletProcessor而生成的临时数据。 待处理的处理器构造数据 包含以下项目:-
节点引用 最初为空。此存储用于保存从
AudioWorkletNode构造函数传输过来的AudioWorkletNode引用。 -
已传输端口 最初为空。此存储用于保存从
AudioWorkletNode构造函数传输过来的、已反序列化的MessagePort。
-
注: AudioWorkletGlobalScope
还可以包含由这些实例共享的任何其他数据
和代码。例如,多个
处理器可以共享一个定义波表或
脉冲响应的 ArrayBuffer。
注: 一个 AudioWorkletGlobalScope
与单个
BaseAudioContext
以及该上下文的单个音频渲染线程
相关联。这可以防止在并发线程中运行的全局
作用域代码发生数据竞争。
callback =AudioWorkletProcessorConstructor AudioWorkletProcessor (object ); [options Global =(Worklet ,AudioWorklet ),Exposed =AudioWorklet ]interface AudioWorkletGlobalScope :WorkletGlobalScope {undefined registerProcessor (DOMString name ,AudioWorkletProcessorConstructor processorCtor );readonly attribute unsigned long long currentFrame ;readonly attribute double currentTime ;readonly attribute float sampleRate ;readonly attribute unsigned long renderQuantumSize ;readonly attribute MessagePort port ; };
1.32.3.1. 属性
currentFrame, 类型为 unsigned long long,只读-
当前正在处理的音频块的当前帧。 此值必须等于
[[current frame]]内部槽在BaseAudioContext上的值。 currentTime, 类型为 double,只读-
当前正在处理的音频块的上下文时间。此值必须 等于
BaseAudioContext的currentTime属性值。 sampleRate, 类型为 float,只读-
关联的
BaseAudioContext的采样率。 renderQuantumSize, 类型为 unsigned long,只读-
关联的
BaseAudioContext的私有槽 渲染量子大小的值。 port, 类型为 MessagePort,只读-
一个
MessagePort, 连接到AudioWorklet上的端口。注: 在此
port的"message"事件上注册事件监听器的作者,应当在MessageChannel的任一端(AudioWorklet端或AudioWorkletGlobalScope端)调用close, 以便资源可以被 回收。
1.32.3.2. 方法
registerProcessor(name, processorCtor)-
注册一个派生自
AudioWorkletProcessor的类构造函数。调用registerProcessor(name, processorCtor)方法时,执行以下步骤。如果在任何 步骤中抛出异常,则中止剩余 步骤。-
如果 name 是空字符串, 抛出
NotSupportedError。 -
如果 name 已作为 节点名称到处理器 构造函数映射中的键存在, 抛出
NotSupportedError。 -
如果
IsConstructor(argument=processorCtor)的结果为false, 抛出TypeError。 -
令
prototype为Get(O=processorCtor, P="prototype")的结果。 -
令 parameterDescriptorsValue 为
Get(O=processorCtor, P="parameterDescriptors")的结果。 -
如果 parameterDescriptorsValue 不是
undefined, 则执行以下步骤:-
令 parameterDescriptorSequence 为将 parameterDescriptorsValue 转换为
sequence<AudioParamDescriptor>类型 IDL 值的结果。 -
令 paramNames 为一个空 Array。
-
对
parameterDescriptorSequence 中的每个 descriptor:
-
令 paramName 为 descriptor 中
name成员的值。如果 paramNames 已经 包含 paramName 值,则抛出NotSupportedError。 -
将 paramName 追加到 paramNames 数组。
-
令 defaultValue 为 descriptor 中
defaultValue成员的值。 -
令 minValue 为 descriptor 中
minValue成员的值。 -
令 maxValue 为 descriptor 中
maxValue成员的值。 -
如果表达式 minValue <= defaultValue <= maxValue 为 false, 抛出
InvalidStateError。
-
-
-
将键值对 name → processorCtor 追加到 关联的
AudioWorkletGlobalScope的节点名称到处理器 构造函数映射。 -
排入一个媒体元素任务,将键值对 name → parameterDescriptorSequence 追加到关联的
BaseAudioContext的节点名称到参数描述符 映射。
注: 类构造函数应当只 查找一次,因此它 在注册后没有机会动态更改。
AudioWorkletGlobalScope.registerProcessor(name, processorCtor) 方法的参数。 参数 类型 可为空 可选 说明 nameDOMString✘ ✘ 表示要注册的类构造函数的字符串键。此键用于 在构造 AudioWorkletNode时查找AudioWorkletProcessor的构造函数。processorCtorAudioWorkletProcessorConstructor✘ ✘ 一个扩展自 AudioWorkletProcessor的类构造函数。返回类型:undefined -
1.32.3.3.
AudioWorkletProcessor
的实例化
在 AudioWorkletNode
构造结束时,
将准备一个名为
处理器
构造数据
的结构,
以便进行跨线程传输。此
结构
包含以下
项目:
-
名称,它是一个
DOMString, 将在 节点名称到处理器构造函数映射 中查找。 -
节点,它是对已创建
AudioWorkletNode的引用。 -
选项,它是提供给
AudioWorkletNode的constructor的已序列化AudioWorkletNodeOptions。 -
端口,它是与
AudioWorkletNode的port配对的已序列化MessagePort。
当传输的数据到达 AudioWorkletGlobalScope
时,渲染线程
将调用以下算法:
-
令 processorName、nodeReference 和 serializedPort 分别为 constructionData 的 名称、 节点和 端口。
-
令 serializedOptions 为 constructionData 的 选项。
-
令 deserializedPort 为 StructuredDeserialize(serializedPort, 当前 Realm) 的结果。
-
令 deserializedOptions 为 StructuredDeserialize(serializedOptions, 当前 Realm) 的结果。
-
令 processorCtor 为在
AudioWorkletGlobalScope的 节点名称到处理器构造函数 映射中查找 processorName 的结果。 -
分别将 nodeReference 和 deserializedPort 存储到此
AudioWorkletGlobalScope的 待处理的处理器构造数据 的 节点引用 和 已传输端口中。 -
使用 deserializedOptions 参数从 processorCtor 构造回调函数。如果回调中抛出任何异常, 则向控制线程 排入一个任务,以在 nodeReference 上使用
ErrorEvent触发一个事件,名称为processorerror。 -
清空待处理的处理器构造数据 槽。
1.32.4.
AudioWorkletNode
接口
此接口表示一个用户定义的 AudioNode,
它
存在于控制线程上。
用户可以从
BaseAudioContext
创建 AudioWorkletNode,
并且这样的
节点可以与其他内置 AudioNode
连接,以形成
音频图。
| 属性 | 值 | 备注 |
|---|---|---|
numberOfInputs
| 1 | |
numberOfOutputs
| 1 | |
channelCount
| 2 | |
channelCountMode
| "max"
| |
channelInterpretation
| "speakers"
| |
| 尾部时间 | 参见备注 | 任何尾部时间 都由节点自身处理 |
每个 AudioWorkletProcessor
都有一个关联的 活动
源标志,初始值为 true。此标志会使
节点在没有任何已连接输入的情况下仍保留在内存中并执行音频处理。
从 AudioWorkletNode
发布的所有任务都会发布到
其关联 BaseAudioContext
的任务队列。
[Exposed =Window ]interface {AudioParamMap readonly maplike <DOMString ,AudioParam >; };
此接口具有由
readonly maplike 带来的 "entries"、"forEach"、"get"、"has"、"keys"、
"values"、@@iterator 方法以及 "size" getter。
[Exposed =Window ,SecureContext ]interface AudioWorkletNode :AudioNode {constructor (BaseAudioContext ,context DOMString ,name optional AudioWorkletNodeOptions = {});options readonly attribute AudioParamMap parameters ;readonly attribute MessagePort port ;attribute EventHandler onprocessorerror ; };
1.32.4.1. 构造函数
AudioWorkletNode(context, name, options)-
AudioWorkletNode.constructor() 方法的参数。 参数 类型 可为空 可选 说明 contextBaseAudioContext✘ ✘ 此新 AudioWorkletNode将关联的BaseAudioContext。nameDOMString✘ ✘ 一个字符串,它是 BaseAudioContext的节点名称到参数 描述符映射的键。optionsAudioWorkletNodeOptions✘ ✔ 此 AudioWorkletNode的可选初始参数值。调用构造函数时,用户代理必须在控制线程上 执行以下步骤:
当使用 context、nodeName、options 调用AudioWorkletNode构造函数时:-
如果 nodeName 不作为
BaseAudioContext的节点名称到参数 描述符映射中的键存在,则抛出InvalidStateError异常并中止这些步骤。 -
令 node 为 this 值。
-
以 context 和 options 作为 参数,初始化 AudioNode node。
-
使用 options 配置 node 的输入、输出和输出声道。 如果抛出任何异常,则中止剩余步骤。
-
令 messageChannel 为一个新的
MessageChannel。 -
令 nodePort 为 messageChannel 的
port1属性的值。 -
令 processorPortOnThisSide 为 messageChannel 的
port2属性的值。 -
令 serializedProcessorPort 为 StructuredSerializeWithTransfer(processorPortOnThisSide, « processorPortOnThisSide ») 的结果。
-
将 options 字典转换为 optionsObject。
-
令 serializedOptions 为 StructuredSerialize(optionsObject) 的结果。
-
将 node 的
port设置为 nodePort。 -
令 parameterDescriptors 为从节点名称到参数 描述符映射中检索 nodeName 的结果:
-
令 audioParamMap 为一个新的
AudioParamMap对象。 -
对于 parameterDescriptors 中的每个 descriptor:
-
令 paramName 为 descriptor 中
name成员的值。 -
令 audioParam 为一个新的
AudioParam实例,其中automationRate、defaultValue、minValue和maxValue的值等于 descriptor 上相应成员的值。 -
将键值对 paramName → audioParam 追加到 audioParamMap 的 条目中。
-
-
如果
parameterData存在于 options 上,则执行 以下步骤:-
令 parameterData 为
parameterData的值。 -
对于 parameterData 中的每个 paramName → paramValue:
-
如果 audioParamMap 上存在键为 paramName 的映射条目,则令 audioParamInMap 为 该条目。
-
将 audioParamInMap 的
value属性 设置为 paramValue。
-
-
-
将 node 的
parameters设置为 audioParamMap。
-
-
向 调用 相应
AudioWorkletProcessor的constructor排入一条控制 消息,并使用由以下内容组成的 处理器构造数据: nodeName、 node、 serializedOptions 和 serializedProcessorPort。
-
1.32.4.2. 属性
onprocessorerror, 类型为 EventHandler-
当处理器的
constructor、process方法 或任何用户定义的类方法抛出未处理的异常时,处理器将 排入一个媒体元素任务,以在关联的AudioWorkletNode上使用ErrorEvent触发一个事件,其名称为processorerror。ErrorEvent会在控制线程上创建,并使用其message、filename、lineno、colno属性进行适当初始化。请注意,一旦抛出未处理的异常,处理器 在其整个生命周期内都将输出静音。
parameters, 类型为 AudioParamMap, 只读-
parameters属性是一个AudioParam对象集合,这些对象具有相关联的名称。此 maplike 对象在实例化时由AudioWorkletProcessor类构造函数中的AudioParamDescriptor列表填充。 port, 类型为 MessagePort,只读-
每个
AudioWorkletNode都有关联的port,它是一个MessagePort。 它连接到对应AudioWorkletProcessor对象上的端口,从而允许AudioWorkletNode与其AudioWorkletProcessor之间进行双向通信。注: 在此
port的"message"事件上注册事件监听器的作者,应当在MessageChannel的任一端(在AudioWorkletProcessor端或AudioWorkletNode端)调用close,以便 资源可以被回收。
1.32.4.3.
AudioWorkletNodeOptions
AudioWorkletNodeOptions
字典可用于
初始化 AudioWorkletNode
实例中的属性。
dictionary AudioWorkletNodeOptions :AudioNodeOptions {unsigned long numberOfInputs = 1;unsigned long numberOfOutputs = 1;sequence <unsigned long >outputChannelCount ;record <DOMString ,double >parameterData ;object processorOptions ; };
1.32.4.3.1.
字典 AudioWorkletNodeOptions
成员
numberOfInputs, 类型为 unsigned long,默认值为1-
这用于初始化
AudioNode的numberOfInputs属性值。 numberOfOutputs, 类型为 unsigned long,默认值为1-
这用于初始化
AudioNode的numberOfOutputs属性值。 outputChannelCount, 类型为sequence<unsigned long>-
此数组用于配置 每个输出中的声道数量。
parameterData, 类型为 record<DOMString, double>-
这是一个用户定义的键值对列表,用于 设置
AudioWorkletNode中名称匹配的AudioParam的初始value。 processorOptions, 类型为 object-
它保存任何用户定义的数据,这些数据可用于初始化 与
AudioWorkletNode关联的AudioWorkletProcessor实例中的自定义属性。
1.32.4.3.2.
使用 AudioWorkletNodeOptions
配置声道
以下算法描述了如何使用 AudioWorkletNodeOptions
来
配置各种声道配置。
-
令 node 为传递给此算法的一个
AudioWorkletNode实例。 -
如果
numberOfInputs和numberOfOutputs均为零, 则抛出NotSupportedError并中止剩余步骤。 -
如果
outputChannelCount存在,-
如果
outputChannelCount中的任何值为零 或大于实现支持的最大声道数,则抛出NotSupportedError并中止 剩余步骤。 -
如果
outputChannelCount的长度 不等于numberOfOutputs, 则抛出IndexSizeError并中止剩余 步骤。 -
如果
numberOfInputs和numberOfOutputs均为 1, 则将 node 输出的声道数设置为outputChannelCount中的唯一值。 -
否则,将 node 的第 k 个输出 的声道数设置为
outputChannelCount序列的第 k 个元素,然后返回。
-
-
如果
outputChannelCount不存在,-
如果
numberOfInputs和numberOfOutputs均为 1, 则将 node 输出的初始声道数设置为 1 并返回。注: 对于这种情况,输出 声道数将在运行时 根据输入和
channelCountMode动态更改为 computedNumberOfChannels。 -
否则,将 node 每个输出的声道数设置为 1 并返回。
-
1.32.5.
AudioWorkletProcessor
接口
此接口表示在音频
渲染线程上运行的音频处理代码。
它存在于 AudioWorkletGlobalScope
中,并且类的定义体现了实际的音频处理。
请注意,AudioWorkletProcessor
的构造只能作为
AudioWorkletNode
构造的结果发生。
[Exposed =AudioWorklet ]interface AudioWorkletProcessor {constructor ();readonly attribute MessagePort port ; };callback AudioWorkletProcessCallback =boolean (FrozenArray <FrozenArray <Float32Array >>,inputs FrozenArray <FrozenArray <Float32Array >>,outputs object );parameters
AudioWorkletProcessor
有两个内部槽:
[[node reference]]-
对关联的
AudioWorkletNode的引用。 [[callable process]]-
一个布尔标志,表示 process() 是否是可调用的有效函数。
1.32.5.1. 构造函数
AudioWorkletProcessor()-
调用
AudioWorkletProcessor的构造函数时, 在渲染线程上执行以下步骤。-
令 nodeReference 为在当前
AudioWorkletGlobalScope的 待处理的处理器构造 数据中查找 节点引用 的结果。如果该槽 为空,则抛出TypeError异常。 -
令 processor 为 this 值。
-
将 processor 的
[[node reference]]设置为 nodeReference。 -
将 processor 的
[[callable process]]设置为true。 -
令 deserializedPort 为从 待处理的处理器构造 数据中查找 已传输 端口 的结果。
-
将 processor 的
port设置为 deserializedPort。 -
清空待处理的处理器构造 数据 槽。
-
1.32.5.2. 属性
port, 类型为 MessagePort,只读-
每个
AudioWorkletProcessor都有关联的port,它是一个MessagePort。 它连接到 对应AudioWorkletNode对象上的端口, 从而允许AudioWorkletNode与其AudioWorkletProcessor之间进行双向通信。注: 在此
port的"message"事件上注册事件监听器的作者,应当在MessageChannel的任一端(在AudioWorkletProcessor端或AudioWorkletNode端)调用close,以便 资源可以被回收。
1.32.5.3.
回调 AudioWorkletProcessCallback
用户可以通过扩展
AudioWorkletProcessor
来定义自定义音频处理器。
子类必须定义一个名为
process()
的 AudioWorkletProcessCallback,
用于实现音频处理
算法,并且可以具有一个名为
parameterDescriptors
的静态属性,它是
AudioParamDescriptor
的可迭代对象。
process() 回调函数按照 渲染图时所规定的方式处理。
AudioWorkletProcessor
所关联
AudioWorkletNode
的生命周期。
此生命周期策略可以支持内置节点中存在的 多种方法,包括以下内容:
-
转换其输入,并且仅在 存在已连接输入和/或脚本引用时处于活动状态的节点。此类 节点应当从 process() 返回
false,从而允许 已连接输入的存在与否决定AudioWorkletNode是否正在 主动 处理。 -
转换其输入,但在其输入断开连接后仍会在 一段尾部时间内保持活动状态的节点。在 这种情况下,在发现
inputs包含零个声道后的一段时间内, process() 应当返回true。可以从全局作用域的currentTime获取当前时间,以 测量此尾部时间间隔的开始和结束,或者 也可以根据处理器的内部状态 动态计算该间隔。 -
作为输出源的节点,通常具有 生命周期。此类节点应当从 process() 返回
true,直到它们 不再产生输出为止。
请注意,前面的定义意味着,当
process()
的实现未提供
返回值时,其效果与返回
false 相同(因为有效返回值是 falsy
值 undefined)。
对于任何仅在具有
活动输入时才处于活动状态的 AudioWorkletProcessor,
这是合理的行为。
下面的示例展示了如何在
AudioWorkletProcessor
中定义和使用 AudioParam。
class MyProcessorextends AudioWorkletProcessor{ static get parameterDescriptors() { return [{ name: 'myParam' , defaultValue: 0.5 , minValue: 0 , maxValue: 1 , automationRate: "k-rate" }]; } process( inputs, outputs, parameters) { // 获取第一个输入和输出。 const input= inputs[ 0 ]; const output= outputs[ 0 ]; const myParam= parameters. myParam; // 用于单个输入和输出的简单放大器。请注意, // automationRate 为 "k-rate",因此每个渲染量子 // 在索引 [0] 处只有一个值。 for ( let channel= 0 ; channel< output. length; ++ channel) { for ( let i= 0 ; i< output[ channel]. length; ++ i) { output[ channel][ i] = input[ channel][ i] * myParam[ 0 ]; } } } }
1.32.5.3.1.
回调 AudioWorkletProcessCallback
参数
下面描述 AudioWorkletProcessCallback
函数的参数。
通常,
inputs
和
outputs
数组将在调用之间被复用,
以避免进行内存分配。但是,如果
拓扑发生变化,例如输入或
输出中的声道数量发生变化,则会重新分配新数组。如果
inputs
或
outputs
数组的任何部分被
传输,也会重新分配新数组。
inputs, 类型为FrozenArray<FrozenArray<Float32Array>>-
由用户代理提供的、来自传入连接的输入音频缓冲区。
inputs[n][m]是一个Float32Array, 包含第 \(n\) 个输入的第 \(m\) 个声道的音频采样。虽然输入数量在构造时固定, 但声道数量可以根据 computedNumberOfChannels 动态更改。如果在当前渲染量子中,没有主动处理的
AudioNode连接到AudioWorkletNode的第 \(n\) 个输入,则inputs[n]的内容是一个空数组, 表示有零个输入声道可用。这是inputs[n]的元素数量可以为零的唯一情况。 outputs, 类型为FrozenArray<FrozenArray<Float32Array>>-
将由用户代理使用的输出音频缓冲区。
outputs[n][m]是一个Float32Array对象,其中包含第 \(n\) 个输出的第 \(m\) 个声道的音频采样。每个Float32Array都以零填充。仅当节点具有 单个输出时,输出中的声道数量才会与 computedNumberOfChannels 匹配。 parameters, 类型为object-
一个 name → parameterValues 的有序映射。
parameters["name"]返回 parameterValues,它是一个FrozenArray<Float32Array>, 其中包含名为 name 的AudioParam的自动化值。对于每个数组,该数组包含参数在渲染量子 中所有帧的 computedValue。 但是,如果此渲染量子期间没有安排自动化,则数组可以具有长度 1, 其数组元素为
AudioParam在该渲染 量子中的常量值。此对象按照以下步骤被冻结
-
令 parameter 为名称和参数值的有序 映射。
-
SetIntegrityLevel(parameter, frozen)
算法中计算得到的这个已冻结有序映射会传递给
parameters参数。注: 这意味着该对象不能被修改, 因此除非数组长度发生变化, 否则可以在连续调用中使用同一个对象。
-
1.32.5.4.
AudioParamDescriptor
AudioParamDescriptor
字典用于
为 AudioWorkletNode
中使用的
AudioParam
对象指定属性。
dictionary AudioParamDescriptor {required DOMString name ;float defaultValue = 0;float minValue = -3.4028235e38;float maxValue = 3.4028235e38;AutomationRate automationRate = "a-rate"; };
1.32.5.4.1.
字典 AudioParamDescriptor
成员
这些成员的值存在约束。有关这些约束,请参阅处理 AudioParamDescriptor 的算法。
automationRate, 类型为 AutomationRate,默认值为"a-rate"-
表示默认自动化速率。
defaultValue, 类型为 float,默认值为0-
表示参数的默认值。
maxValue, 类型为 float,默认值为3.4028235e38-
表示最大值。
minValue, 类型为 float,默认值为-3.4028235e38-
表示最小值。
name, 类型为 DOMString-
表示参数的名称。
1.32.6. AudioWorklet 事件序列
下图说明了相对于
AudioWorklet
发生的理想化事件序列:
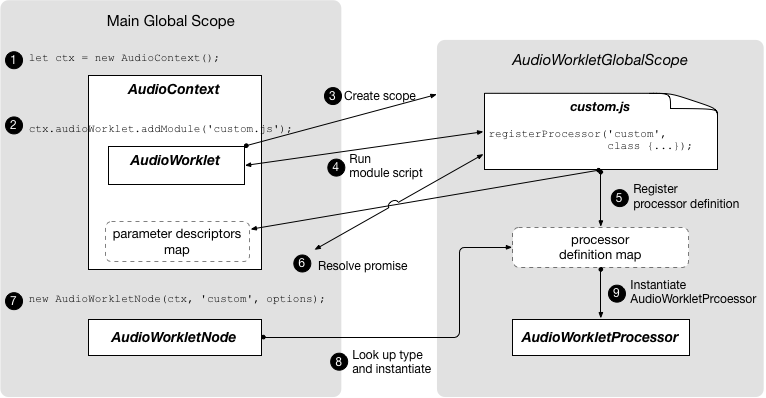
AudioWorklet
序列
图中描绘的步骤是涉及创建
AudioContext
及其关联
AudioWorkletGlobalScope
的一种可能事件序列,随后创建
AudioWorkletNode
及其关联的
AudioWorkletProcessor。
-
创建一个
AudioContext。 -
在主作用域中,请求
context.audioWorklet添加一个脚本模块。 -
由于尚不存在任何作用域,因此创建一个新的
AudioWorkletGlobalScope并与该上下文关联。这是AudioWorkletProcessor类定义将被求值的全局作用域。(在后续调用中,将使用 此前创建的作用域。) -
在新创建的全局作用域中运行导入的脚本。
-
作为运行导入脚本的一部分,一个
AudioWorkletProcessor会在AudioWorkletGlobalScope中以某个键(上图中的"custom")注册。 这会同时填充全局作用域和AudioContext中的映射。 -
addModule()调用的 promise 被解决。 -
在主作用域中,使用 用户指定的键以及 一个选项字典创建
AudioWorkletNode。 -
作为节点创建的一部分,此键用于查找 要实例化的正确
AudioWorkletProcessor子类。 -
使用同一选项 字典的结构化克隆实例化
AudioWorkletProcessor子类的实例。此实例与先前创建的AudioWorkletNode配对。
1.32.7. AudioWorklet 示例
1.32.7.1. BitCrusher 节点
位深压缩是一种通过量化采样值(模拟
更低位深)以及量化时间分辨率
(模拟更低采样率)来降低音频
流质量的机制。此示例展示了如何在
AudioWorkletProcessor
内部使用 AudioParam
(在此情况下,作为
a-rate 处理)。
const context= new AudioContext(); context. audioWorklet. addModule( 'bitcrusher.js' ). then(() => { const osc= new OscillatorNode( context); const amp= new GainNode( context); // 创建一个 worklet 节点。'BitCrusher' 标识 // 在导入 bitcrusher.js 时先前注册的 // AudioWorkletProcessor。选项会自动 // 初始化对应名称的 AudioParam。 const bitcrusher= new AudioWorkletNode( context, 'bitcrusher' , { parameterData: { bitDepth: 8 } }); osc. connect( bitcrusher). connect( amp). connect( context. destination); osc. start(); });
class Bitcrusherextends AudioWorkletProcessor{ static get parameterDescriptors() { return [{ name: 'bitDepth' , defaultValue: 12 , minValue: 1 , maxValue: 16 }, { name: 'frequencyReduction' , defaultValue: 0.5 , minValue: 0 , maxValue: 1 }]; } constructor () { super (); this . _phase= 0 ; this . _lastSampleValue= 0 ; } process( inputs, outputs, parameters) { const input= inputs[ 0 ]; const output= outputs[ 0 ]; const bitDepth= parameters. bitDepth; const frequencyReduction= parameters. frequencyReduction; if ( bitDepth. length> 1 ) { for ( let channel= 0 ; channel< output. length; ++ channel) { for ( let i= 0 ; i< output[ channel]. length; ++ i) { let step= Math. pow( 0.5 , bitDepth[ i]); // 使用取模进行索引,以处理 // frequencyReduction 数组长度为 1 的情况。 this . _phase+= frequencyReduction[ i% frequencyReduction. length]; if ( this . _phase>= 1.0 ) { this . _phase-= 1.0 ; this . _lastSampleValue= step* Math. floor( input[ channel][ i] / step+ 0.5 ); } output[ channel][ i] = this . _lastSampleValue; } } } else { // 因为我们知道 bitDepth 在此次调用中是常量, // 所以可以将 step 的计算提到循环外, // 从而节省许多操作。 const step= Math. pow( 0.5 , bitDepth[ 0 ]); for ( let channel= 0 ; channel< output. length; ++ channel) { for ( let i= 0 ; i< output[ channel]. length; ++ i) { this . _phase+= frequencyReduction[ i% frequencyReduction. length]; if ( this . _phase>= 1.0 ) { this . _phase-= 1.0 ; this . _lastSampleValue= step* Math. floor( input[ channel][ i] / step+ 0.5 ); } output[ channel][ i] = this . _lastSampleValue; } } } // 无需返回值;此节点的生命周期仅取决于其 // 输入连接。 } }; registerProcessor( 'bitcrusher' , Bitcrusher);
注: 在 AudioWorkletProcessor
类的定义中,如果
作者提供的构造函数具有不是
this 的显式返回值,或者未正确调用 super(),
则会抛出
InvalidStateError。
1.32.7.2. VU 表节点
这个简单的声级表示例进一步说明了
如何创建一个
AudioWorkletNode
子类,使其像原生 AudioNode
一样工作,接受
构造函数选项,并封装
AudioWorkletNode
与
AudioWorkletProcessor
之间的线程间通信(异步)。
此节点不使用任何输出。
/* vumeter-node.js:主全局作用域 */ export default class VUMeterNodeextends AudioWorkletNode{ constructor ( context, updateIntervalInMS) { super ( context, 'vumeter' , { numberOfInputs: 1 , numberOfOutputs: 0 , channelCount: 1 , processorOptions: { updateIntervalInMS: updateIntervalInMS|| 16.67 } }); // AudioWorkletNode 中的状态 this . _updateIntervalInMS= updateIntervalInMS; this . _volume= 0 ; // 处理来自 AudioWorkletProcessor 的更新值 this . port. onmessage= event=> { if ( event. data. volume) this . _volume= event. data. volume; } this . port. start(); } get updateInterval() { return this . _updateIntervalInMS; } set updateInterval( updateIntervalInMS) { this . _updateIntervalInMS= updateIntervalInMS; this . port. postMessage({ updateIntervalInMS: updateIntervalInMS}); } draw() { // 根据音量值绘制 VU 表 // 每隔 |this._updateIntervalInMS| 毫秒绘制一次。 } };
/* vumeter-processor.js:AudioWorkletGlobalScope */ const SMOOTHING_FACTOR= 0.9 ; const MINIMUM_VALUE= 0.00001 ; registerProcessor( 'vumeter' , class extends AudioWorkletProcessor{ constructor ( options) { super (); this . _volume= 0 ; this . _updateIntervalInMS= options. processorOptions. updateIntervalInMS; this . _nextUpdateFrame= this . _updateIntervalInMS; this . port. onmessage= event=> { if ( event. data. updateIntervalInMS) this . _updateIntervalInMS= event. data. updateIntervalInMS; } } get intervalInFrames() { return this . _updateIntervalInMS/ 1000 * sampleRate; } process( inputs, outputs, parameters) { const input= inputs[ 0 ]; // 请注意,输入将被降混为单声道;但是,如果没有输入 // 连接,则会传入零个声道。 if ( input. length> 0 ) { const samples= input[ 0 ]; let sum= 0 ; let rms= 0 ; // 计算平方和。 for ( let i= 0 ; i< samples. length; ++ i) sum+= samples[ i] * samples[ i]; // 计算 RMS 电平并更新音量。 rms= Math. sqrt( sum/ samples. length); this . _volume= Math. max( rms, this . _volume* SMOOTHING_FACTOR); // 更新音量属性并与主线程同步。 this . _nextUpdateFrame-= samples. length; if ( this . _nextUpdateFrame< 0 ) { this . _nextUpdateFrame+= this . intervalInFrames; this . port. postMessage({ volume: this . _volume}); } } // 如果音量高于阈值,则继续处理,以便 // 断开输入不会立即导致仪表停止 // 计算其平滑值。 return this . _volume>= MINIMUM_VALUE; } });
/* index.js:主全局作用域,入口点 */ import VUMeterNodefrom './vumeter-node.js' ; const context= new AudioContext(); context. audioWorklet. addModule( 'vumeter-processor.js' ). then(() => { const oscillator= new OscillatorNode( context); const vuMeterNode= new VUMeterNode( context, 25 ); oscillator. connect( vuMeterNode); oscillator. start(); function drawMeter() { vuMeterNode. draw(); requestAnimationFrame( drawMeter); } drawMeter(); });
1.33.
AudioPlaybackStats
接口
提供通过
AudioContext
播放的音频的音频欠载和延迟统计信息。
当音频未能及时传递到播放设备时,会导致 音频欠载。这会导致已播放信号出现不连续,从而产生 可听见的“咔哒”声,通常称为“故障”。这些故障会损害 用户体验,因此,如果发生这些情况, 应用程序能够检测到它们并可能 采取一些措施改善播放会很有用。
AudioPlaybackStats
是一个专用于音频统计报告的对象;
它通过
AudioDestinationNode
及其关联的音频输出设备,
报告
AudioContext
播放路径的音频欠载和播放延迟统计信息。这使
应用程序能够测量欠载,欠载可能由于
以下原因发生:
-
音频图对系统而言过于复杂,无法及时生成音频, 从而导致欠载。
-
某些外部问题导致欠载。此类问题的示例包括:
-
另一个向同一播放设备播放音频的程序发生故障。
-
系统整体 CPU 过载。
-
系统由于热节流而过载。
-
-
欠载 帧是由输出设备播放、但并非由
AudioContext提供的音频帧。 当播放路径未能及时向输出设备提供音频帧时就会发生这种情况, 在这种情况下,它仍然必须播放某些内容。注: 欠载帧通常是静音。
[Exposed =Window ,SecureContext ]interface AudioPlaybackStats {readonly attribute double underrunDuration ;readonly attribute unsigned long underrunEvents ;readonly attribute double totalDuration ;readonly attribute double averageLatency ;readonly attribute double minimumLatency ;readonly attribute double maximumLatency ;undefined resetLatency (); [Default ]object (); };toJSON
每个 AudioContext
恰好拥有一个 AudioPlaybackStats。
AudioPlaybackStats
具有以下内部槽:
[[audio context]]-
此
AudioPlaybackStats实例所关联的AudioContext。 创建时初始化为所属的AudioContext。 [[underrun duration]]-
截至上次统计信息更新时,在
[[audio context]]播放中发生的所有欠载事件的总持续时间,一个 double。 初始化为 0。 [[underrun events]]-
截至上次统计信息更新时,在
[[audio context]]播放中发生的欠载事件总数,一个 int。 初始化为 0。 [[total duration]]-
截至上次统计信息更新时,
[[audio context]]播放中所有帧的总持续时间(以秒为单位),一个 double,定义为[[underrun duration]]+currentTime [[average latency]]-
[[audio context]]在当前跟踪的时间间隔内的平均音频输出延迟,一个 double。 [[minimum latency]]-
[[audio context]]在当前跟踪的时间间隔内的最小音频输出延迟,一个 double。 初始化为 0。 [[maximum latency]]-
[[audio context]]在当前跟踪的时间间隔内的最大音频输出延迟,一个 double。 初始化为 0。 [[latency reset time]]-
上次重置延迟统计信息的时间,一个 double。它位于
currentTime的时钟域中。 初始化为 0。当前跟踪的时间间隔是从[[latency reset time]]到当前currentTime的时间间隔。
1.33.1. 属性
注: 这些属性每秒最多更新一次,并且仅在 特定条件下更新。有关详细信息,请参阅 § 1.33.3 更新统计信息和 § 1.33.4.2 缓解措施。
underrunDuration, 类型为 double,只读-
返回
[[underrun duration]]内部槽的值。注: 此指标可以与
totalDuration一起使用,以 计算已播放媒体中并非由AudioContext提供的部分所占百分比。
underrunEvents, 类型为 unsigned long,只读-
返回
[[underrun events]]内部槽的值。
totalDuration, 类型为 double,只读-
返回
[[total duration]]内部槽的值。
averageLatency, 类型为 double,只读-
返回
[[average latency]]内部槽的值。
minimumLatency, 类型为 double,只读-
返回
[[minimum latency]]内部槽的值。
maximumLatency, 类型为 double,只读-
返回
[[maximum latency]]内部槽的值。
1.33.2. 方法
resetLatency()-
将跟踪延迟统计信息的时间间隔起点设置为 当前时间。 调用
resetLatency时,运行以下步骤:-
令 currentLatency 为
[[audio context]]播放的最后一帧的播放延迟, 如果尚未播放任何帧,则为 0。 -
将
[[average latency]]设置为 currentLatency。 -
将
[[minimum latency]]设置为 currentLatency。 -
将
[[maximum latency]]设置为 currentLatency。
1.33.3. 更新统计信息
-
如果
[[audio context]]未处于运行状态,则中止这些步骤。 -
令 canUpdate 为 false。
-
令 document 为当前 this 的相关全局对象的关联 Document。 如果 document 是完全活动的,并且 document 的 可见性状态为
"visible",则将 canUpdate 设置为 true。 -
令 permission 为与 "microphone" 访问关联权限的权限状态。 如果 permission 为 "granted",则将 canUpdate 设置为 true。
-
如果 canUpdate 为 false,则中止这些步骤。
-
将
[[underrun duration]]设置为自构造以来[[audio context]]播放中发生的所有欠载事件 的总持续时间(以秒为单位)。 -
将
[[underrun events]]设置为自[[audio context]]构造以来其播放中发生的 欠载事件总数。 -
将
[[total duration]]设置为[[underrun duration]]+[[audio context]].currentTime。 -
将
[[average latency]]设置为[[audio context]]在当前跟踪的时间间隔内的平均播放延迟(以秒为单位)。 -
将
[[minimum latency]]设置为[[audio context]]在当前跟踪的时间间隔内的最小播放延迟(以秒为单位)。 -
将
[[maximum latency]]设置为[[audio context]]在当前跟踪的时间间隔内的最大播放延迟(以秒为单位)。
1.33.4.
AudioPlaybackStats
的隐私考量
1.33.4.1. 风险
音频欠载信息可能被用于在两个协作站点之间形成 跨站隐蔽信道。 一个站点可以通过故意造成音频故障 (例如,通过导致非常高的 CPU 使用率)来传输信息,而另一个站点 可以检测这些故障。注: 此隐蔽信道取决于特定的系统 特性。 它通常需要一个共享的串行化点(例如操作系统或浏览器的 音频混音器),以及从该点看实际上同步的回调, 且不存在会抹平负载峰值的中间缓冲。
1.33.4.2. 缓解措施
为抑制此类隐蔽信道的使用,此 API 实现了以下 缓解措施。-
API 返回的值每秒不得更新超过一次。
-
API 必须限制为至少满足以下 条件之一的站点:
-
该站点已获得 getUserMedia 权限。
注: 理由是,如果一个站点 已获得 getUserMedia 权限,它就可以通过使用麦克风接收故障信息或高效通信, 从而使访问
AudioPlaybackStats所提供的信息变得多余。这些方式 包括通过麦克风信号中的间隙检测故障,或 使用人耳不可听见的正弦波进行通信。如果将来麦克风访问 在这方面变得更安全,则应重新考虑此条件。 -
文档是完全活动的,并且其 可见性状态为
"visible"。注: 假设两个协作 站点都没有麦克风权限, 此条件确保接收隐蔽信号的站点 必须可见,从而限制隐蔽 信道能够使用的条件。这使得站点在不可见时 无法使用隐蔽信道彼此通信。
-
2. 处理模型
2.1. 背景
本节为非规范性内容。
要求低延迟的实时音频系统通常 使用回调函数实现,其中操作 系统会在需要计算更多音频以保持播放不中断时回调程序。 理想情况下,此类回调在高优先级线程上调用 (通常是系统中优先级最高的线程)。 这意味着处理音频的程序只会从此回调中执行代码。 跨越线程边界,或者在渲染线程与回调之间添加一些缓冲, 自然会增加延迟,或使系统更容易出现故障。
因此,在 Web 平台上执行异步 操作的传统方式——事件循环——在这里不起作用, 因为线程并不是持续执行的。此外, 传统执行上下文(Window 和 Worker)中提供了 大量不必要且可能阻塞的操作, 这不利于达到可接受的 性能水平。
此外,Worker 模型使脚本执行上下文
必须创建专用线程,而所有 AudioNode
通常共享同一个执行上下文。
注: 本节规定最终结果应当 是什么样,而不是 应当如何实现。特别是,实现者可以不使用消息 队列,而使用在线程之间共享的内存,只要 内存操作不会被重新排序即可。
2.2. 控制线程和渲染线程
Web Audio API 必须使用控制线程 和渲染线程实现。
控制线程是
实例化
AudioContext
的线程,也是作者
操作音频图的线程,也就是说,是调用
BaseAudioContext
上操作的线程。渲染
线程
是实际计算音频输出的线程,
以响应来自控制线程的调用。如果为
AudioContext
计算音频,它可以是
基于回调的实时音频线程;如果为 OfflineAudioContext
计算音频,则可以是普通线程。
从控制 线程到渲染 线程的通信通过传递控制消息完成。 反方向的通信使用常规事件循环 任务完成。
每个 AudioContext
都有一个控制
消息队列,
它是一个控制消息列表,这些消息是
在渲染线程上运行的操作。
排入一条控制消息
意味着将该消息添加到 BaseAudioContext
的控制消息队列末尾。
注: 例如,在
AudioBufferSourceNode
source 上成功调用
start(),会向关联 BaseAudioContext
的控制消息
队列添加一条控制
消息。
控制消息在 控制消息 队列中按插入时间排序。因此,最旧消息是位于 控制消息队列最前面的消息。
2.3. 异步操作
调用 AudioNode
上的方法实际上是异步的,并且
必须分两个阶段完成:同步部分和异步
部分。对于每个方法,部分执行发生在
控制线程上(例如,
在参数无效时抛出异常),另一部分发生在渲染
线程上(例如,更改 AudioParam
的值)。
在对 AudioNode
和
BaseAudioContext
上每个操作的描述中,
同步部分用 ⌛ 标记。所有
其他操作都按照 [HTML] 中的说明
并行执行。
同步部分在控制线程上执行,并且 立即发生。如果失败,则方法执行会中止, 并可能抛出异常。如果成功,则将一条编码了要在 渲染线程上执行操作的 控制 消息,排入此渲染线程的 控制消息 队列。
同步和异步部分相对于其他 事件的顺序必须相同:给定两个操作 A 和 B,其各自的同步和异步部分分别为 ASync 和 AAsync,以及 BSync 和 BAsync,如果 A 发生在 B 之前,则 ASync 发生在 BSync 之前,并且 AAsync 发生在 BAsync 之前。换言之,同步和 异步部分不能重新排序。
2.4. 支持的采样率
实现必须支持 3000 Hz 到 768000 Hz(含)之间的采样率。
如果指定的采样率超出此
范围,则必须抛出 NotSupportedError。
2.5. 支持的渲染量子大小
实现必须支持 1 个采样帧到上下文采样率 6 倍(含)之间的 [[render quantum size]],
如果上下文采样率的 6 倍不是整数,
则向下舍入到最接近的整数。如果指定的
[[render quantum size]]
超出此范围,
则必须抛出
NotSupportedError。
ScriptProcessorNode
接口的应用程序,其最大
缓冲区大小为 16384,最低支持的采样率为 3000 Hz。
对于上下文采样率 3000 Hz,支持的范围为 [1,
18000]。更高的采样率将具有更高的上限。
2.6. 渲染音频图
音频图渲染以采样帧块的形式完成,每个
块的大小在 BaseAudioContext
的整个生命周期内保持不变。
一个块中的采样帧数量称为 渲染量子大小,该块
本身称为渲染
量子。其默认值为 128,并且可以
通过设置 renderSizeHint
进行配置。
在给定线程上原子地发生的操作, 只有在另一个线程上没有其他原子 操作正在运行时才能执行。
从具有控制消息
队列
Q 的 BaseAudioContext
G 渲染一个音频块的算法由多个步骤组成,并在
渲染图算法中进一步详细说明。
AudioContext
的渲染线程
由一个
系统级
音频回调驱动,该回调
以固定时间间隔周期性调用。每次调用都有一个系统级音频回调缓冲区
大小,它是一个可变的采样帧数量,必须在下一个系统级音频回调到来之前
及时计算完成。
为每个系统级音频
回调计算一个负载值,
方法是用其执行持续时间除以
系统级
音频回调缓冲区大小除以 sampleRate
的结果。
理想情况下,负载值低于 1.0, 这意味着渲染音频所需的时间 少于播放它所需的时间。当此负载值大于 1.0 时,会发生音频缓冲区 欠载:系统无法足够快地渲染音频以满足实时播放。
请注意,系统级音频回调和负载
值的概念不适用于 OfflineAudioContext。
音频回调也作为任务排入控制消息队列。用户代理必须执行
以下算法来处理渲染量子,以通过填充请求的缓冲区大小完成此任务。
除控制消息
队列之外,每个 AudioContext
还有一个常规任务
队列,称为其关联任务队列,
用于从控制线程发布到渲染线程的任务。在处理完一个渲染量子后,
还会额外执行一次微任务检查点,以运行在执行
AudioWorkletProcessor
的 process 方法期间可能排入的任何微任务。
从 AudioWorkletNode
发布的所有任务都会发布到其关联 BaseAudioContext
的关联任务队列。
-
将
BaseAudioContext的内部槽[[current frame]]设置为 0。同时将currentTime设置为 0。
-
令 render result 为
false。 -
处理控制消息队列。
-
处理
BaseAudioContext的关联任务队列。-
令 task queue 为
BaseAudioContext的关联任务队列。 -
令 task count 为 task queue 中的任务数量
-
当 task count 不等于 0 时,执行以下步骤:
-
令 oldest task 为 task queue 中第一个可运行任务, 并将其从 task queue 中移除。
-
将渲染循环当前正在运行的任务设置为 oldest task。
-
执行 oldest task 的步骤。
-
将渲染循环当前正在运行的任务重新设置为
null。 -
递减 task count
-
执行一次微任务检查点。
-
-
-
处理一个渲染量子。
-
如果
BaseAudioContext的[[rendering thread state]]不是running,则返回 false。 -
对要处理的
BaseAudioContext的AudioNode排序。-
令 ordered node list 为一个空的
AudioNode和AudioListener列表。 当此排序算法终止时,它将包含一个有序的AudioNode列表以及AudioListener。 -
令 nodes 为此
BaseAudioContext创建且仍然存活的所有节点的集合。 -
将
AudioListener添加到 nodes。 -
令 cycle breakers 为一个空的
DelayNode集合。 它将 包含所有属于循环一部分的DelayNode。 -
对于 nodes 中的每个
AudioNodenode:-
如果 node 是属于循环一部分的
DelayNode, 则将其添加到 cycle breakers,并从 nodes 中移除。
-
-
对于 cycle breakers 中的每个
DelayNodedelay:-
令 delayWriter 和 delayReader 分别为 delay 的 DelayWriter 和DelayReader。 将 delayWriter 和 delayReader 添加到 nodes。断开 delay 与其所有输入和 输出的连接。
注: 这会打破 循环:如果一个
DelayNode位于 循环中,则可以分别考虑它的两端,因为延迟线 在循环中时不能小于一个渲染量子。
-
-
将 nodes 中的所有元素视为未标记。当 nodes 中存在未标记元素时:
-
在 nodes 中选择一个元素 node。
-
访问 node。
-
-
反转 ordered node list 的顺序。
-
-
为此块计算 值:
AudioListener的AudioParam的值。 -
对于 ordered node list 中的每个
AudioNode:-
对于此
AudioNode的每个AudioParam, 执行以下步骤:-
如果此
AudioParam有任何AudioNode与之连接,则将所有连接到此AudioParam的AudioNode提供用于读取的缓冲区 求和, 将得到的缓冲区降混为单声道, 并将此缓冲区称为 输入 AudioParam 缓冲区。 -
计算值,即此
AudioParam在此块中的值。 -
排入一条 控制消息,以按照 § 1.6.3 值的计算 设置此
AudioParam的[[current value]]槽。
-
-
如果此
AudioNode的输入连接了任何AudioNode, 则将所有连接到此AudioNode的AudioNode提供用于读取的缓冲区 求和。 得到的缓冲区称为 输入缓冲区。 对其进行升混或降混, 以匹配此AudioNode的输入声道数量。 -
如果此
AudioNode是AudioWorkletNode, 则执行以下子步骤:-
令 processor 为
AudioWorkletNode的关联AudioWorkletProcessor实例。 -
令 O 为与 processor 对应的 ECMAScript 对象。
-
令 processCallback 为一个未初始化变量。
-
令 completion 为一个未初始化变量。
-
令 getResult 为 Get(O, "process")。
-
如果 getResult 是一个 突然完成,则将 completion 设置为 getResult,并跳转到标记为 返回的步骤。
-
将 processCallback 设置为 getResult.[[Value]]。
-
如果 ! IsCallable(processCallback) 为
false, 则:-
将 completion 设置为新的 Completion {[[Type]]: throw, [[Value]]: 一个新创建的 TypeError 对象, [[Target]]: empty}。
-
跳转到标记为 返回的步骤。
-
-
将
[[callable process]]设置为true。 -
执行以下子步骤:
-
令 args 为一个由
inputs、outputs和parameters组成的 Web IDL 参数列表。 -
令 esArgs 为将 args 转换为 ECMAScript 参数 列表的结果。
-
令 callResult 为 Call(processCallback, O, esArgs)。此操作使用 esArgs 计算一个音频 块。 函数调用成功后,会将一个包含通过
outputs传递的Float32Array元素副本的缓冲区 提供用于 读取。 在此调用中解决的任何Promise都会排入AudioWorkletGlobalScope中的微任务队列。 -
如果 callResult 是一个 突然完成,则将 completion 设置为 callResult,并跳转到标记为 返回的步骤。
-
-
返回:此时 completion 将被设置为一个 ECMAScript 完成 值。
-
如果 completion 是一个 突然完成:
-
将
[[callable process]]设置为false。 -
将 processor 的活动源标志 设置为
false。 -
向控制线程 排入一个任务,以在关联的
AudioWorkletNode上使用ErrorEvent触发一个事件, 名称为processorerror。
-
-
-
-
原子地 执行以下步骤:
-
将
[[current frame]]增加渲染量子大小。 -
将
currentTime设置为[[current frame]]除以sampleRate。
-
-
将 render result 设置为
true。
-
-
返回 render result。
将一个 AudioNode
静音
意味着其
输出在渲染此音频块时必须为静音。
从 AudioNode
提供缓冲区
用于读取
意味着将其置于一种状态,使连接到此 AudioNode
的其他
AudioNode
可以安全地
从中读取。
注: 例如,实现可以选择 分配一个新缓冲区, 或使用更复杂的机制,复用一个 当前未使用的现有缓冲区。
记录输入
一个 AudioNode
的输入意味着复制此 AudioNode
的输入数据,以供将来
使用。
计算一个
音频块意味着
运行此 AudioNode
的算法,以生成
[[render quantum size]]
个采样帧。
处理
输入缓冲区意味着
运行某个 AudioNode
的算法,并使用一个输入
缓冲区以及此
AudioNode
的 AudioParam
的值作为此算法的输入。
2.7. 处理 AudioContext
上的中断
中断是用户代理在需要
停止 AudioContext
的音频播放时生成的事件。
例如,当另一个应用程序请求独占访问
音频输出硬件时,用户代理可以
创建一个中断。
当发生中断时,
用户代理必须排入一条控制消息
以中断 AudioContext。
运行一条控制消息
以 interrupt an
context
意味着在渲染线程上运行以下步骤:
AudioContext
-
如果 context 的
[[rendering thread state]]为closed或interrupted, 则中止 这些步骤。 -
如果 context 的
[[rendering thread state]]为running:-
尝试释放系统 资源。
-
排入一个媒体元素任务以执行 以下步骤:
-
将 context 的
[[control thread state]]设置为interrupted。 -
将 context 的
[[state before interruption]]槽设置为 "running"。 -
在 context 上触发一个事件,名称为
statechange。
-
-
-
如果 context 的
[[rendering thread state]]为suspended:-
排入一个媒体元素任务以执行 以下步骤:
-
将 context 的
[[control thread state]]设置为interrupted。 -
将 context 的
[[state before interruption]]槽设置为 "suspended"。
-
-
-
将 context 的
[[rendering thread state]]设置为interrupted。
注: 如果 AudioContext
为 suspended,
则出于隐私原因不会触发
statechange
事件,以避免
过度暴露用户活动——例如电话呼入或屏幕
被锁定时。
当中断结束时,
用户代理必须排入一条控制消息
以 end the
。AudioContext
interruption
运行一条控制消息
以结束 AudioContext
context
的中断,意味着在渲染
线程上运行以下步骤:
-
如果 context 的
[[rendering thread state]]不是interrupted, 则中止这些步骤。 -
如果 context 的
[[state before interruption]]为 "running":-
尝试获取系统资源。
-
将
[[rendering thread state]]在AudioContext上设置为 "running"。 -
开始渲染音频图。
-
排入一个媒体元素任务以执行 以下步骤:
-
如果
AudioContext的state属性尚不是 "running":-
将 context 的
[[control thread state]]设置为 "running"。 -
在 context 上触发一个事件,名称为
statechange。
-
-
-
-
如果 context 的
[[state before interruption]]为 "suspended"-
将
[[rendering thread state]]在AudioContext上设置为suspended。 -
排入一个媒体元素任务以执行 以下步骤:
-
将 context 的
[[control thread state]]设置为suspended。
-
-
-
将 context 的
[[state before interruption]]设置为null。
2.8.
处理 AudioContext
上来自系统音频资源的错误
发生音频系统资源错误时,AudioContext
audioContext 在渲染线程上执行以下步骤。
-
如果 audioContext 的
[[rendering thread state]]为running或interrupted:-
尝试释放系统 资源。
-
将 audioContext 的
[[rendering thread state]]设置为suspended。 -
排入一个媒体元素任务以执行 以下步骤:
-
将 audioContext 的
[[suspended by user]]设置为false。 -
将 audioContext 的
[[control thread state]]设置为suspended。 -
在 audioContext 上触发一个事件,名称为
statechange。
-
中止这些步骤。
-
-
如果 audioContext 的
[[rendering thread state]]为suspended:-
排入一个媒体元素任务以执行 以下步骤:
-
注: 系统音频资源错误的一个示例是:
在 AudioContext
主动渲染期间,外部或无线音频设备
断开连接。
2.9. 卸载文档
对使用BaseAudioContext
的文档,定义了额外的卸载
文档清理步骤:
-
对于相关全局对象与文档的关联 Window 相同的每个
AudioContext和OfflineAudioContext, 使用InvalidStateError拒绝[[pending promises]]中的所有 promise。 -
停止所有
decoding thread。 -
排入一条控制消息,以对
AudioContext或OfflineAudioContext调用close()。
3. 动态生命周期
3.1. 背景
注: AudioContext
和 AudioNode
生命周期特性的规范性说明由
AudioContext 生命周期和AudioNode
生命周期描述。
本节为非规范性内容。
除了允许创建静态路由 配置之外,还应当能够对动态分配、生命周期有限的音色执行自定义效果 路由。为便于讨论,我们将这些 短生命周期音色称为“音符”。许多音频应用程序都包含 音符的概念,例如鼓机、音序器,以及 根据游戏进程触发大量一次性声音的 3D 游戏。
在传统的软件合成器中,音符会从可用资源池中动态 分配和释放。当收到 MIDI note-on 消息时分配音符。 当音符完成播放时将其释放,这可能是因为其到达 采样数据的末尾(如果不循环),其包络到达值为零的 sustain 阶段,或者由于 MIDI note-off 消息使其进入包络的 release 阶段。 在 MIDI note-off 情况下,音符不会立即释放,而是 仅在 release 包络阶段结束后释放。在任意时刻, 可能有大量音符正在播放,但音符集合会随着新音符 添加到路由图以及旧音符被释放而 不断变化。
音频系统会自动处理单个“音符”事件对应的
路由图部分的拆除。“音符”由一个 AudioBufferSourceNode
表示,
它可以直接连接到其他处理节点。音符
播放完成后,上下文会自动释放对 AudioBufferSourceNode
的引用,
后者又会释放对其所连接任何节点的引用,依此类推。
节点会自动从图中断开,并在不再存在引用时
被删除。图中寿命较长、由动态音色共享的节点可以
显式管理。虽然听起来很复杂,但这一切都会
自动发生,无需额外处理。
3.2. 示例
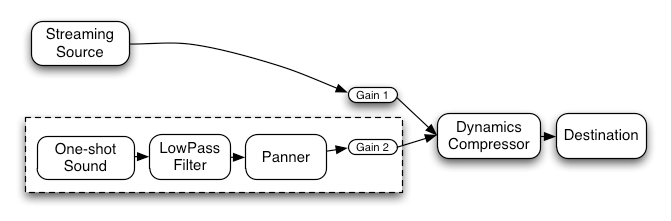
低通滤波器、声像节点和第二个增益节点都直接 连接到一次性声音。因此,当它播放完成后, 上下文会自动释放它们(虚线内的所有内容)。如果 不再有任何对一次性声音和所连接节点的引用,那么它们会立即 从图中移除并删除。流式源具有全局引用, 并会一直保持连接,直到显式断开。下面是 JavaScript 中可能的写法:
let context= 0 ; let compressor= 0 ; let gainNode1= 0 ; let streamingAudioSource= 0 ; // 路由图“长寿命”部分的初始设置 function setupAudioContext() { context= new AudioContext(); compressor= context. createDynamicsCompressor(); gainNode1= context. createGain(); // 创建一个流式音频源。 const audioElement= document. getElementById( 'audioTagID' ); streamingAudioSource= context. createMediaElementSource( audioElement); streamingAudioSource. connect( gainNode1); gainNode1. connect( compressor); compressor. connect( context. destination); } // 稍后响应某些用户操作(通常是鼠标或按键事件)时 // 可以播放一次性声音。 function playSound() { const oneShotSound= context. createBufferSource(); oneShotSound. buffer= dogBarkingBuffer; // 创建滤波器、声像节点和增益节点。 const lowpass= context. createBiquadFilter(); const panner= context. createPanner(); const gainNode2= context. createGain(); // 建立连接 oneShotSound. connect( lowpass); lowpass. connect( panner); panner. connect( gainNode2); gainNode2. connect( compressor); // 从现在起 0.75 秒后播放(要立即播放则传入 0) oneShotSound. start( context. currentTime+ 0.75 ); }
4. 声道升混和降混
本节为规范性内容。
AudioNode 输入具有用于组合所有连接到它的声道的混音
规则。举一个简单的例子,如果一个输入同时连接了
单声道输出和立体声输出,那么单声道连接通常会
升混成立体声,并与立体声连接求和。
当然,为每个 AudioNode
的每个输入精确定义混音
规则非常重要。
所有输入的默认混音规则经过选择,使得
无需过多关注细节就能“正常工作”,
特别是在非常常见的单声道和立体声流场景中。
当然,对于高级使用场景,尤其是多声道场景,
可以更改这些规则。
定义几个术语:升混是指 将声道数量较少的流转换为 声道数量较多的流的过程。降混是指 将声道数量较多的流转换为 声道数量较少的流的过程。
AudioNode
输入需要混合连接到此输入的所有输出。
作为此过程的一部分,它会计算一个内部值
computedNumberOfChannels,表示任意给定时刻输入的实际
声道数量。
AudioNode
的每个输入,实现
必须:
-
对于输入的每个连接:
-
根据节点的
channelInterpretation属性给出的ChannelInterpretation值,将连接升混或降混到 computedNumberOfChannels。 -
将其与所有其他已混合的流(来自其他 连接)混合在一起。这只是对每个连接在 步骤 1 中已经升混或降混 后相应的各声道直接进行求和。
-
4.1. 扬声器声道布局
当 channelInterpretation
为
"speakers"
时,
升混和降混针对特定声道布局定义。
必须支持单声道(一个声道)、立体声(两个声道)、四声道(四个声道)和 5.1(六个声道)。本规范的未来版本可以 支持其他声道布局。
4.2. 声道顺序
声道顺序由下表定义。各个 多声道格式可以不支持所有中间声道。 实现必须按照下面定义的顺序提供已有声道, 并跳过不存在的声道。
| 顺序 | 标签 | 单声道 | 立体声 | 四声道 | 5.1 |
|---|---|---|---|---|---|
| 0 | SPEAKER_FRONT_LEFT | 0 | 0 | 0 | 0 |
| 1 | SPEAKER_FRONT_RIGHT | 1 | 1 | 1 | |
| 2 | SPEAKER_FRONT_CENTER | 2 | |||
| 3 | SPEAKER_LOW_FREQUENCY | 3 | |||
| 4 | SPEAKER_BACK_LEFT | 2 | 4 | ||
| 5 | SPEAKER_BACK_RIGHT | 3 | 5 | ||
| 6 | SPEAKER_FRONT_LEFT_OF_CENTER | ||||
| 7 | SPEAKER_FRONT_RIGHT_OF_CENTER | ||||
| 8 | SPEAKER_BACK_CENTER | ||||
| 9 | SPEAKER_SIDE_LEFT | ||||
| 10 | SPEAKER_SIDE_RIGHT | ||||
| 11 | SPEAKER_TOP_CENTER | ||||
| 12 | SPEAKER_TOP_FRONT_LEFT | ||||
| 13 | SPEAKER_TOP_FRONT_CENTER | ||||
| 14 | SPEAKER_TOP_FRONT_RIGHT | ||||
| 15 | SPEAKER_TOP_BACK_LEFT | ||||
| 16 | SPEAKER_TOP_BACK_CENTER | ||||
| 17 | SPEAKER_TOP_BACK_RIGHT |
4.3. 尾部时间对输入和输出声道数量的影响
当 AudioNode
具有
非零尾部时间,并且输出
声道数量取决于输入声道数量时,在输入声道数量
变化时必须考虑 AudioNode 的
尾部时间。
当输入声道数量减少时,输出声道 数量的变化必须在先前以较多声道数量接收到的输入 不再影响输出时发生。
当输入声道数量增加时,其行为取决于
AudioNode
类型:
-
对于
DelayNode或DynamicsCompressorNode, 输出 声道数量必须在先前以较多声道 数量接收到的输入开始影响输出时增加。 -
对于其他具有尾部时间的
AudioNode, 输出 声道数量必须立即增加。注: 对于
ConvolverNode, 这仅适用于脉冲 响应为单声道的情况。否则,ConvolverNode无论其输入声道数量如何, 始终输出立体声信号。
注: 直观地说,这允许在 处理过程中不丢失立体声信息:当多个具有不同声道数量的输入渲染量子 对一个输出渲染量子有贡献时,输出渲染量子的声道 数量是各输入渲染量子输入声道数量的超集。
4.4. 扬声器布局升混
单声道升混:

    1 -> 2 : 从单声道升混到立体声
        output.L = input;
        output.R = input;

    1 -> 4 : 从单声道升混到四声道
        output.L = input;
        output.R = input;
        output.SL = 0;
        output.SR = 0;

    1 -> 5.1 : 从单声道升混到 5.1
        output.L = 0;
        output.R = 0;
        output.C = input; // 放入中央声道
        output.LFE = 0;
        output.SL = 0;
        output.SR = 0;

立体声升混:

    2 -> 4 : 从立体声升混到四声道
        output.L = input.L;
        output.R = input.R;
        output.SL = 0;
        output.SR = 0;

    2 -> 5.1 : 从立体声升混到 5.1
        output.L = input.L;
        output.R = input.R;
        output.C = 0;
        output.LFE = 0;
        output.SL = 0;
        output.SR = 0;

四声道升混:

    4 -> 5.1 : 从四声道升混到 5.1
        output.L = input.L;
        output.R = input.R;
        output.C = 0;
        output.LFE = 0;
        output.SL = input.SL;
        output.SR = input.SR;
4.5. 扬声器布局降混
例如,在处理 5.1 源素材但以立体声 播放时,需要进行降混。
单声道降混:

    2 -> 1 : 立体声到单声道
        output = 0.5 * (input.L + input.R);

    4 -> 1 : 四声道到单声道
        output = 0.25 * (input.L + input.R + input.SL + input.SR);

    5.1 -> 1 : 5.1 到单声道
        output = sqrt(0.5) * (input.L + input.R) + input.C + 0.5 * (input.SL + input.SR)

立体声降混:

    4 -> 2 : 四声道到立体声
        output.L = 0.5 * (input.L + input.SL);
        output.R = 0.5 * (input.R + input.SR);

    5.1 -> 2 : 5.1 到立体声
        output.L = L + sqrt(0.5) * (input.C + input.SL)
        output.R = R + sqrt(0.5) * (input.C + input.SR)

四声道降混:

    5.1 -> 4 : 5.1 到四声道
        output.L = L + sqrt(0.5) * input.C
        output.R = R + sqrt(0.5) * input.C
        output.SL = input.SL
        output.SR = input.SR
4.6. 声道规则示例
// 将增益节点设置为显式的 2 声道(立体声)。 gain. channelCount= 2 ; gain. channelCountMode= "explicit" ; gain. channelInterpretation= "speakers" ; // 将“硬件输出”设置为 4 声道,供具有两个立体声输出总线的 DJ 应用使用。 context. destination. channelCount= 4 ; context. destination. channelCountMode= "explicit" ; context. destination. channelInterpretation= "discrete" ; // 将“硬件输出”设置为 8 声道,用于自定义多声道扬声器阵列 // 并使用自定义矩阵混音。 context. destination. channelCount= 8 ; context. destination. channelCountMode= "explicit" ; context. destination. channelInterpretation= "discrete" ; // 将“硬件输出”设置为 5.1,以播放 HTMLAudioElement。 context. destination. channelCount= 6 ; context. destination. channelCountMode= "explicit" ; context. destination. channelInterpretation= "speakers" ; // 显式降混为单声道。 gain. channelCount= 1 ; gain. channelCountMode= "explicit" ; gain. channelInterpretation= "speakers" ;
5. 音频信号值
5.1. 音频采样格式
线性脉冲 编码调制(线性 PCM)描述一种 音频值以固定间隔采样,并且两个连续值之间的 量化电平呈线性均匀分布的格式。
在本规范中,只要信号值暴露给脚本,它们都采用
线性 32 位浮点脉冲编码调制格式(线性 32 位浮点
PCM),通常以 Float32Array
对象的形式提供。
5.2. 渲染
任意音频图的目标节点处所有音频信号的标称范围
为 [-1, 1]。对于超出此
范围的信号值,或者 NaN、正无穷或负
无穷,本规范未定义其音频呈现。
6. 空间化/声像定位
6.1. 背景
现代 3D 游戏的一项常见功能需求,是能够 在 3D 空间中动态空间化和移动多个音频源。 例如 OpenAL 就具备此能力。
使用 PannerNode,
可以相对于
AudioListener
对音频流进行空间化或在空间中定位。
一个
BaseAudioContext
将包含一个
AudioListener。
声像节点和监听者都使用右手笛卡尔坐标
系统在 3D 空间中具有一个位置。坐标系使用的单位未定义,
也无需定义,因为使用这些
坐标计算的效果与米或英尺等
任何特定单位无关/保持不变。PannerNode
对象(表示
源流)具有一个方向向量,用于表示
声音投射的方向。此外,它们还有一个
声音锥体,表示声音的方向性程度。例如,
声音可以是全向的,在这种情况下,无论其方向如何,
在任何位置都能听到;或者它可以更具
方向性,只有朝向监听者时才能听到。
AudioListener
对象(表示一个人的
双耳)具有前向和上向向量,
表示此人面向的方向。
用于空间化的坐标系如下图所示,
同时显示了默认值。AudioListener
和 PannerNode
的位置已从默认
位置移开,以便更清楚地观察。

在渲染期间,PannerNode
会计算
方位角和仰角。实现会在内部使用这些值
来渲染
空间化效果。有关如何使用这些值的详细信息,请参阅
声像定位算法一节。
6.2. 方位角和仰角
必须使用以下算法来计算
PannerNode
的方位角和仰角。
实现必须适当考虑下面各个 AudioParam
是 "a-rate"
还是 "k-rate"。
// 令 |context| 为 BaseAudioContext,并令 |panner| 为 // 在 |context| 中创建的 PannerNode。 // 计算源-监听者向量。 const listener= context. listener; const sourcePosition= new Vec3( panner. positionX. value, panner. positionY. value, panner. positionZ. value); const listenerPosition= new Vec3( listener. positionX. value, listener. positionY. value, listener. positionZ. value); const sourceListener= sourcePosition. diff( listenerPosition). normalize(); if ( sourceListener. magnitude== 0 ) { // 如果源和监听者位于同一点,则处理退化情况。 azimuth= 0 ; elevation= 0 ; return ; } // 对齐坐标轴。 const listenerForward= new Vec3( listener. forwardX. value, listener. forwardY. value, listener. forwardZ. value); const listenerUp= new Vec3( listener. upX. value, listener. upY. value, listener. upZ. value); const listenerRight= listenerForward. cross( listenerUp); if ( listenerRight. magnitude== 0 ) { // 处理监听者的 'up' 与 'forward' 向量线性 // 相关的情况,此时无法确定 'right' azimuth= 0 ; elevation= 0 ; return ; } // 确定一个与监听者的右向量、前向量正交的单位向量 const listenerRightNorm= listenerRight. normalize(); const listenerForwardNorm= listenerForward. normalize(); const up= listenerRightNorm. cross( listenerForwardNorm); const upProjection= sourceListener. dot( up); const projectedSource= sourceListener. diff( up. scale( upProjection)). normalize(); azimuth= 180 * Math. acos( projectedSource. dot( listenerRightNorm)) / Math. PI; // 源位于监听者前方或后方。 const frontBack= projectedSource. dot( listenerForwardNorm); if ( frontBack< 0 ) azimuth= 360 - azimuth; // 使方位角相对于监听者的 "forward" 向量,而不是 "right" 向量。 if (( azimuth>= 0 ) && ( azimuth<= 270 )) azimuth= 90 - azimuth; else azimuth= 450 - azimuth; elevation= 90 - 180 * Math. acos( sourceListener. dot( up)) / Math. PI; if ( elevation> 90 ) elevation= 180 - elevation; else if ( elevation< - 90 ) elevation= - 180 - elevation;
6.3. 声像定位算法
必须支持单声道到立体声和立体声到立体声的声像定位。 当输入的所有连接均为单声道时使用单声道到立体声处理。 否则使用 立体声到立体声处理。
6.3.1. PannerNode "equalpower" 声像定位
这是一个简单且开销相对较低的算法,
能提供基础但合理的结果。当 PannerNode
的 panningModel
属性设置为
"equalpower"
时使用该算法,
在这种情况下会忽略仰角
值。必须按照
automationRate
指定的适当速率实现此算法。
如果 PannerNode
的任何
AudioParam
或 AudioListener
的
AudioParam
为
"a-rate",
则必须使用 a-rate 处理。
-
对于此
AudioNode要计算的每个采样:-
令 azimuth 为方位角 和仰角一节中计算出的值。
-
首先按照以下方式将 azimuth 值限制在 [-90, 90] 范围内:
// 首先,将方位角钳制到允许的 [-180, 180] 范围。 azimuth= max( - 180 , azimuth); azimuth= min( 180 , azimuth); // 然后回绕到 [-90, 90] 范围。 if ( azimuth< - 90 ) azimuth= - 180 - azimuth; else if ( azimuth> 90 ) azimuth= 180 - azimuth; -
对于单声道输入,根据 azimuth 计算归一化值 x:
x
= ( azimuth+ 90 ) / 180 ; 对于立体声输入:
if ( azimuth<= 0 ) { // -90 -> 0 // 将方位角值从 [-90, 0] 度变换到 [-90, 90] 范围。 x= ( azimuth+ 90 ) / 90 ; } else { // 0 -> 90 // 将方位角值从 [0, 90] 度变换到 [-90, 90] 范围。 x= azimuth/ 90 ; } -
左右增益值按以下方式计算:
gainL
= cos( x* Math. PI/ 2 ); gainR= sin( x* Math. PI/ 2 ); -
对于单声道输入,立体声输出按以下方式计算:
outputL
= input* gainL; outputR= input* gainR; 否则,对于立体声输入,输出按以下方式计算:
if ( azimuth<= 0 ) { outputL= inputL+ inputR* gainL; outputR= inputR* gainR; } else { outputL= inputL* gainL; outputR= inputR+ inputL* gainR; } -
应用距离增益和锥体增益,其中 距离计算在 距离 效果中描述,锥体增益在 声音锥体中描述:
let distance= distance(); let distanceGain= distanceModel( distance); let totalGain= coneGain() * distanceGain(); outputL= totalGain* outputL; outputR= totalGain* outputR;
-
6.3.2. PannerNode "HRTF" 声像定位(仅立体声)
这需要一组在各种 方位角和仰角下记录的 HRTF (头相关传递函数)脉冲响应。实现需要一个 高度优化的卷积函数。它的开销比 "equalpower" 略高,但能提供感知上更具空间感的 声音。
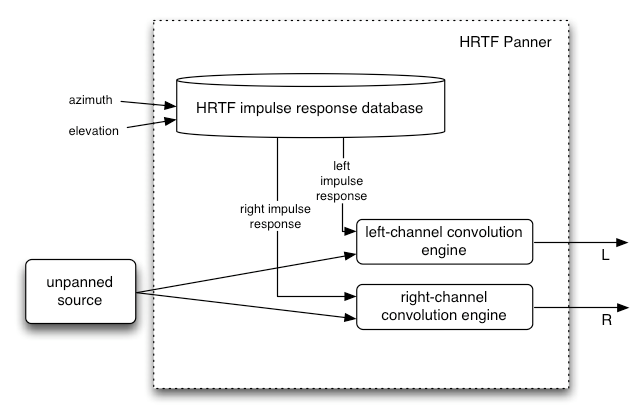
6.3.3. StereoPannerNode 声像定位
StereoPannerNode,
必须实现
以下算法。
-
对于此
AudioNode要计算的每个采样-
令 pan 为此
StereoPannerNode的panAudioParam的 computedValue。 -
将 pan 钳制到 [-1, 1]。
pan
= max( - 1 , pan); pan= min( 1 , pan); -
通过将 pan 值归一化到 [0, 1] 来计算 x。对于单声道输入:
x
= ( pan+ 1 ) / 2 ; 对于立体声输入:
if ( pan<= 0 ) x= pan+ 1 ; else x= pan; -
左右增益值按以下方式计算:
gainL
= cos( x* Math. PI/ 2 ); gainR= sin( x* Math. PI/ 2 ); -
对于单声道输入,立体声输出按以下方式计算:
outputL
= input* gainL; outputR= input* gainR; 否则,对于立体声输入,输出按以下方式计算:
if ( pan<= 0 ) { outputL= inputL+ inputR* gainL; outputR= inputR* gainR; } else { outputL= inputL* gainL; outputR= inputR+ inputL* gainR; }
-
6.4. 距离效果
距离较近的声音更响,而距离较远的声音
更轻。声音的音量究竟如何根据
与监听者的距离变化,取决于 distanceModel
属性。
在音频渲染期间,会根据声像节点和监听者的位置 按照以下方式计算一个距离值:
function distance( panner) { const pannerPosition= new Vec3( panner. positionX. value, panner. positionY. value, panner. positionZ. value); const listener= context. listener; const listenerPosition= new Vec3( listener. positionX. value, listener. positionY. value, listener. positionZ. value); return pannerPosition. diff( listenerPosition). magnitude; }
然后,distance 将用于计算
distanceGain,它取决于 distanceModel
属性。有关每种距离模型如何
计算此值的详细信息,请参阅 DistanceModelType
一节。
作为其处理的一部分,PannerNode
会使用 distanceGain 缩放/乘以输入音频信号,
使远处的声音更轻、近处的声音更响。
6.5. 声音锥体
监听者和每个声源都有一个方向向量, 用于描述其朝向。每个声源的声音 投射特性由内部和外部“锥体”描述, 它们根据相对于声源方向向量的源/监听者 夹角描述声音强度。因此,直接 指向监听者的声源会比偏离轴向时更响。 声源也可以是全向的。
下图说明了声源锥体
相对于监听者的关系。在图中,
coneInnerAngle
= 50coneOuterAngle
= 120

给定声源(
PannerNode)
和监听者,必须使用以下算法计算
由锥体效果产生的增益贡献:
function coneGain() { const sourceOrientation= new Vec3( source. orientationX, source. orientationY, source. orientationZ); if ( sourceOrientation. magnitude== 0 || (( source. coneInnerAngle== 360 ) && ( source. coneOuterAngle== 360 ))) return 1 ; // 未指定锥体——单位增益 // 归一化的源-监听者向量 const sourcePosition= new Vec3( panner. positionX. value, panner. positionY. value, panner. positionZ. value); const listenerPosition= new Vec3( listener. positionX. value, listener. positionY. value, listener. positionZ. value); const sourceToListener= sourcePosition. diff( listenerPosition). normalize(); const normalizedSourceOrientation= sourceOrientation. normalize(); // 声源方向向量与源-监听者向量之间的夹角 const angle= 180 * Math. acos( sourceToListener. dot( normalizedSourceOrientation)) / Math. PI; const absAngle= Math. abs( angle); // 此处除以 2,因为 API 使用整个角度(而非半角) const absInnerAngle= Math. abs( source. coneInnerAngle) / 2 ; const absOuterAngle= Math. abs( source. coneOuterAngle) / 2 ; let gain= 1 ; if ( absAngle<= absInnerAngle) { // 不衰减 gain= 1 ; } else if ( absAngle>= absOuterAngle) { // 最大衰减 gain= source. coneOuterGain; } else { // 位于内锥体和外锥体之间 // 从 inner -> outer,x 从 0 -> 1 const x= ( absAngle- absInnerAngle) / ( absOuterAngle- absInnerAngle); gain= ( 1 - x) + source. coneOuterGain* x; } return gain; }
7. 性能考量
7.1. 延迟
对于 Web 应用程序,鼠标和键盘 事件(keydown、mousedown 等)与听到声音之间的 时间延迟非常重要。
这种时间延迟称为延迟,由多个因素造成 (输入设备延迟、内部缓冲延迟、DSP 处理 延迟、输出设备延迟、用户耳朵与 扬声器之间的距离等),并且是累积的。延迟越大, 用户体验越差。在极端情况下, 它会使音乐制作或游戏无法进行。在中等 程度下,它会影响时序,使人感觉声音滞后 或游戏无响应。对于音乐应用程序, 时序问题会影响节奏。对于游戏,时序问题会影响 游戏操作精度。对于交互式应用程序,它通常会 降低用户体验,其程度类似于动画帧率非常低时。 根据应用程序不同,合理的延迟可以低至 3-6 毫秒,也可以是 25-50 毫秒。
实现通常会尽量降低总体延迟。
除了尽量降低总体延迟,实现通常还会
尽量减小 AudioContext
的
currentTime 与
AudioProcessingEvent
的
playbackTime 之间的差异。
随着 ScriptProcessorNode
被弃用,
随着时间推移,这一考量的重要性会降低。
此外,一些 AudioNode
会给音频图的某些路径增加延迟,
特别是:
-
AudioWorkletNode可以运行一个在内部进行缓冲的脚本, 从而给信号路径增加延迟。 -
DelayNode的作用就是增加受控的延迟 时间。 -
BiquadFilterNode和IIRFilterNode的滤波器 设计可能会延迟传入采样,这是 因果滤波过程的自然结果。 -
ConvolverNode根据脉冲响应不同,可能会延迟 传入采样,这是卷积操作的自然结果。 -
DynamicsCompressorNode使用预读算法, 会在信号路径中造成延迟。 -
MediaStreamAudioSourceNode、MediaStreamTrackAudioSourceNode和MediaStreamAudioDestinationNode根据实现不同,可能会在内部添加 会产生延迟的缓冲区。 -
ScriptProcessorNode可能在控制线程和渲染线程之间 存在缓冲区。 -
WaveShaperNode在过采样时,根据 过采样技术不同,会给信号路径增加延迟。
7.2. 音频缓冲区复制
在 AudioBuffer
上执行获取内容
操作时,整个操作通常
可以在不复制声道数据的情况下实现。特别是,
最后一步应该延迟到下一次
getChannelData()
调用时执行。
这意味着,如果连续进行一系列获取内容操作,并且其间没有
getChannelData()
调用(例如多个
AudioBufferSourceNode
播放同一个
AudioBuffer),
则可以在完全不进行
分配或复制的情况下实现。
实现还可以进行额外优化:如果
在一个
AudioBuffer
上调用
getChannelData(),
尚未
分配新的 ArrayBuffer,
但此前对一个
AudioBuffer
执行获取内容操作的所有调用者
都已经停止使用该 AudioBuffer
的数据,
则可以回收原始数据缓冲区,以用于新的
AudioBuffer,
从而避免重新分配或复制
声道数据。
7.3. AudioParam 过渡
直接设置
AudioParam
的 value
属性时不会进行自动平滑处理,
但对于某些参数,与直接设置值相比,
平滑过渡更为合适。
使用 setTargetAtTime()
方法并设置较低的
timeConstant,可以让作者实现平滑
过渡。
7.4. 音频故障
音频故障由正常连续音频流的中断引起, 会产生响亮的咔哒声和爆音。这被视为 多媒体系统的灾难性故障,必须 避免。它可能由负责 将音频流传递给硬件的线程出现问题引起,例如由于线程 没有适当的优先级和 时间约束而导致的调度延迟。它也可能由音频 DSP 在给定 CPU 速度的情况下尝试执行超出实时能力的 工作量而引起。
8. 隐私考量
-
本规范是否处理个人可识别信息?
可以使用 Web Audio API 进行听力测试,从而 揭示一个人可听见的频率范围(该范围会随 年龄增长而缩小)。很难想象在用户不知情且未同意的情况下 如何做到这一点,因为这需要用户主动参与。
-
本规范是否处理高价值数据?
否。Web Audio 不使用信用卡信息等内容。 可以使用 Web Audio 处理或分析语音数据, 这可能引发隐私问题,但对用户 麦克风的访问通过
getUserMedia()基于权限控制。 -
本规范是否为源引入会在 浏览会话之间持续存在的新状态?
否。AudioWorklet 不会在浏览会话之间持续存在。
-
本规范是否向 Web 暴露持久的跨源状态?
是,会暴露支持的音频采样率和输出设备声道数量。参见
AudioContext。 -
本规范是否向源暴露其 当前无法访问的任何其他数据?
是。当提供可用
AudioNode的各种信息时,Web Audio API 可能会 向使用AudioNode接口的任何页面暴露客户端的特征信息(例如 音频硬件采样率)。此外,可以通过AnalyserNode或ScriptProcessorNode接口收集时序 信息。随后可以使用这些信息创建客户端指纹。普林斯顿 CITP 的 Web 透明度与问责项目 的研究表明,
DynamicsCompressorNode和OscillatorNode可以 用于从客户端收集熵,以对设备进行指纹识别。 这是因为不同实现之间在 DSP 架构、重采样策略以及舍入权衡方面存在细微且通常不可听见的差异。 所使用的具体编译器标志以及 CPU 架构(ARM 与 x86)也会贡献这些熵。不过在实践中,这只允许推断 通过更简单方式(User Agent 字符串)已经很容易获得的信息, 例如“这是运行在平台 Y 上的浏览器 X”。不过,为降低 额外指纹识别的可能性,我们要求浏览器采取 措施来缓解任何节点输出可能造成的指纹识别问题。
通过时钟偏移进行指纹识别 已由 Steven J Murdoch 和 Sebastian Zander 描述。可能可以 通过
getOutputTimestamp确定这一点。 基于偏移的指纹识别也已由 Nakibly 等人针对 HTML 展示。有关时钟分辨率和漂移的更多 信息,应参阅高精度时间 § 10. 隐私考量一节。通过延迟进行指纹识别也是可能的;可能可以通过
baseLatency和outputLatency推断这一点。缓解 策略包括添加抖动(dithering)和量化,使得精确 偏移被错误报告。不过请注意,大多数音频系统都以 低延迟为目标, 以将 WebAudio 生成的音频与其他 音频或视频源或者视觉提示同步(例如在游戏、音频 录制或音乐制作环境中)。过高的延迟会降低可用性,并且可能成为 无障碍问题。也可以通过
AudioContext的采样率进行指纹识别。我们 建议采取以下步骤来尽量降低这种风险:-
允许 44.1 kHz 和 48 kHz 作为默认采样率;系统将根据 适用性在两者之间选择。(显然,如果音频设备原生为 44.1,则会选择 44.1,等等;但系统也可以选择 最“兼容”的采样率——例如,如果系统原生为 96kHz, 很可能会选择 48kHz,而不是 44.1kHz。
-
对于原生使用其他采样率的设备,系统应当重采样到 这两种采样率之一,即使这可能由于重采样音频而导致额外 电池消耗。(同样,系统将选择最 兼容的采样率——例如,如果原生系统为 16kHz,则 预期选择 48kHz。)
-
预期(但不强制要求)浏览器提供一种用户 控件,以强制使用原生采样率——例如通过在 设备上的浏览器中设置标志。此设置不会暴露在 API 中。
-
同样预期可以在
AudioContext的构造函数中显式请求不同的采样率 (这已经在规范中; 它通常会使音频渲染以请求的 sampleRate 进行, 然后升采样或降采样到设备输出), 如果该采样率原生受支持,则渲染可以直接通过。 这将使应用程序能够在无需 用户干预的情况下以更高采样率渲染(尽管 Web Audio 无法观察到 音频输出是否在输出端未被降采样)——例如,如果MediaDevices的能力被读取(需要用户干预),并表明 支持更高采样率。
当使用
"hardware"提示时,可以通过AudioContext的渲染量子大小进行指纹识别,因为它会暴露 用户默认音频硬件缓冲区 大小的信息。为降低这种风险,renderQuantumSize会返回 0,直到AudioContext转换到"running"状态。一旦AudioContext转换到"running"状态,就会返回 实际渲染量子大小。运行中的 AudioContext 可以 通过AudioWorklet时序推断用户的音频硬件缓冲区大小,因此这不会暴露任何新的 信息。也可以通过
AudioContext的输出声道数量进行指纹识别。我们建议将maxChannelCount设置为二 (立体声)。立体声是目前最常见的 声道数量。 -
-
本规范是否允许源访问用户的 位置?
否。
-
本规范是否允许源访问 用户设备上的传感器?
不会直接允许。目前,音频输入未在本 文档中规定,但它将涉及访问客户端 机器的音频输入或麦克风。这将需要以适当方式请求 用户许可,可能通过
getUserMedia()API。此外,还应注意 媒体捕获 和流规范中的安全与隐私考量。特别是, 分析环境音频或播放独特音频可能使 用户位置被识别到房间级别,甚至可以识别 不同用户或设备是否同时处于同一房间。 同时访问音频输出和音频输入还可能 使一个浏览器中原本分区隔离的上下文之间实现通信。
-
本规范是否允许源访问 用户本地计算环境的某些方面?
不会直接允许;所有请求的采样率都受支持, 必要时进行升采样。 可以使用媒体捕获和流,并通过 MediaTrackSupportedConstraints 探测支持的音频采样率。 这需要用户明确同意。 这确实会提供少量指纹识别信息。不过, 实际上大多数消费级和准专业设备都使用两种 标准采样率之一:44.1kHz(最初用于 CD)和 48kHz (最初用于 DAT)。资源高度受限的设备可能 支持语音质量的 11kHz 采样率,而高端设备通常 支持 88.2、96,甚至发烧级的 192kHz 采样率。
要求所有实现都升采样到单一、广泛支持的 采样率(例如 48kHz)会无谓增加 CPU 成本,而 要求高端设备使用较低采样率只会导致 Web Audio 被认为不适合专业用途。
-
本规范是否向 Web 暴露临时标识符?
否。
-
本规范是否区分第一方 和第三方上下文中的行为?
否。
-
本规范在用户代理的 “隐身”模式下应如何工作?
没有不同。
-
本规范是否将数据持久化到用户的本地设备?
否。
-
本规范是否包含“安全考量”和 “隐私考量”章节?
是(你正在阅读它)。
9. 安全考量
-
本规范是否启用新的脚本执行/加载 机制?
否。它确实使用了 [HTML] 脚本执行方法, 该方法在该规范中定义。
-
本规范是否允许源访问其他设备?
通常不允许访问其他联网设备( 高端录音室中的一个例外可能是 Dante 网络 设备,不过这些设备通常使用独立的专用网络)。 但它确实必然允许访问用户的音频输出设备 或多个设备,这些设备有时是与计算机分离的单独设备。
对于语音或声音触发设备,Web Audio API 可能被用于 控制其他设备。此外,如果声音操作的设备对 接近超声波的频率敏感,这种控制可能听不见。 这种可能性在 HTML 中也存在,可通过 <audio> 或 <video> 元素实现。在常见的音频采样率下, (按设计)没有足够的频率余量用于大量超声信息:
人类听觉上限通常认为是 20kHz。对于 44.1kHz 采样率,奈奎斯特极限为 22.05kHz。由于真正的 砖墙滤波器无法物理实现,20kHz 到 22.05kHz 之间的空间用于快速滚降滤波器,以强烈 衰减所有高于奈奎斯特频率的频率。
在 48kHz 采样率下,20kHz 到 24kHz 频段中仍然存在快速衰减(但更容易避免通带中的 相位纹波误差)。
-
本规范是否允许源对 用户代理的原生 UI 进行一定程度的控制?
如果 UI 包含音频组件,例如语音助手或屏幕阅读器, Web Audio API 可能被用于模拟原生 UI 的某些方面, 从而使攻击看起来更像本地系统事件。 这种可能性在 HTML 中也存在,可通过 <audio> 元素实现。
-
本规范是否允许降低默认安全 特性?
否。
10. 要求和使用场景
请参阅 [webaudio-usecases]。
11. 规范代码的通用定义
本节描述了本规范中使用的 JavaScript 代码采用的通用函数和类。
// 三维向量类。 class Vec3{ // 从 3 个坐标构造。 constructor ( x, y, z) { this . x= x; this . y= y; this . z= z; } // 与另一个向量进行点积。 dot( v) { return ( this . x* v. x) + ( this . y* v. y) + ( this . z* v. z); } // 与另一个向量进行叉积。 cross( v) { return new Vec3(( this . y* v. z) - ( this . z* v. y), ( this . z* v. x) - ( this . x* v. z), ( this . x* v. y) - ( this . y* v. x)); } // 与另一个向量求差。 diff( v) { return new Vec3( this . x- v. x, this . y- v. y, this . z- v. z); } // 获取此向量的模。 get magnitude() { return Math. sqrt( dot( this )); } // 获取此向量乘以标量后的副本。 scale( s) { return new Vec3( this . x* s, this . y* s, this . z* s); } // 获取此向量的归一化副本。 normalize() { const m= magnitude; if ( m== 0 ) { return new Vec3( 0 , 0 , 0 ); } return scale( 1 / m); } }
12. 变更日志
12.1. 自 2024 年 11 月 05 日首次公开工作草案以来
- PR 2688: 推测性 PR 预览修复
- PR 2686: 将隐私考量和安全考量拆分为单独 章节
- PR 2679: 添加 Slack 注册链接
- PR 2676: 更新 expected-errs.txt 格式
- PR 2675: OfflineAudioContext 增量/分块渲染
- PR 2667: 指定渲染量子大小范围约束和 renderSizeHint 处理
- PR 2657: 要求实现支持采样率范围 [3000, 768000] Hz
- PR 2656: 修复 expected-errs.txt
- PR 2654: 修复基础拼写错误
- PR 2633: 为 sink ID 添加 interrupted 状态和错误处理
- PR 2617: 修订 currentTime 的措辞
13. 致谢
本规范是 W3C 音频工作 组的集体成果。
工作组的现任和前任成员以及本规范的贡献者如下(截至撰写时,并按
字母顺序排列):
Adenot, Paul (Mozilla Foundation) - 规范联合编辑;
Akhgari, Ehsan (Mozilla Foundation);
Becker, Steven (Microsoft Corporation);
Berkovitz, Joe (Invited Expert, affiliated with Noteflight/Hal Leonard) - 2013 年 9 月至
2017 年 12 月任工作组联合主席;
Bossart, Pierre (Intel Corporation);
Borins, Myles (Google, Inc);
Buffa, Michel (NSAU);
Caceres, Marcos (Invited Expert);
Cardoso, Gabriel (INRIA);
Carlson, Eric (Apple, Inc);
Chen, Bin (Baidu, Inc);
Choi, Hongchan (Google, Inc) - 规范联合编辑;
Collichio, Lisa (Qualcomm);
Geelnard, Marcus (Opera Software);
Gehring, Todd (Dolby Laboratories);
Goode, Adam (Google, Inc);
Gregan, Matthew (Mozilla Foundation);
Hikawa, Kazuo (AMEI);
Hofmann, Bill (Dolby Laboratories);
Jägenstedt, Philip (Google, Inc);
Jeong, Paul Changjin (HTML5 Converged Technology Forum);
Kalliokoski, Jussi (Invited Expert);
Lee, WonSuk (Electronics and Telecommunications Research Institute);
Kakishita, Masahiro (AMEI);
Kawai, Ryoya (AMEI);
Kostiainen, Anssi (Intel Corporation);
Lilley, Chris (W3C Staff);
Lowis, Chris (Invited Expert) - 2012 年 12 月至 2013 年 9 月任工作组联合主席,隶属于 British
Broadcasting Corporation;
MacDonald, Alistair (W3C Invited Experts) — 2011 年 3 月至 2012 年 7 月任工作组联合主席;
Mandyam, Giridhar (Qualcomm Innovation Center, Inc);
Michel, Thierry (W3C/ERCIM);
Nair, Varun (Facebook);
Needham, Chris (British Broadcasting Corporation);
Noble, Jer (Apple, Inc);
O’Callahan, Robert(Mozilla Foundation);
Onumonu, Anthony (British Broadcasting Corporation);
Paradis, Matthew (British Broadcasting Corporation) - 2013 年 9 月至今任工作组联合主席;
Pozdnyakov, Mikhail (Intel Corporation);
Raman, T.V. (Google, Inc);
Rogers, Chris (Google, Inc);
Schepers, Doug (W3C/MIT);
Schmitz, Alexander (JS Foundation);
Shires, Glen (Google, Inc);
Smith, Jerry (Microsoft Corporation);
Smith, Michael (W3C/Keio);
Thereaux, Olivier (British Broadcasting Corporation);
Toy, Raymond (Google, Inc.) - 2017 年 12 月至今任工作组联合主席;
Toyoshima, Takashi (Google, Inc);
Troncy, Raphael (Institut Telecom);
Verdie, Jean-Charles (MStar Semiconductor, Inc.);
Wei, James (Intel Corporation);
Weitnauer, Michael (IRT);
Wilson, Chris (Google,Inc);
Zergaoui, Mohamed (INNOVIMAX)