1. 简介
本模块描述 CSS 的排版控制; 也就是说,CSS 中控制 源文本转换为格式化、自动换行文本的特性。 各种 CSS 属性提供了对 大小写变换、 空白折叠、 文本换行、 断行规则 和 连字符断字、 对齐和两端对齐、 间距, 以及 缩进的控制。 关于第 3 级以来的新增内容,参见第 3 级以来的新增内容。
用于装饰文本的特性, 例如下划线、 着重号, 以及阴影, (此前属于本模块) 由 CSS 文本装饰模块涵盖。 [CSS-TEXT-DECOR-3]
双向文本和 竖排文本 由 CSS 书写模式模块处理。 [CSS-WRITING-MODES-4]。
关于世界各地各种语言和书写系统的 排版需求的更多信息, 可见于 国际化工作 组的 语言支持索引。 [TYPOGRAPHY]
1.1. 模块交互
本模块连同 CSS 文本装饰 模块, 替代并扩展了 层叠样式表第 2 级第 16 章中定义的文本级特性。 [CSS-TEXT-DECOR-3] [CSS2]
除了下文定义的术语之外, 本规范中使用的其他术语和概念定义于 层叠样式表第 2 级 和 CSS 书写模式模块中。 [CSS2] 和 [CSS-WRITING-MODES-4]。
1.2. 值定义
本规范遵循来自 [CSS2] 的 CSS 属性 定义约定, 并使用来自 [CSS-VALUES-3] 的 值定义语法。 本规范未定义的值类型在 CSS 值与单位 [CSS-VALUES-3] 中定义。 与其他 CSS 模块组合时,可能会扩展这些值类型的定义。
除了在其定义中列出的属性特定值之外, 本规范中定义的所有属性 也接受 CSS 全局关键字作为其属性值。 为便于阅读,这里没有显式重复列出它们。
1.3. 语言和排版
作者应准确地为其内容标注语言, 以获得最佳排版行为。
许多排版效果会因语言上下文而异。 语言和书写系统的惯例可能影响 断行、连字符断字、两端对齐、字形选择, 以及许多其他排版效果。 在 CSS 中,只有当内容语言已知(已声明)时, 才会应用特定语言的排版定制。 因此, 更高质量的排版要求作者向 UA 传达文档中文本的正确语言上下文。
元素的内容语言 是该元素根据 文档语言的规则被声明为使用的(人类)语言。 注意,元素的内容语言 可能是未知的——例如未标注的内容, 或者处于没有语言标注机制的文档语言中的内容, 会被认为具有未知的内容语言。
注:作者可以使用 HTML 中的全局 lang 属性
或 XML 中的通用 xml:lang 属性来声明内容语言。
参见 HTML 中
确定 HTML 元素内容语言的规则,
以及 XML 1.0 中确定 XML 元素内容语言的规则。
[HTML]
[XML10]
元素被声明使用的内容语言 也标识该元素中所用语言的特定书面形式, 称为内容书写系统。 取决于文档语言用于标识内容语言的能力, 此信息可以是显式的,也可以是隐含的。 参见规范性的附录 F: 识别内容书写系统。
注:有些语言拥有不止一种书写系统传统; 在其他情况下,一种语言也可以被转写到外来的书写系统中。 作者应对这些情况进行子标记, 以便 UA 能够作出适当调整。
ko)可以用
谚文(-Hang)、
汉字(-Hani),
或二者组合(-Kore)书写。
仅用汉字书写的历史文献
不使用词间空格,
其格式更接近现代中文,而不是现代韩语。
换句话说,出于排版目的,ko-Hani
的行为更像 zh-Hant,
而不是 ko(ko-Kore)。
再举一个例子,日语(ja)通常写作
平假名(-Hira)、
片假名(-Kana)和汉字(-Hani)
的组合(-Japn)。
然而,它也可以为了语言学习教材等特殊目的
“罗马字化”为拉丁文字(-Latn),
在这种情况下,它的格式应更像英语而不是日语。
第三个例子是当代蒙古语使用两种文字:
西里尔文(-Cyrl,蒙古国官方使用)
和蒙古文(-Mong,在中国内蒙古更常见)。
它们有非常不同的格式要求:
西里尔文的行为类似拉丁文和希腊文,
而蒙古文则源自阿拉伯文和中文的书写惯例。
1.4. 字符和字母
排版的基本单位是字符。 然而,由于书写系统并不总是像基本英文字母表那样简单, 字符实际是什么取决于 使用该术语的上下文。 例如,在谚文(韩语书写系统)中, 一个音节的每个方块表示 (例如 한=Han) 可以被视为一个字符。 然而,该方块符号实际上由多个字母组成,每个字母表示一个音素 (例如 ㅎ=h、 ㅏ=a、 ㄴ=n), 而这些也都可以分别被视为一个字符。
对于任何给定编码而言,计算机文本编码的基本单位 也称为字符, 并且取决于该编码, 单个编码字符可能对应于 整个预组合的音节字符(例如 한), 也可能对应于单个音素字符(例如 ㅎ), 或者对应于更小的单位,例如 基础字形(例如 ㅇ) 以及改变它的任何组合标记(例如表示送气的附加笔画)。
反过来,单个编码字符 可以在数据流中表示为一个或多个字节; 而在编程环境中,一个字节有时也称为字符。
因此,在需要技术精确性的地方,术语字符相当 含糊。
对于文本布局,我们将把排版 字符单位 称为文本的基本单位。 即使在文本布局领域内, 相关的字符单位也取决于 所执行的操作。 例如,断行和字距调整会对 包含 U+0E33 ำ THAI CHARACTER SARA AM 的泰文字符序列进行不同分段; 或者天城文等文字中的连写辅音行为 可能取决于所用字体。 因此,排版字符表示书写系统中的一个单位——例如 拉丁字母(包括其变音符号)、 谚文音节、 中文表意字符、 缅甸文音节簇——它相对于特定的排版操作 (断行、首字母效果、字距调整、两端对齐、竖排排列等)是不可分割的。
Unicode 标准附录 #29:文本分段 定义了一个称为字素簇的单位, 它近似于排版字符。 [UAX29] UA 必须使用 UAX29 中定义的扩展字素簇 (而不是旧式字素簇) 作为其排版字符单位的基础。 然而,UA 应根据排版传统的需要 对这些定义进行定制, 因为默认规则并不总是适当或理想——并且预期会根据不同操作 按需以不同方式定制它们。
注:此类定制的规则不属于 CSS 范围。
- 在一些文字(例如缅甸文或天城文)中, 用于两端对齐和断行的排版字符单位 是整个音节, 其中可以包含多个 Unicode 字素簇。 [UAX29]
-
在其他文字(例如泰文或老挝文)中,
尽管对于断行,排版字符
与 Unicode 的默认字素簇相匹配,
但对于字距调整,相关单位
小于一个 Unicode 字素簇,
并且在插入间距之前
可能需要分解或其他替换。
[UAX29]
例如, 为了正确地对泰语单词 คำ(U+0E04 + U+0E33)进行字距调整, U+0E33 需要被分解为 U+0E4D + U+0E32, 然后在 U+0E32 之前插入额外的字距:คํ า。
稍微更复杂的例子是 น้ำ(U+0E19 + U+0E49 + U+0E33)。 在这种情况下,普通泰文塑形首先会将 U+0E33 分解为 U+0E4D + U+0E32, 然后交换 U+0E4D 与 U+0E49,得到 U+0E19 + U+0E4D + U+0E49 + U+0E32。 与前面一样,随后在 U+0E32 之前插入额外的字距:นํ้ า。
- 竖排也可能需要定制。 例如,在排版upright文本时, 藏文 tsek 和 shad 标记会与前面的字素簇保持在一起, 而不是被视为独立的排版字符单位。 [CSS-WRITING-MODES-4]
排版字母 单位 (或就本规范而言的字母) 是属于 Letter 或 Number 通用 类别之一的排版字符单位。 关于如何确定排版 字符单位的 Unicode 属性,参见附录 E: 字符和属性。
被元素边界分割的排版字符单位的渲染特性 未定义。 理想情况下,每个组成部分都应 根据其各自元素属性的格式要求进行渲染, 同时保持该排版字符单位整体的正确塑形和定位。 然而,取决于其各部分之间格式差异的性质 以及所用字体技术的能力, 这并不总是可能。 因此,这样的排版字符单位 可能被渲染为属于边界的任一侧, 或者被近似渲染为同时属于两侧。 作者应预先注意,用元素边界分割字素簇 或连字 可能会产生不一致或不希望的结果。
1.5. 文本处理
CSS 建立在 Unicode 之上。 [UNICODE] 支持 Unicode 的 UA 必须遵守 Unicode 核心标准的所有规范性要求, 除非被 CSS 明确覆盖。 基于非 Unicode 文本编码模型实现的 UA 仍然 被期望通过假定适当的映射和类似行为 来满足相同的文本处理要求。
为了确定文本处理中的相邻性 (例如空白处理、文本变换、断行等), 因而通常在本规范中, 中间的内联盒边界和脱离流 元素 必须被忽略。 然而,就文本塑形而言,参见 § 8.7 跨元素 边界的塑形。
2. 变换文本
2.1. 大小写变换:text-transform 属性
| 名称: | text-transform |
|---|---|
| 值: | none | [capitalize | uppercase | lowercase ] || full-width || full-size-kana | math-auto |
| 初始值: | none |
| 适用于: | 文本 |
| 继承: | 是 |
| 百分比: | 不适用 |
| 计算值: | 指定的关键字 |
| 规范顺序: | 不适用 |
| 动画类型: | 离散 |
此属性出于样式目的变换文本。 它对底层内容没有影响, 且不得影响纯文本复制粘贴操作的内容。
作者不得依赖 text-transform 来实现语义 目的; 正确的大小写和语义应编码在 源文档文本和标记中。
这些值具有以下含义:
- none
- 无效果。
- capitalize
- 将每个词的第一个排版字母单位,如果为小写,则置为 标题式大小写; 其他字符不受影响。
- uppercase
- 将所有字母置为大写。
- lowercase
- 将所有字母置为小写。
- full-width
- 将所有排版字符单位置为全角形式。 如果某个字符没有对应的全角形式, 则保持原样。 此值通常用于将拉丁字母和数字排版得 像表意字符一样。
- full-size-kana
- 将所有小假名 字符转换为等价的全尺寸假名。 此值通常用于 ruby 注音文本, 在这种场景中,作者可能希望所有小假名都绘制为大假名, 以补偿 ruby 中通常使用的小字号带来的易读性问题。
- math-auto
- 参见 MathML Core § 4.2 The math-auto transform。
注:text-transform 的目的 是允许进行呈现性的大小写变换, 而不影响文档语义。 特别注意,text-transform 大小写操作是有损的, 并且可能扭曲文本含义。 虽然无障碍接口可能希望向用户传达 渲染文本的表观大小写, 但不能依赖被变换后的文本来准确表示 文档的底层含义。
section > p:first-of-type::first-line{ text-transform : uppercase; }
这种效果不能写入源文档, 因为换行的位置取决于布局。 另外,大写化并不反映语义区别, 也不意图影响段落的阅读; 因此它属于呈现层。
rt{ font-size : 50 % ; text-transform : full-size-kana; } :is( h1, h2, h3, h4) rt{ text-transform : none; /* unset for large text*/ }
注意,虽然这会使此类字母在小字号下更容易看清, 但该变换会扭曲文本: 读者需要在适当位置在脑中替换为小假名——这有点像阅读拉丁铭文时, 其中所有的 “U” 看起来都像 “V”。
例如,如果将 text-transform: full-size-kana 应用于 以下源内容, 注音将读作“じゆう”(jiyū),意思是“自由”, 而不是“じゅう”(jū),意思是“十”, 后者才是被注音的“十”的正确读法和含义。
< ruby > 十< rt > じゅう</ ruby >
2.1.1. 映射规则
对于 capitalize,什么构成一个“词”由 UA 决定; 建议使用 [UAX29] 来确定此类词边界 (但并非必须)。 脱离流盒和内联盒 边界 不得引入 text-transform 词边界, 并且在确定此类词边界时必须被忽略。
注:作者不能依赖 capitalize 遵循 特定语言的标题式大小写惯例 (例如英语中跳过冠词)。
UA 必须使用 Unicode 字符的完整大小写映射, 包括任何条件性大小写规则, 如 The Unicode Standard 的 Default Case Algorithms 一节所定义。 [UNICODE] 当且仅当元素的内容 语言 根据文档 语言的规则 是已知的, 那么还必须应用任何适当的特定语言规则。 这些至少包括但不限于 Unicode 的 SpecialCasing.txt 中的特定语言规则。
全角
和半角形式的定义
可见于 Unicode 标准附录 #11:
东亚宽度。
[UAX11]
到全角形式的映射
定义为
取得在其 Decomposition_Mapping 中具有 <wide>
或 <narrow> 标记的码点,
这些定义位于 Unicode 标准附录 #44:Unicode
字符数据库。
[UAX44]
对于 <narrow> 标记,
映射是从该码点到分解结果
(去掉 <narrow> 标记),
而对于 <wide> 标记,
映射是从分解结果
(去掉 <wide> 标记)
回到原始码点。
小假名到全尺寸假名的映射定义于 附录 G: 小假名映射。
2.2. 在词之间扩展:word-space-transform 属性
| 名称: | word-space-transform |
|---|---|
| 值: | none | [ space | ideographic-space ] && auto-phrase? |
| 初始值: | none |
| 适用于: | 文本 |
| 继承: | 是 |
| 百分比: | 不适用 |
| 计算值: | 按指定 |
| 规范顺序: | 按语法 |
| 动画类型: | 离散 |
一些语言和书写系统具有 分隔词的替代方式, 要么使用不同的分隔字符, 要么有时完全不使用可见字符。 此属性允许作者将渲染 从一种样式改为另一种样式, 而无需更改标记。
- none
- 此属性没有效果。
- space
- 此元素子文本中的 可扩展 分隔符 被替换为 U+0020 SPACE。
- ideographic-space
- 此元素子文本中的 可扩展 分隔符 被替换为 U+3000 IDEOGRAPHIC SPACE。
- auto-phrase
- 如果内容 语言已知, 且用户代理支持对此语言进行语言学分析, 则用户代理必须检测短语边界。 如果某个词分隔符 字符、 其他空格 分隔符, 或 U+200B ZERO WIDTH SPACE 字符 尚未出现在该边界处, 则 UA 必须插入一个虚拟可扩展分隔符。
就此属性而言, 可扩展 分隔符是以下任意一种:
虚拟 可扩展分隔符是 UA 在文本中检测到的语法边界, 它表示源文档中并未另行出现的可扩展分隔符。 除了用于此属性之外,它没有其他效果。
用户代理不得替换 紧邻强制换行 之前或之后的 可扩展 分隔符 (忽略任何中间的内联盒边界, 以及相关的 margin/border/padding)。
注:因为虚拟可扩展 分隔符 会被放置在参与内联盒边界的最外层元素中, 如果其中一个分隔符会与一个内联盒边界重合, 而其父盒的 使用值 为 word-space-transform: none, 则该特定的虚拟可扩展分隔符不会 被扩展, 因为它会被放置在父盒中。
与 text-transform 一样,此属性仅出于样式 目的变换文本。 它对底层内容没有影响, 且不得影响纯文本复制粘贴操作的内容。
与成人读物不同,面向幼儿的日文书籍通常在句子 片段之间加入空格, 以便于阅读。 有阅读障碍的人也往往觉得这种样式更易读。
在没有任何特定样式的情况下,下面的句子会按如下所示渲染。
< p > むかしむかし、< wbr > あるところに、< wbr > おじいさんと< wbr > おばあさんが< wbr > すんでいました。
むかしむかし、あるところに、おじいさんとおばあさんがすんでいました。
可以使用以下 css 实现基于短语的间距:
p {
word-space-transform : ideographic-space;
}
むかしむかし、 あるところに、 おじいさんと おばあさんが すんでいました。
另一种常见变体还会将允许的断行限制在这些短语边界处。 使用相同标记,可以通过以下 css 轻松实现:
p {
word-break : keep-all;
word-space-transform : ideographic-space;
}
むかしむかし、
除了使源代码更易读之外,
在标记中使用
wbr
而不是 U+200B,
还允许作者将分隔符分类到不同组中。
在下面的示例中,
wbr
元素在分隔词时要么
不作标记,
要么在同时分隔短语时使用 class p 标记。
< p > らいしゅう< wbr > の< wbr > じゅぎょう< wbr > に< wbr class = p > たいこ< wbr > と< wbr > ばち< wbr > を< wbr class = p > もって< wbr > きて< wbr > ください。
借助这种方式,不仅可以启用相当常见的基于短语的间距, 还可以启用逐词间距, 这很可能是有阅读障碍的人为了减少歧义 而更偏好的方式, 或者启用其他变体, 例如将基于短语的间距与基于词的换行相结合。
らいしゅう
p wbr.p {
word-space-transform : ideographic-space;
}
らいしゅう
p wbr {
word-space-transform : ideographic-space;
}
らいしゅう
p {
word-break : keep-all;
}
p wbr.p {
word-space-transform : ideographic-space;
}
らいしゅう
p {
word-break : keep-all;
}
p wbr {
word-space-transform : ideographic-space;
}
らいしゅう
2.3. 操作顺序
当需要应用多个变换时, 它们按以下顺序应用:
词间空格变换和 文本变换发生在 § 4.3.1 阶段 I:折叠和 变换之后, 但在 § 4.3.2 阶段 II:修剪和定位之前。 例如,这意味着 full-width 只会在保留的空白中 将空格(U+0020)变换为 U+3000 IDEOGRAPHIC SPACE。
注:如附录 A: 文本处理操作顺序所定义, 变换会影响断行和其他格式化操作。
3. 空白和换行:white-space 属性
| 名称: | white-space |
|---|---|
| 值: | normal | pre | pre-wrap | pre-line | <'white-space-collapse'> || <'text-wrap-mode'> || <'white-space-trim'> |
| 初始值: | normal |
| 适用于: | 文本 |
| 继承: | 见各单项属性 |
| 百分比: | 不适用 |
| 计算值: | 指定的关键字 |
| 规范顺序: | 不适用 |
| 动画类型: | 离散 |
此属性是 white-space-collapse、text-wrap-mode 和 white-space-trim 的简写。 它指定两件事:
注:此简写组合了可继承属性和 不可继承属性。 如果这是一个问题,请告知 CSSWG。
下表给出了简写特殊关键字的值 到其等价单项属性值的规范性映射。
| white-space | white-space-collapse | text-wrap-mode | white-space-trim |
|---|---|---|---|
| normal | collapse | wrap | none |
| pre | preserve | nowrap | none |
| pre-wrap | preserve | wrap | none |
| pre-line | preserve-breaks | wrap | none |
注:在某些情况下, 保留的空白 和其他空格分隔符 在行尾时可以悬挂; 这会影响它们是否参与固有 尺寸测量。
以下资料性表格总结了 各种 white-space 值的行为:
| 换行符 | 空格和制表符 | 文本换行 | 行尾空格 | 行尾其他空格分隔符 | |
|---|---|---|---|---|---|
| normal | 折叠 | 折叠 | 换行 | 移除 | 悬挂 |
| pre | 保留 | 保留 | 不换行 | 保留 | 不换行 |
| nowrap | 折叠 | 折叠 | 不换行 | 移除 | 悬挂 |
| pre-wrap | 保留 | 保留 | 换行 | 悬挂 | 悬挂 |
| break-spaces | 保留 | 保留 | 换行 | 换行 | 换行 |
| pre-line | 保留 | 折叠 | 换行 | 移除 | 悬挂 |
4. 空白处理和控制字符
文档的源文本通常包含 与最终渲染无关的格式: 例如, 为方便编辑而将源文本分割成片段 (行), 或添加空白字符 例如制表符和空格 来缩进源代码。 CSS 空白处理允许作者 控制对此类格式的解释: 在渲染文档时保留它或将其折叠掉。 CSS 中的空白处理 (由 white-space-collapse 和 white-space-trim 属性控制) 仅为渲染解释空白字符: 它对底层文档数据没有影响。
注:取决于文档语言,
片段可以由特定的换行序列分隔
(例如换行符或 CRLF 对),
或由某种其他机制定界,
例如 SGML RECORD-START 和 RECORD-END 记号。
对于 CSS 处理, 每个由文档语言定义的“分段符”或“换行序列”——如果没有定义,则为文本中的每个换行符 (U+000A)——都被视为一个分段符, 随后按照 white-space 属性的规定解释为渲染结果。
对于 HTML, 换行会被规范化为换行符(U+000A) 以便在 DOM 中表示, 因此当 HTML 文档表示为 DOM 树时, 每个换行符(U+000A) 都会被视为一个分段符。 [HTML] [DOM]
注:在大多数常见的 CSS 实现中, HTML 不会被直接设置样式。 相反,它会被处理成 DOM 树, 随后再设置样式。 与 HTML 不同, DOM 不会赋予回车符(U+000D)任何特定含义, 因此它们不会被视为分段 符。 如果回车符(U+000D)通过 HTML 解析以外的方式 被插入 DOM, 则它们会按下文定义处理。
注:文档解析器可能 不仅会规范化任何分段 符, 还会根据标记规则折叠其他空格字符 或以其他方式处理空白。 因为 CSS 处理发生在解析阶段之后, 所以无法为了样式恢复这些字符。 因此,下文规定的某些行为 可能会受到这些限制影响, 并且可能取决于用户代理。
注:完全由可折叠空白组成的匿名块 会从渲染树中移除。 因此,块级元素周围的任何此类空白 都会被折叠掉。 参见 CSS 2 § 9.2.2.1 Anonymous inline boxes。 [CSS2]
控制字符(Unicode
类别 Cc)——除了制表符(U+0009)、
换行符(U+000A)、
回车符(U+000D)
以及形成分段
符的序列之外——必须渲染为可见字形,
如果在字体中找到的字形不可见,则 UA 必须合成该字形,
并且必须在其他方面将其视为
Other Symbols(So)通用类别
和 Common 文字的任何其他字符。
UA 可以使用字体中专门为该控制字符提供的字形,
替换为 Control Pictures 块中对应符号所提供的字形,
生成其码点值的视觉表示,
或使用其他方法提供适当的可见字形。
按 Unicode 要求,
不支持的 Default_ignorable 字符
必须在文本渲染中被忽略。
[UNICODE]
回车符(U+000D)在所有方面都被等同于空格(U+0020)处理。
注:对于 HTML 文档,
源代码中存在的回车符
会在解析阶段转换为换行符
(参见 HTML
§ 13.2.3.5 Preprocessing the input stream
以及 Infra 中normalize
newlines 的定义,
因而不会作为 U+000D CARRIAGE RETURN 出现在 CSS 中。
[HTML]
[INFRA])
然而,当使用转义序列(
4.1. 空白折叠:white-space-collapse 属性
| 名称: | white-space-collapse |
|---|---|
| 值: | collapse | discard | preserve | preserve-breaks | preserve-spaces | break-spaces |
| 初始值: | collapse |
| 适用于: | 文本 |
| 继承: | 是 |
| 百分比: | 不适用 |
| 计算值: | 指定的关键字 |
| 规范顺序: | 按语法 |
| 动画类型: | 离散 |
此属性指定 空白 是否以及如何被折叠。 这些值具有以下含义, 必须根据 空白处理规则解释:
- collapse
- 此值指示用户代理将空白序列折叠 为单个字符 (或在某些情况下,没有字符)。
- preserve
- 此值阻止用户代理折叠空白序列。 分段符(例如 换行符) 被保留为强制换行。
- preserve-breaks
- 与 collapse 一样, 此值会折叠连续的空白字符, 但会将源中的分段 符保留为强制换行。
- preserve-spaces
-
此值阻止用户代理
折叠空白序列,
并将制表符和分段符转换为空格。
(此值旨在表示 SVG 中
xml:space="preserve"的行为。) - break-spaces
-
其行为与 preserve 相同,
除了:
注:此值并不保证 绝不会因为空白而发生溢出: 例如,如果行长度短到 连单个空白字符都放不下, 溢出就是不可避免的。
- discard
-
此值指示用户代理“丢弃”
元素中的所有空白。
这是否保留 换行机会?还是不保留?我们是否需要一个不同的 "hide" 值? 如果它保留换行机会, 也许应该将其替换为一个 word-space-transform 值?
未因空白处理而被移除 或折叠的空白 称为保留的空白。
以下样式规则实现 MathML 的空白处理:
@namespace m "http://www.w3.org/1998/Math/MathML";
m|* {
  white-space-collapse: discard;
}
m|mi, m|mn, m|mo, m|ms, m|mtext {
  white-space-trim: discard-inner;
}
4.2. 空白修剪:white-space-trim 属性
| 名称: | white-space-trim |
|---|---|
| 值: | none | discard-before || discard-after || discard-inner |
| 初始值: | none |
| 适用于: | 内联盒和块容器 |
| 继承: | 否 |
| 百分比: | 不适用 |
| 计算值: | 指定的关键字 |
| 规范顺序: | 按语法 |
| 动画类型: | 离散 |
此属性允许作者指定 盒的开头和结尾处的修剪行为。 这些值具有以下含义:
- discard-before
- 此值指示 UA 折叠元素开始处 紧前方的所有可折叠空白。
- discard-after
- 此值指示 UA 折叠元素结束处 紧后方的所有可折叠空白。
- discard-inner
- 对于块容器,此值指示 UA 丢弃 元素开头处直到并包括 元素中第一个非空白字符之前的最后一个分段符为止的 所有空白, 以及丢弃元素结尾处从元素中最后一个 非空白字符之后的第一个分段符开始的 所有空白。 对于其他元素,此值指示 UA 丢弃 元素开头和结尾处的所有空白。
注:使用 white-space-trim 丢弃文档空白 可能会改变文本中软换行机会出现的位置。
以下样式规则将 DT 元素渲染为逗号分隔列表, 即使它们在源文档中被编码在不同行上:
dt { display: inline; }
dt + dt:before { content: ", "; white-space-trim: discard-before; }
以下样式规则会移除 与预格式化块的开始/结束标签相邻的源格式化空白, 但不会移除应用于元素实际内容的 任何缩进或交错空白:
pre { white-space: pre; white-space-trim: discard-inner; }
这会使以下两个源代码片段:
< pre > some preformatted text</ pre >
< pre > some preformatted text</ pre >
  some
preformatted

  text
如果我们改为将其应用于内联元素:
span { white-space: normal; white-space-trim: discard-inner; }
start[< span > some inline text</ span > ]end
start[< span > some inline text</ span > ]end
start[some inline text]end
white-space-trim 的空白处理 发生在 § 4.3.1 阶段 I:折叠和变换之前。
4.3. 空白处理规则
除非另有规定, CSS 中的空白处理仅影响 文档空白字符: 空格(U+0020)、制表符(U+0009),以及分段符。
注:被视为文档空白 (文档内容的一部分) 的字符集合与被视为语法空白 (CSS 语法的一部分) 的字符集合不一定相同。 然而,由于二者都包括空格(U+0020)、制表符(U+0009)和换行符(U+000A), 大多数作者不会注意到任何差异。
除了空格(U+0020) 和不换行空格(U+00A0)之外, Unicode 还定义了若干额外的空格分隔符字符。 [UNICODE] 在本规范中, Unicode 通用类别 Zs 中 除空格(U+0020) 和不换行空格(U+00A0)之外的所有字符 统称为 其他空格 分隔符。
4.3.1. 阶段 I:折叠和变换
注:white-space-trim 会在 此阶段之前被纳入考虑。
对于内联格式化上下文中的每个内联
(包括匿名内联;
参见 CSS 2 § 9.2.2.1 Anonymous
inline boxes [CSS2]),
在断
行和双向
重排之前,
空白字符按如下方式
处理,
并忽略双向
格式化字符
(具有 Bidi_Control 属性的字符 [UAX9]),
就像它们不存在一样:
- 如果 white-space-collapse 被设置为 collapse 或 preserve-breaks, 空白字符 被视为可折叠, 并通过执行以下步骤进行处理:
- 如果 white-space-collapse 被设置为 preserve-spaces, 每个制表符和分段符都会被转换为一个空格。
- 如果 white-space-collapse 被设置为 preserve 或 preserve-spaces, 任何空格序列都被视为不换行空格序列, 但 在每个由空格和/或制表符组成的最大序列末尾 存在一个软换行 机会。 对于 break-spaces, 每个空格和每个制表符之后 都存在一个软换行机会。
<ltr>A <rtl> B </rtl> C</ltr>其中 <ltr> 元素表示从左到右的嵌入,
而 <rtl> 元素表示从右到左的嵌入。
如果 white-space 属性被设置为 normal,
空白处理模型将产生以下结果:
这会留下两个空格, 一个位于从左到右嵌入级别中的 A 之后, 另一个位于从右到左嵌入级别中的 B 之后。 随后文本会根据 Unicode 双向算法排序, 最终结果为:
A BC
注意,A 和 B 之间会有两个空格, 而 B 和 C 之间没有空格。 最好通过将空格放在元素外部 而不是仅放在开始和结束标签内部来避免这种情况, 并且在可行时, 依赖隐式双向性而不是显式嵌入级别。
4.3.2. 阶段 II:修剪和定位
然后,渲染整个块。 内联内容被布局, 并考虑双向重排, 以及由 text-wrap-mode 和 text-wrap-style 属性指定的换行。 当每一行被布局时,
- 行首的一段可折叠空格序列 会被移除。
-
如果制表符大小为零,
保留的
制表符不会被渲染。
否则,每个保留的制表符会被渲染
为一次水平偏移,使下一个字形的起始边
与下一个制表位对齐。
如果此距离小于 0.5ch,
则改用随后的制表位。
制表
位出现在
从保留的制表符最近的块容器祖先的起始内容边
起算的
制表符大小的倍数位置。
制表符大小由 tab-size
属性给出。
注:参见 Unicode 关于制表(U+0009)如何与双向性相互作用的规则。[UAX9]
-
行尾的一段可折叠空格序列
会被移除,
任何尾随的 U+1680 OGHAM SPACE MARK 也会被移除,
前提是其 white-space-collapse 属性为 collapse 或 preserve-breaks。
注:由于 Unicode Bidirectional Algorithm 规则 L1, 在双向重排之前 位于行尾的一段可折叠空格序列 在重排之后也会位于行尾。 [UAX9] [CSS-WRITING-MODES-4]
-
如果在行尾仍有任何空白、
其他空格
分隔符
和/或保留的制表符序列
(在双向重排之后 [CSS-WRITING-MODES-4]):
- 如果 white-space-collapse 为 collapse 或 preserve-breaks, UA 必须(无条件地)悬挂此序列。
-
如果 white-space-collapse 为 preserve
且 text-wrap-mode 不是 nowrap,
UA 必须(无条件地)悬挂
此序列,
除非该序列后面跟着一个强制换行,
在这种情况下,它必须改为有条件地悬挂该序列。
它还可以在视觉上折叠
任何原本会溢出的字符前进宽度。
注:让空白悬挂而不是折叠它, 可让用户在选择或编辑文本时看到该空格。
-
如果 white-space-collapse 被设置为 break-spaces,
空格、制表符和其他空格
分隔符
会被与其他可见字符相同地处理:
它们既不能悬挂,
其前进宽度也不能被折叠。
注:因此,此类字符会占用 空间, 并且取决于可用空间 和适用的断行控制, 要么会溢出,要么会导致该行换行。
对于 white-space-collapse: preserve-spaces, 这里应当发生什么?
p {
white-space : pre-wrap;
width : 5 ch ;
border : solid 1 px ;
font-family : monospace;
text-align : center;
}
< p > 0</ p >
上面的示例会渲染如下:
由于最后一个空格位于强制 换行之前 且不会溢出, 因此它不会悬挂, 居中也会按预期工作。
p {
white-space : pre-wrap;
width : 3 ch ;
border : solid 1 px ;
font-family : monospace;
}
< p > 0 0 0 0</ p >
上面的示例会渲染如下:
0 0
0
如果添加 p ,
结果将如下:
0 0
0
由于没有强制换行的行尾的保留的空格必须悬挂, 因此在文本对齐期间放置行内其余内容时不会考虑它们。 当向结束边对齐时, 这意味着任何此类空格都会溢出, 并且不会阻止该行其余内容与行边缘齐平。 另一方面, 带有强制换行的行尾的保留空格会有条件地 悬挂。 由于在此示例中最后一行末尾的空格不会溢出, 因此它不会悬挂, 从而会在文本对齐期间被考虑。
p {
white-space : pre-wrap;
width : 3 ch ;
border : solid 1 px ;
font-family : monospace;
}
< p > 0 0 0 0</ p >
0 0
最后一行不会在最后一个 0 之前换行,
因为在测量该行内容是否适合时,
不会考虑那些有条件地悬挂的字符。
4.3.3. 分段符变换规则
当 white-space-collapse 不是 collapse 时, 分段符不是可折叠的。 对于除 collapse 或 preserve-spaces (会将它们转换为空格) 之外的值, 分段符会改为转换为保留的换行符 (U+000A)。
当 white-space-collapse 为 collapse 时, 分段符是可折叠的, 并按如下方式折叠:
- 首先,任何紧跟另一个可折叠分段符之后的 可折叠分段符 会被移除。
- 然后,任何剩余的分段 符 要么被转换为空格(U+0020), 要么被移除, 具体取决于该断点前后的上下文。 此操作的规则在本级中由 UA 定义。
Here is an English paragraph
that is broken into multiple lines
in the source code so that it can
be more easily read and edited
in a text editor.
Here is an English paragraph that is broken into multiple lines in the source code so that it can be more easily read and edited in a text editor.
在没有词分隔符的语言中,例如中文, “取消换行”要求将两行连接起来,中间不插入空格。
這個段落是那麼長,
在一行寫不行。最好
用三行寫。
這個段落是那麼長,在一行寫不行。最好用三行寫。
分段符变换规则可以使用相邻上下文, 将分段符转换为空格 或将其完全消除。
注:从历史上看,HTML 和 CSS 会无条件地 将分段符转换为 空格, 这阻止了以中文等语言创作的内容 在源代码中进行断行。 因此,UA 启发式规则在决定何处丢弃分段符时需要保持保守, 即便它们努力改进对此类语言的支持。
4.4. 制表符大小:tab-size 属性
| 名称: | tab-size |
|---|---|
| 值: | <number [0,∞]> | <length [0,∞]> |
| 初始值: | 8 |
| 适用于: | 文本 |
| 继承: | 是 |
| 百分比: | 不适用 |
| 计算值: | 指定的数字或绝对长度 |
| 规范顺序: | 不适用 |
| 动画类型: | 按计算值类型 |
此属性确定用于渲染保留的制表符字符(U+0009)的制表符 大小。 <number> 表示 作为该保留的制表符最近的块容器祖先的空格字符(U+0020)前进宽度的倍数 的度量, 包括其关联的 letter-spacing 和 word-spacing。 不允许负值。
5. 文本换行
当内联级内容被布局到多行中时,它会跨行盒断开。 这样的断开称为断 行。 当一行由于显式断行控制 (例如保留的换行字符) 或由于块的开始或结束而断开时, 它就是强制换 行。 当一行由于内容换行 而断开时 (即 UA 为了使内容适应度量宽度而创建非强制断行时), 它就是软换行 断点。 将内联级内容断成多行的过程称为断行。
换行只会在允许的断点处执行, 该断点称为软换行 机会。 当启用换行时(参见 white-space), 如果存在软换行机会, UA 必须通过在该机会处换行 来尽量减少行中溢出的内容量。 有效的软换行机会取决于 内容语言 和书写系统, 以及控制它们的 CSS 属性, 参见 § 6 断行和词边界。
文本允许在哪里换行 由断行规则和控制控制; 它是否允许换行, 以及一行内多个软换行机会如何排序优先级, 由 text-wrap-mode、 text-wrap-style、 wrap-before、 wrap-after 和 wrap-inside 属性控制。
5.1. 决定是否换行:text-wrap-mode 属性
| 名称: | text-wrap-mode |
|---|---|
| 值: | wrap | nowrap |
| 初始值: | wrap |
| 适用于: | 文本 |
| 继承: | 是 |
| 百分比: | 不适用 |
| 计算值: | 指定的关键字 |
| 规范顺序: | 按语法 |
| 动画类型: | 离散 |
注:此属性同时是 单项属性, 属于 white-space 和 text-wrap。
可能的值:
- wrap
-
为了尽量减少内联轴溢出,
行可以在生效的断行规则所确定的允许软换行
机会处换行。
注:关于软换行机会的规则和约束的更多信息, 参见 § 6.5 断行细节。
- nowrap
- 行只在强制换行处断开; 不适合块容器宽度的内容会从其中溢出。
无论 text-wrap-mode 的值如何,
保留的分段符,
以及任何具有 BK、CR、LF 和 NL
断行类别的 Unicode 字符,
都必须被视为强制
换行。
[UAX14]
注:此类强制换行 的双向性影响由 Unicode 双向 算法定义。 [UAX9]
5.2. 控制盒内断行:wrap-inside 属性
| 名称: | wrap-inside |
|---|---|
| 值: | auto | avoid |
| 初始值: | auto |
| 适用于: | 内联盒 |
| 继承: | 否 |
| 百分比: | 不适用 |
| 计算值: | 指定的关键字 |
| 规范顺序: | 按语法 |
| 动画类型: | 离散 |
- auto
- 行可以在盒内的允许断点处断开, 具体由生效的断行规则决定。
- avoid
-
盒内的断行会被抑制:
只有当该行没有其他有效断点时,
UA 才可以在盒内断行。
如果文本发生断行,
断行限制会像
auto 一样得到遵守。
如果具有 avoid 的盒相互嵌套, 且 UA 必须在这些盒内断行, 则必须先使用外层盒中的断点, 才能使用内层盒中的断点。
5.2.1. 在呈现页脚时使用 'wrap-inside: avoid' 的示例
可以设置断点的优先级, 以反映预期的文本分组。
给定以下规则
footer { wrap-inside: avoid; }
venue { wrap-inside: avoid; }
date { wrap-inside: avoid; }
place { wrap-inside: avoid; }
以及以下标记:
<footer> <venue>27th Internationalization and Unicode Conference</venue> • <date>April 7, 2005</date> • <place>Berlin, Germany</place> </footer>
在较窄的窗口中,页脚可以断为
27th Internationalization and Unicode Conference •
April 7, 2005 • Berlin, Germany
或者在更窄的窗口中断为
27th Internationalization and Unicode
Conference • April 7, 2005 •
Berlin, Germany
但不能断为
27th Internationalization and Unicode Conference • April
7, 2005 • Berlin, Germany
5.3. 控制盒之间的断行:wrap-before/wrap-after 属性
| 名称: | wrap-before, wrap-after |
|---|---|
| 值: | auto | avoid | avoid-line | avoid-flex | line | flex |
| 初始值: | auto |
| 适用于: | 内联级盒和弹性项目 |
| 继承: | 否 |
| 百分比: | 不适用 |
| 计算值: | 指定的关键字 |
| 规范顺序: | 按语法 |
| 动画类型: | 离散 |
这些属性指定对断行中的断行机会 (以及弹性行断行 [CSS3-FLEXBOX]) 的修改。 可能的值:
- auto
- 行可以在盒之前和之后的允许断点处断开, 具体由生效的断行规则决定。
- avoid
- 紧邻盒之前/之后的断行会被抑制: 只有当该行 没有其他有效断点时, UA 才可以在那里断行。 如果文本发生断行, 断行限制会像 auto 一样得到遵守。
- avoid-line
- 与 avoid 相同, 但仅适用于行断行。
- avoid-flex
- 与 avoid 相同, 但仅适用于弹性行断行。
- line
- 如果该盒是内联级盒, 则在该盒之前/之后立即强制断行。
- flex
- 如果该盒是多行弹性容器中的弹性项目, 则在该盒之前/之后立即强制一个弹性行断行。
内联级盒上的强制断行会向上传播, 经过任何父内联盒, 其方式与块级盒上的强制断裂 在同一分片上下文中 经过任何父块盒 向上传播的方式相同。 [CSS3-BREAK]
5.4. 选择如何换行:text-wrap-style 属性
| 名称: | text-wrap-style |
|---|---|
| 值: | auto | balance | stable | pretty | avoid-short-last-line |
| 初始值: | auto |
| 适用于: | 建立内联格式化上下文的块容器 |
| 继承: | 是 |
| 百分比: | 不适用 |
| 计算值: | 指定的关键字 |
| 规范顺序: | 按语法 |
| 动画类型: | 离散 |
当允许换行时 (参见 text-wrap-mode), 此属性在几种行换行方式之间进行选择, 在速度、布局质量与样式或稳定性之间进行权衡。 它不会改变存在哪些软换行机会, 但会改变用户代理从中进行选择的方式。 可能的值:
- auto
- 用于选择在哪个软 换行机会处断行的确切算法由 UA 定义。 该算法在作出断行决策时 可以考虑多行。 UA 可以偏向速度而非最佳布局。 UA 不得像 balance 那样尝试使所有行 (包括最后一行)均匀分布。 此值选择 UA 首选的(或与 Web 最兼容的) 换行算法。
- balance
-
如果可以达到比 auto 更好的平衡,
则选择换行位置以平衡
每个行框中的剩余(空白)空间。
这应该避免改变——而在 5 行或更少的情况下不得改变——
当 text-wrap 被设置为 auto 时该块所包含的行
框数量。
注: 不过,行框的高度仍可能 发生变化, 这是由于同一行上共同出现的内容发生了变化。
要考虑的剩余空间 是放置浮动和内联内容之后所剩余的空间, 但不包括因文本两端对齐而作出的任何调整。 当每个行框中剩余空间的平均内联尺寸的标准差 在整个块中有所降低时, 行框即被视为已平衡 (包括以强制换行结束的行)。
由强制换行分隔的各组行 分别处理。 如果元素受 line-clamp 影响, 则先应用截断效果, 然后对剩余行进行平衡。
确切算法由 UA 定义。
如果需要平衡的行超过十行,UA 可以将此值视为 auto。
- stable
- 指定在作出断行决策时 不应考虑后续行上的内容, 从而在编辑文本时使光标之前的任何内容 保持稳定; 除此之外等同于 auto,
- pretty
-
指定 UA 应偏向更好的布局而非速度,
并预期在作出断行决策时
考虑多行。
除此之外等同于 auto。
除其他事项外,用户代理可以 尝试避免过短的最后一行, 类似于 avoid-short-last-line, 但它还应以其他方式改进布局。 具体的改进集合取决于用户代理, 其中可以包括诸如: 减少各行之间长度的差异; 避免排版河流; 对不同类别的软换行机会、断字 机会或两端对齐机会给予不同优先级; 避免连续太多行使用断字……
所需的计算可能开销很大, 特别是在应用于大量文本时。 建议作者在使用 text-wrap-style: pretty 时 评估其对性能的影响, 并可以只在最重要的地方选择性地使用它。 - avoid-short-last-line
-
指定 UA 应避免过短的最后一行,
并预期在作出断行决策时
考虑多于一行
(例如,避免通过使前一行过短来“修复”孤行)。
如果改进最后一行会使之前的某些行严重失衡,
用户代理可以决定不对最后一行进行改进。
如果改进布局的其他方面会带来显著的性能开销,
则用户代理不应尝试作出超出 auto
所提供范围的改进。
注: 在西文排版中,“孤行”可以 指段落最后一行上的单个单词。 然而,并非所有语言或书写系统都在单词边界处换行, 即使是在这样做的语言中, 最后一行上的几个很短的单词仍可能不理想, 尤其是在可用内联空间很长的情况下。 因此,本规范并未严格规定 只有由单个单词组成的行才算过短, 而是让用户代理判断什么情况属于过短。
注: 另请参阅 orphans 属性,以控制分片 以及“孤行”的另一种排版含义。
例如,在给定的行长度下,下面的文本会换行,使最后一行只有一个单词, 这可能会被认为过短。ἄνδρα μοι ἔννεπε, μοῦσα, πολύτροπον, ὃς μάλα πολλὰ πλάγχθη, ἐπεὶ Τροίης ἱερὸν πτολίεθρον ἔπερσεν.
应用 text-wrap-style: avoid-short-last-line 后则可能得到 类似下面这样的结果, 可以说更加美观:ἄνδρα μοι ἔννεπε, μοῦσα, πολύτροπον, ὃς μάλα πολλὰ πλάγχθη, ἐπεὶ Τροίης ἱερὸν πτολίεθρον ἔπερσεν.
然而,下面的片段更棘手:环绕航行 密西西比 河流
尝试通过让前一行更早换行来使最后一行不那么短,会得到 以下结果:环绕航行 密西西比 河流
虽然最后一行确实不再那么短, 但倒数第二行会很难看。 在这种情况下,即使设置了 text-wrap-style: avoid-short-last-line, 用户代理仍应优先采用第一种呈现方式。
注: auto 值通常会 映射到 Web 浏览器快速的传统断行方式, 这种方式迄今为止一直使用首次适配/贪心算法, 而这些算法往往会产生次优结果。 UA 可以使用此默认值试验更好的断行算法, 但由于最佳结果通常需要花费更多时间, 因此提供了 pretty 和 avoid-short-last-line 作为选择加入的方式, 以花费更多时间获得更好的结果。 这两个值都适用于正文文本, 其中最后一行通常预期比平均行稍短, 但 avoid-short-last-line 旨在避免 过短的最后一行,同时保持良好的性能, 而 pretty 可以牺牲更多速度 以追求更好的布局; balance 值适用于标题和说明文字, 在这些位置通常更倾向于长度相等的文本行; 而 stable 适用于那些 可编辑或可能被切换为 可编辑状态的部分。
- 至少与 text-indent 一样长。
- 至少 X 个字符。
- 基于百分比。
建议的值空间为 match-indent | <length> | <percentage> (以 Xch 作为示例来明确说明该用例)。 或者,<integer> 实际上可以用来计算字符数量。
目前尚不清楚这将如何与文本平衡(见上文)交互; 较早的一项提案曾将它们设计为同一个属性 (其中 100% 表示完全平衡)。
有人请求基于单词的限制,但由于这实际上 取决于单词的长度,因此基于字符的方式更好。
5.5. 联合换行控制:text-wrap 简写属性
| 名称: | text-wrap |
|---|---|
| 值: | <'text-wrap-mode'> || <'text-wrap-style'> |
| 初始值: | wrap |
| 适用于: | 见各单项属性 |
| 继承: | 见各单项属性 |
| 百分比: | 见各单项属性 |
| 计算值: | 见各单项属性 |
| 规范顺序: | 按语法 |
| 动画类型: | 见各单项属性 |
此属性是 text-wrap-mode 和 text-wrap-style 属性的简写。 任何省略的单项属性都会被设置为其初始值。
6. 断行和词边界
在大多数书写系统中, 在没有连字符断字的情况下,软换行机会通常只出现在词边界处。 许多这样的系统(例如使用拉丁字母书写的英语) 使用空格或标点来显式 分隔词, 而软换行机会可以通过这些 字符识别。
然而,泰文、老挝文和高棉文等文字 不使用空格或标点来分隔词。 虽然零宽空格(U+200B)可在这些文字中用作显式词分隔符, 但这种做法并不常见。 因此,需要词汇资源 才能在此类文本中正确识别软换行机会。
在其他一些书写系统中, 尤其是爪哇文和巴厘文等婆罗米系文字, 软换行 机会基于正字法音节边界, 而不是词边界。 虽然正字法音节断行 不依赖内容语言 或词汇资源, 但仍然需要分析文本 以寻找断行机会。
在其他书写系统中,例如中文(以及日文、彝文,有时还有韩文), 每个音节往往对应一个排版字母单位, 因而断行惯例允许行在几乎任何地方断开, 除了某些字符组合之间。 此外,这些限制的严格程度 会随排版样式而变化。
虽然 CSS 并不完整定义软换行机会出现的位置, 但提供了一些控制以区分常见变体:
- line-break 属性允许选择断行限制的 各种“严格度”等级。
- word-break 属性控制哪些类型的字母 会粘连在一起形成不可断开的“词”, 使 CJK 字符像非 CJK 文本那样行为,或反之亦然, 从而控制东南亚语言中的词检测, 或允许将词分组成短语……
- hyphens 属性控制是否允许自动连字符断字 断开会使用连字符断字的文字中的词。
- overflow-wrap 属性允许 UA 在否则不可断开的字符串中的 任意位置断开,以避免原本会发生的溢出。
注:Unicode 标准附录 #14:Unicode 断行 算法 为 Unicode 中所有文字的断行定义了 基线行为, 预期还会进一步定制。 [UAX14] 关于断行惯例的更多信息, 可见于日文的 日文文本 布局需求 [JLREQ] 和 日文文档格式化规则 [JIS4051], 中文的中文文本布局需求 [CLREQ] 和 标点符号用法 [ZHMARK]。 另请参见 国际化工作组的 语言支持索引, 其中包含关于其他语言的更多信息。 [TYPOGRAPHY] 如能提供关于其他适当参考资料的任何指导, 将不胜感激。
6.1. 字母断行规则:word-break 属性
| 名称: | word-break |
|---|---|
| 值: | normal | break-all | keep-all | manual | auto-phrase | break-word |
| 初始值: | normal |
| 适用于: | 文本 |
| 继承: | 是 |
| 百分比: | 不适用 |
| 计算值: | 指定的关键字 |
| 规范顺序: | 不适用 |
| 动画类型: | 离散 |
此属性指定“词”之间以及“词”内部的软换行机会, 即文本行在何处“正常”且允许断开。 它侧重于字母之间的断开, 并不定义空白和其他空格 分隔符 是否以及如何产生软换行 机会 (尽管 auto-phrase 可能会抑制其中一些), 也不定义标点周围的机会。 (关于影响标点和小假名的控制,参见 line-break。)
具体而言,
word-break 控制相邻排版字母单位之间
是否通常存在软换行机会,
为此目的(仅限于此),会将属于
NU、
AL、
AI、
或 ID
Unicode 断行类别的非字母排版字符
单位
视为排版字母单位。
[UAX14]
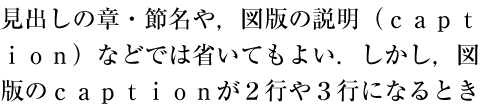
另一个例子是,韩语有两种断行样式: 在任意两个韩文音节之间断开(word-break: normal), 或像英语一样,主要在空格处断开(word-break: keep-all)。
각 줄의 마지막에 한글이 올 때 줄 나눔 기
준을 “글자” 또는 “어절” 단위로 한다.
각 줄의 마지막에 한글이 올 때 줄 나눔
기준을 “글자” 또는 “어절” 단위로 한다.
埃塞俄比亚文同样有两种断行样式, 要么只在词 分隔符处断开(word-break: normal), 要么也允许在词内的字母之间断开(word-break: break-all)。
ተወልዱ፡ኵሉ፡ሰብእ፡ግዑዛን፡ወዕሩያን፡
በማዕረግ፡ወብሕግ።ቦሙ፡ኅሊና፡ወዐቅል፡
ወይትጌበሩ፡አሐዱ፡ምስለ፡አሀዱ፡
በመንፈሰ፡እኍና።
ተወልዱ፡ኵሉ፡ሰብእ፡ግዑዛን፡ወዕሩያን፡በማ
ዕረግ፡ወብሕግ።ቦሙ፡ኅሊና፡ወዐቅል፡ወይትጌ
በሩ፡አሐዱ፡ምስለ፡አሀዱ፡በመንፈሰ፡እኍና።
注:若只想在溢出情况下启用额外断行机会, 参见 overflow-wrap。
这些值具有以下含义:
- normal
-
词按照其惯常规则断开,
如上文所述。
韩语通常表现出两种不同的行为,
它允许在任意两个连续的韩文/汉字之间断开。
对于同样表现出两种不同行为的埃塞俄比亚文,
不允许在词内进行此类断开。
某些书写系统需要特定处理, 才能获得惯常期望的软换行机会, 如 § 6.1.1 分析式词断行中所述。
- break-all
-
允许在“词”内断行:
具体而言,
除了 normal 允许的软换行机会之外,
任何排版字母单位
(以及任何解析为
NU(“数字”)、AL(“字母”)、 或SA(“东南亚”) 断行类别 [UAX14] 的排版字符单位) 都会改为被视为ID(“表意字符”) 用于断行目的。 不应用连字符断字。注:此值不会影响 标点字符周围是否存在软换行机会。 若要允许在任何位置断开,参见 line-break: anywhere。
注:此选项启用埃塞俄比亚文的另一种常见 行为。 它也常用于文本主要由 CJK 字符组成、 只包含较短非 CJK 摘录的场景, 并希望文本在每一行上分布得更好。
- keep-all
-
禁止在“词”内断行:
会抑制排版字母单位之间
(或属于
NU、AL、AI、 或IDUnicode 断行类别 [UAX14] 的其他排版字符单位之间) 的隐式软 换行机会, 即禁止在此类字符对之间断开 (无论 line-break 设置为何,除 anywhere 之外), 除非机会来自 § 6.1.1.1 词汇断行。 否则此选项等同于 normal。 在这种样式下,CJK 字符序列不会断开。注:这是韩语的另一种常见行为 (韩语在词之间使用空格), 也适用于混合文字文本,其中 CJK 片段混入 另一种使用空格分隔的语言中。
- manual
-
行为与 normal 相同,
但
不得执行§ 6.1.1.1 词汇断行。
具体而言,
在 [UAX14]
中具有 SA 类别的排版字符单位
必须被视为具有 AL 类别
(即假设 line-break 的值不是 anywhere,
此类字符对之间不存在软换行机会)。
注:此值不会影响 巴厘文等语言中词内基于音节的软换行机会。 (关于此类书写系统的一些讨论,参见 § 6.1.1.2 正字法断行。)
或者, 此值可以基于 keep-all 而不是 normal。 另一种变体是将此行为 与 keep-all 合并。
注:一些东南亚语言经常被用户代理误检测。 使用 word-break: normal 时, 它们随后会应用不适当的特定语言逻辑 来寻找换行机会, 并将这些机会放在不合适的位置。例如, 除泰语之外的许多语言也使用泰文字母书写, 若像处理泰语那样对其断行, 通常会产生不充分——甚至可能令人困惑——的结果。
发生这种情况时, 此值允许作者关闭 用户代理为 word-break: normal 内置的词边界检测, 以便他们可以手动标记文本来指示换行机会, 并获得合理结果。
- auto-phrase
-
行为与 normal 相同,
但
此值指示用户代理执行特定语言的内容分析,
以优先保持自然短语(由多个词组成)在一起。
如果元素的内容 语言未知, 或者用户代理不知道如何为该特定语言 检测短语边界, 则此值必须表现为 normal。 否则, 用户代理应检测短语边界, 并抑制每个短语内部的软换行机会。
无论内容语言 和对短语边界检测的支持如何, 连字符断字机会都会被抑制, 就像指定了 hyphens: none 一样。
注:为某种语言设计的词边界检测系统 是否适合该语言的部分或全部方言,这在一定程度上是主观的, 本规范将其留给用户代理自行决定。 即使某个检测系统无法处理 某种特定方言的所有细微差别, 只要该检测大多数时候能正确识别词边界, 声称支持也可能是合理的。 然而,如果用户代理声称支持某些语言, 但它无法检测出大多数词边界 或错误率很高, 则会损害作者和用户的利益。如果用户代理有一个用于粤语的词边界检测系统, 但该系统不适合更广泛的中文语言集合, 那么 auto-phrase 应对标记为 lang=yue、lang=zh-yue 或 lang=zh-HK 的内容产生效果, 但不应对 lang=zh 或 lang=zh-Hant 产生效果。然而,如果用户代理支持适用于一般中文的 通用词边界检测系统, 那么 auto-phrase 应对 使用宽泛 lang=zh 特征标记的内容 产生效果, 也应对任何更具体的标记产生效果, 例如 lang=zh-yue、lang=zh-Hant-HK、 lang=zh-Hans-SG 或 lang=zh-hak。
以与特定类别字母相同方式断行的符号 会受到与这些字母相同的影响。
这是一些汉字 and some Latin و کمی خط عربی และตัวอย่างการเขียนภาษาไทย በጽሑፍ፡ማራዘሙን፡አንዳንድ፡
断点按如下方式确定(用“·”表示):
- word-break: normal
-
这·是·一·些·汉·字·and·some·Latin·و·کمی·خط·عربی·และ·ตัวอย่าง·การเขียน·ภาษาไทย·በጽሑፍ፡·ማራዘሙን፡·አንዳንድ፡
- word-break: break-all
-
这·是·一·些·汉·字·a·n·d·s·o·m·e·L·a·t·i·n·و·ﮐ·ﻤ·ﻰ·ﺧ·ﻁ·ﻋ·ﺮ·ﺑ·ﻰ·แ·ล·ะ·ตั·ว·อ·ย่·า·ง·ก·า·ร·เ·ขี·ย·น·ภ·า·ษ·า·ไ·ท·ย·በ·ጽ·ሑ·ፍ፡·ማ·ራ·ዘ·ሙ·ን፡·አ·ን·ዳ·ን·ድ፡
- word-break: keep-all
-
这是一些汉字·and·some·Latin·و·کمی·خط·عربی·และ·ตัวอย่าง·การเขียน·ภาษาไทย·በጽሑፍ፡·ማራዘሙን፡·አንዳንድ፡
用户代理不得 因此属性的任何值而 抑制以下软 换行机会:
-
由
wbrHTML 元素或 U+200B ZERO WIDTH SPACE 引入的机会 -
由 line-break 属性所要求的机会
word-break 的效果 会在计算固有 尺寸时被纳入考虑。
为了兼容旧内容, word-break 属性还支持 一个已弃用的 break-word 关键字。 指定时,它具有与 word-break: normal 和 overflow-wrap: anywhere 相同的效果, 无论 overflow-wrap 属性的实际值是什么。
6.1.1. 分析式词断行
6.1.1.1. 词汇断行
为了为东南亚语言提供预期的 normal 行为, 在 [UAX14] 中具有 SA 断行类别的排版字符单位 必须被视为具有 AL 类别。 然而,用户代理还必须 分析此类字符序列的内容, 以检测词 边界, 并将每个边界视为一个软换行机会。
由于各种语言都可能使用 带有 SA 类别字符的文字来书写, 如果内容语言 已知, 用户代理应使用此信息 来定制其分析。
6.1.1.2. 正字法断行
对于使用基于正字法音节的断行的文字 (例如巴厘文), UA 必须分析内容, 以找到插入软换行机会的正确位置。
注:在撰写本文时, Unicode 尚未定义如何执行此分析, 并将这些书写系统中的所有字符 都视为具有 AL 断行类别。 然而, 已经提出了一个提案 来解决该问题。 即使它尚非最终版本, 查阅它仍可能具有参考价值。 [L2-22-080R]
6.1.1.3. 回退断行
为了避免意外溢出, 如果用户代理无法执行所需的词汇 或正字法分析, 以便为需要该分析的任何内容语言进行断行——例如缺少 使用 SA 类别字符书写的语言的词典——它必须假定 在该书写系统中的排版字母单位对之间 存在软换行机会。
注:此规定不会仅因 UA 未能在某个文本序列中找到词边界而被触发; 该文本序列很可能就是一个不可断开的单词。 它适用于例如 某个文本序列由高棉字符(U+1780 到 U+17FF)组成, 而用户代理不知道如何确定 高棉文中的词边界的情况。
6.1.2. 表达用户对基于短语断行的偏好
用户代理可以响应用户偏好, 激活 auto-phrase 中描述的特定语言内容分析。 具有此行为的用户代理必须通过 在用户来源中 将 word-break 的声明值设置为 auto-phrase 来做到这一点。
注:这允许作者通过调用 getComputedStyle()
来检测此特性是否已启用,
或者在适当情况下在作者来源中覆盖它。
6.2. 断行严格度:line-break 属性
| 名称: | line-break |
|---|---|
| 值: | auto | loose | normal | strict | anywhere |
| 初始值: | auto |
| 适用于: | 文本 |
| 继承: | 是 |
| 百分比: | 不适用 |
| 计算值: | 指定的关键字 |
| 规范顺序: | 不适用 |
| 动画类型: | 离散 |
此属性指定元素内所应用断行规则的严格度: 尤其是换行如何与 标点和符号相互作用。 这些值具有以下含义:
- auto
- UA 确定要使用的断行限制集合, 并且可以根据行长改变这些限制; 例如,对短行使用一组限制较少的断行规则。
- loose
- 使用限制最少的一组断行规则断开文本。 通常用于短行,例如报纸中。
- normal
- 使用最常见的一组断行规则断开文本。
- strict
- 使用最严格的一组断行规则断开文本。
- anywhere
-
每个排版字符
单位周围
都存在一个软换行机会,
包括任何标点字符
或保留的
空白周围,
或词中间,
不考虑任何禁止断行的限制,
即使这些限制由具有
GL、WJ或ZWJ断行类别的字符引入, 或由 word-break 属性强制要求。 [UAX14] 不得对不同的换行机会设置优先级。 不应用连字符断字。注:此值会触发终端中常见的断行 规则。
注:anywhere 只会在 white-space 设置为 break-spaces 时, 允许行尾的保留的空白 换到下一行, 因为在其他情况下:当它确实对保留的空白产生影响时, 在 white-space: break-spaces 下, 它允许在一段空格序列的第一个空格之前断开, 而单独的 break-spaces 不会这样做。
CSS 区分文本换行规则中的 四个严格度等级。 对于 loose、 normal 和 strict 中每一个实际生效的精确规则集合 由 UA 决定, 并应遵循语言惯例。 然而,对于这三个关键字,本规范确实要求:
-
如果书写系统是中文
或日文,
则以下断点在 normal
和 loose 断行中允许,
否则禁止:
-
在某些类似 CJK 连字符的字符之前断开:
〜 U+301C, ゠ U+30A0
-
在某些类似 CJK 连字符的字符之前断开:
-
如果前一个字符
属于 Unicode 断行类别
ID[UAX14] (包括前一个字符 因 word-break: break-all 而被视为ID的情况), 则以下断点在 loose 断行中允许, 否则禁止:-
在连字符之前断开:
‐ U+2010, – U+2013
-
在连字符之前断开:
- 以下断点在 normal 和 strict 断行中禁止, 而在 loose 中允许:
- 如果书写系统是中文 或日文, 则以下断点在 loose 中允许, 否则禁止:
注:上面列出的要求 只会在 CJK 文本中产生区别。 在仅匹配上述规则 且没有额外规则的实现中, line-break 只会影响 CJK 码点, 除非书写系统被标记为 中文或 日文。 未来级别可能会随着需求变得明确, 为其他书写系统和语言 添加额外的具体规则。
注:CSSWG 认识到,在本规范的未来版本中, 可能需要对断行进行更细粒度的控制, 以满足高端出版需求。
-
不在 U+0021(感叹号,
!)和 字母(Unicode 通用类别L) 之间引入断行机会。 这会防止在字符串 “!important” 中断开。 -
不在 U+002F(斜线,
/)和 字母(Unicode 通用类别L) 之间引入断行机会。 这会防止在 “23/Jan/2024” 等日期中断开。 -
不在 U+007C(竖线,
|)和 字母(Unicode 通用类别L) 之间引入断行机会。 -
如果连字符前面的码点_不是_字母或数字 (Unicode 通用类别
L或Nd), 则不在 U+002D(连字符减号 `-`)和 数字(Unicode 通用类别Nd) 之间引入断行机会。 这会防止在 “-13” 等数字前的负号之后断开, 同时允许在 “ABCD-1234” 和 “1234-5678” 中的连字符之后断开, 例如这些可能出现在长 URL 中。
6.3. 连字符断字:词内的形态断行
6.3.1. 连字符断字控制:hyphens 属性
连字符断字 是对通常不允许断开的词进行受控拆分, 以改进段落布局, 通常是在音节或语素边界处拆分词, 并且常常以视觉方式指示该拆分 (通常通过插入连字符 U+2010)。 在某些情况下,连字符断字还可能改变词的拼写。 无论如何,连字符断字仅是一种渲染效果: 它不得影响底层文档内容, 也不得影响文本选择或搜索。
| 语言 | 未断开 | 之前 | 之后 |
|---|---|---|---|
| 英语 | Unbroken | Un‐ | broken |
| 荷兰语 | cafeetje | café‐ | tje |
| 匈牙利语 | Összeg | Ösz‐ | szeg |
| 普通话 | tú’àn | tú‐ | àn |
| àizēng‐fēnmíng | àizēng‐ | ‐fēnmíng | |
| 维吾尔语 |

|

|

|
| 克里语 |

|

|

|
当一行在一个有效的连字符断字机会处断开时, 就会发生连字符断字; 连字符断字机会是一种软换行机会, 它存在于允许连字符断字的词内部。 在 CSS 中,连字符断字机会由 hyphens 属性控制。 CSS Text Level 3 并未定义连字符断字的精确规则; 但强烈鼓励 UA 优化其断点选择, 并选择适合语言的连字符断字点。
注:由 U+002D - HYPHEN-MINUS 字符 或 U+2010 ‐ HYPHEN 字符引入的软换行机会 不是连字符断字机会, 因为换行时不会创建拆分的视觉指示: 无论该行是否在该点换行, 这些字符都是可见的。
在计算 min-content 固有尺寸时, 会考虑连字符断字机会。
注:这允许表格对其内容进行连字符断字, 而不是让内容溢出其包含块, 这对于像德语这样长词较多的语言尤其重要。
| 名称: | hyphens |
|---|---|
| 值: | none | manual | auto |
| 初始值: | manual |
| 适用于: | 文本 |
| 继承: | 是 |
| 百分比: | 不适用 |
| 计算值: | 指定的关键字 |
| 规范顺序: | 不适用 |
| 动画类型: | 离散 |
此属性控制是否允许连字符断字 在一行文本内部创建更多软换行机会。 这些值具有以下含义:
- none
-
不对词进行连字符断字,
即使词内部的字符
显式定义了连字符断字机会。
注:这不会抑制由始终可见的字符 例如 U+002D - HYPHEN-MINUS 或 U+2010 ‐ HYPHEN 所引入的现有软换行机会。
- manual
- 只有当词内部存在显式提示连字符断字机会的字符时, 才会对词进行连字符断字。 UA 必须使用适当的特定语言连字符断字字符, 并且应像同一点上的自动连字符断字一样, 应用任何适当的拼写变化。
- auto
- 除了条件连字符显式指示的机会之外, 词还可以在由适合语言的连字符断字资源 自动确定的连字符断字机会处断开。 如果一个词包含条件连字符 (­ 或 U+00AD SOFT HYPHEN), 则必须忽略该词中其他位置的自动连字符断字机会, 而优先使用这些条件连字符。 然而,如果即使在此类机会处断开之后, 该词的某一部分仍然太长, 无法放入一行, 则可以使用自动连字符断字机会。
正确的自动连字符断字需要 与被断开文本的语言相适应的连字符断字资源。 因此,UA 只能对内容 语言已知 且自身具有适当连字符断字资源的文本 进行自动连字符断字。
UA 可以使用针对语言定制的启发式规则 将某些词排除在自动连字符断字之外。 例如,UA 可能会尝试通过排除匹配某些大小写和标点模式的词 来避免对专有名词进行连字符断字。 此类启发式规则不由本规范定义。 (注意,此类启发式规则需要因语言而异: 例如英语和德语具有非常不同的大小写惯例。)
就 hyphens 属性而言, 什么构成一个“词”取决于 UA。 然而,在确定词边界时, 必须忽略内联元素边界 和脱离流元素。
由于由条件连字符字符 (例如 U+00AD SOFT HYPHEN) 创建的连字符断字机会 而显示的任何字形 都由该字符表示, 并按照应用于该字符的属性设置样式。
注:当阿拉伯文等塑形文字 因连字符断字而允许在词内断开时, 字符仍会像词未被断开时一样塑形。
 而不是
 。
6.3.2. 连字符:hyphenate-character 属性
| 名称: | hyphenate-character |
|---|---|
| 值: | auto | <string> |
| 初始值: | auto |
| 适用于: | 文本 |
| 继承: | 是 |
| 百分比: | 不适用 |
| 计算值: | 指定的关键字 |
| 规范顺序: | 按语法 |
| 动画类型: | 离散 |
此属性指定 在连字符断字后的词各部分之间显示的字符串。 这些值具有以下含义:
- auto
- 指定用户代理应根据内容语言的排版惯例 找到合适的字符串, 可能来自与连字符断字词典相同的来源。
- <string>
-
指定连字符断字时
出现在连字符断字断点处的字符串。
(此字符串的位置不受影响:
UA 必须根据内容语言的排版惯例
插入该字符串,
默认是在连字符断字断点之前立即插入。)
UA 可以将使用值
截断为有限数量的排版字符单位;
它不得只截断一个排版字符单位的一部分。
注:指定空字符串 "" 是有效的, 并会使 UA 在连字符断字机会处断开, 而不插入可见的连字符断字字符。
[lang]:lang(ojs) { hyphenate-character: "᐀" /* CANADIAN SYLLABICS HYPHEN (U+1400) */ }
注:由自动连字符断字触发的连字符 和由软连字符触发的连字符 都按照 hyphenate-character 渲染。
6.3.3. 连字符断字大小限制:hyphenate-limit-zone 属性
| 名称: | hyphenate-limit-zone |
|---|---|
| 值: | <length-percentage> |
| 初始值: | 0 |
| 适用于: | 块容器 |
| 继承: | 是 |
| 百分比: | 相对于行盒的长度 |
| 计算值: | 计算后的 <length-percentage> 值 |
| 规范顺序: | 按语法 |
| 动画类型: | 按计算值类型 |
hyphenate-limit-zone 是一个好名称吗?欢迎评论/建议。
此属性指定在触发连字符断字之前, 行盒中可以留下的最大未填充空间量 (在两端对齐之前); 触发连字符断字后,会将下一行中某个词的一部分 拉回当前行。
6.3.4. 连字符断字字符限制:hyphenate-limit-chars 属性
| 名称: | hyphenate-limit-chars |
|---|---|
| 值: | [ auto | <integer [0,∞]> ]{1,3} |
| 初始值: | auto |
| 适用于: | 文本 |
| 继承: | 是 |
| 百分比: | 不适用 |
| 计算值: | 三个值,每个值要么是 auto 关键字,要么是整数 |
| 规范顺序: | 按语法 |
| 动画类型: | 按计算值类型 |
此属性指定 连字符断字词中的最少字符数。 如果该词未满足 词中 / 连字符之前 / 连字符之后 所需的最少字符数, 则不得对该词进行连字符断字。 非间距组合标记(Unicode 通用类别 Mn) 和词内标点(Unicode 通用类别 P*) 不计入该最小值。
如果指定了三个值, 第一个值是词中总字符数所需的最小值, 第二个值是连字符断字点之前字符的最小值, 第三个值是连字符断字点之后字符的最小值。 如果缺少第三个值,则它与第二个值相同。 如果缺少第二个值,则它为 auto。 auto 值表示 UA 选择一个适应当前布局的值。
注:除非 UA 能够计算出更好的值, 否则建议 auto 表示 前后各 2 个字符,词总计 5 个字符。
p { hyphenate-limit-chars: auto 3; }
6.3.5. 连字符断字行限制:hyphenate-limit-lines 和 hyphenate-limit-last 属性
| 名称: | hyphenate-limit-lines |
|---|---|
| 值: | no-limit | <integer [0,∞]> |
| 初始值: | no-limit |
| 适用于: | 块容器 |
| 继承: | 是 |
| 百分比: | 不适用 |
| 计算值: | 指定的关键字或整数 |
| 规范顺序: | 按语法 |
| 动画类型: | 按计算值类型 |
此属性指示元素中 连续连字符断字行的最大数量。 no-limit 值表示没有限制。
在某些情况下,用户代理可能无法遵守指定值。 (参见 overflow-wrap。) 由这种紧急断行引入的连字符断字 是否会影响附近的连字符断字点,未作定义。
| 名称: | hyphenate-limit-last |
|---|---|
| 值: | none | always | column | page | spread |
| 初始值: | none |
| 适用于: | 块容器 |
| 继承: | 是 |
| 百分比: | 不适用 |
| 计算值: | 指定的关键字 |
| 规范顺序: | 按语法 |
| 动画类型: | 离散 |
此属性指示元素、栏、页面和跨页末尾处的 连字符断字行为。 跨页是一组同时对读者可见的两个页面。 这些值具有以下含义:
- none
- 不施加限制。
- always
- 元素的最后一个完整行, 或元素内部任何栏、页面或跨页断裂之前的最后一行 不应进行连字符断字。
- column
- 元素内部任何栏、页面或跨页断裂之前的最后一行 不应进行连字符断字。
- page
- 元素内部页面或跨页断裂之前的最后一行 不应进行连字符断字。
- spread
- 元素内部任何跨页断裂之前的最后一行 不应进行连字符断字。
当设置 hyphenate-limit-last: none 时, 一个段落可能被格式化为这样:
This is just a
simple example
to show Antarc-
tica.
使用 'hyphenate-limit-last: always' 会得到:
This is just a
simple example
to        show
Antarctica.
6.4. 溢出换行:overflow-wrap(word-wrap) 属性
| 名称: | overflow-wrap |
|---|---|
| 值: | normal | break-word | anywhere |
| 初始值: | normal |
| 适用于: | 文本 |
| 继承: | 是 |
| 百分比: | 不适用 |
| 计算值: | 指定的关键字 |
| 规范顺序: | 不适用 |
| 动画类型: | 离散 |
此属性指定当一个否则不可断开的字符串 太长而无法放入行盒时, UA 是否可以在一行内原本不允许断开的点处断开, 以防止溢出。 它只有在 white-space 允许换行时才有效。可能的值:
- normal
-
行只能在允许的断点处断开。
然而,
如果一行中没有其他可接受的断点,
则可以放宽由 word-break: keep-all 引入的限制,
使其匹配 word-break: normal。
此外,如果一行中没有其他可接受的断点, 也会放宽由 word-break: auto-phrase 引入的限制:
- 如果抑制某个特定短语内部的软换行机会 会导致该短语即使放在一条空行上也发生溢出, 则用户代理必须回退到该短语内部 与 normal 相同的软换行机会。
- 如果这还不足以防止溢出, 则在每条会溢出的行中, 还必须放弃对连字符断字机会的抑制。
- 作为中间措施, 用户代理也可以检测多个层级的短语, 当较长短语会导致溢出时, 选择较短的短语 (可能短到单个词)。
通过放宽 word-break: keep-all 和 word-break: auto-phrase 所引入限制而获得的软 换行机会 在计算 min-content 固有尺寸时不被考虑。
- anywhere
-
如果一行中没有其他可接受的断点,
一个否则不可断开的字符序列
可以在任意点断开。
塑形字符仍会像词未被断开一样塑形,
且字素簇必须作为一个单位保持在一起。
不会在断点处插入连字符断字字符。
由 anywhere
引入的软换行
机会
在计算 min-content 固有尺寸时会被考虑。
在 word-break: auto-phrase 的情况下, 只有当按照 overflow-wrap: normal 中所述放宽由 word-break: auto-phrase 引入的限制仍不足以防止溢出时, 才会引入这些额外的软换行机会。
- break-word
- 与 anywhere 相同, 但由 break-word 引入的软换行 机会 在计算 min-content 固有尺寸时不被考虑。
我们是否需要向
overflow-wrap
添加一个 none 值,
以退出按 overflow-wrap: normal
所允许的对 keep-all 和 auto-phrase
限制的放宽?
出于历史兼容原因,UA 必须将 word-wrap 视为 overflow-wrap 属性的旧名称别名。
6.5. 断行细节
在确定断行时:
- 断行和双向文本的相互作用定义于 CSS 书写模式 4 § 2.4 应用双向重排算法 和 Unicode 双向算法 (特别是 UAX9§3.4 重排解析级别)。 [CSS-WRITING-MODES-4] [UAX9]
-
保留的分段符,
以及——无论 white-space 值如何——
任何具有
BK和NL断行类别的 Unicode 字符, 都必须被视为强制换行。 [UAX14]注:此类强制 换行的双向性影响 由 Unicode 双向 算法定义。 [UAX9]
-
除非另有明确定义
(例如对于 line-break: anywhere 或 overflow-wrap: anywhere),
必须遵守为
CM、 和SG、WJ、ZW、GL、 以及ZWJUnicode 断行类别定义的断行行为。 [UAX14] -
CSS 永远不允许在排版字符单位内部存在软换行机会。
因此,必须始终遵守
CM和SGUnicode 断行类别。 [UAX14] - 对于允许在标点 (而非使用它们的书写系统中的词 分隔符) 处换行的 UA, 应对断点设置优先级。 (例如,如果斜线之后的断点优先级低于空格, 则序列 “check /etc” 永远不会在 "/" 和 "e" 之间断开。) 只要注意避免这种尴尬的断开, 推荐允许在词 分隔符以外的适当标点处断开, 因为这会产生更均匀的页边效果,尤其是在窄行宽中。 UA 可以使用包含块的宽度、文本语言、 line-break 值 以及其他因素来分配优先级: CSS 不定义软换行机会的优先级。 然而,如果指定了 word-break: break-all, 则不期望对词分隔符进行优先级排序 (因为该值显式请求 不基于在词分隔符处断开的断行行为)—— 并且在 line-break: anywhere 下禁止这样做。
- 脱离流盒 和内联盒边界 不会在流中引入强制换行 或软换行 机会。
- 为了 Web 兼容性, 每个被替换元素或其他原子 内联之前和之后 都存在一个软换行机会, 即使它们与通常会抑制这些机会的字符相邻, 包括 U+00A0 NO-BREAK SPACE。 然而, 除 U+00A0 NO-BREAK SPACE 外, 原子内联与相邻的 属于 Unicode GL、WJ 或 ZWJ 断行类别的字符之间, 不得存在软换行机会。 [UAX14]
- 对于由在换行处消失的字符 (例如 U+0020 SPACE) 创建的软换行机会, 直接包含该字符的盒上的属性 控制该机会处的断行。 对于由两个字符或原子 内联之间的边界 定义的软换行机会, 这两个字符的最近共同祖先上的 white-space 属性 控制断行; 在此类边界处, 哪些元素的 line-break、word-break 和 overflow-wrap 属性 控制软换行机会的确定, 在本级中未定义。
- 对于盒的第一个字符之前 或最后一个字符之后的软换行机会, 断行发生在该盒之前/之后立即的位置 (在其 margin 边缘处), 而不是在该盒的内容边缘与内容之间断开该盒。
- Ruby 中及其周围的断行定义于 CSS Ruby 注音布局 1 § 3.4 跨行断开。 [CSS-RUBY-1]
- 当阿拉伯文等塑形文字 在词内非强制软换行机会处换行 (例如因 word-break: break-all、 line-break: anywhere、 overflow-wrap: break-word、 overflow-wrap: anywhere, 或连字符断字而断开时), 字符仍必须像词仍然完整一样进行塑形 (选择其连接形式)。
7. 对齐和两端对齐
对齐和两端对齐控制 内联内容如何分布在行盒内。
7.1. 文本对齐:text-align 简写
| 名称: | text-align |
|---|---|
| 值: | start | end | left | right | center | <string> | justify | match-parent | justify-all |
| 初始值: | start |
| 适用于: | 块容器 |
| 继承: | 是 |
| 百分比: | 见各单项属性 |
| 计算值: | 见各单项属性 |
| 动画类型: | 离散 |
| 规范顺序: | 不适用 |
此简写属性 设置 text-align-all 和 text-align-last 属性, 并描述当内容没有完全填满行盒时, 块的内联级内容如何沿内联轴对齐。 除 justify-all 或 match-parent 之外的值 会被赋给 text-align-all, 并将 text-align-last 重置为 auto。
这些值具有以下含义:
- start
- 内联级内容与行盒的起始边对齐。
- end
- 内联级内容与行盒的结束边对齐。
- left
- 内联级内容与行盒的line-left 边对齐。 (在竖排书写模式中, 这可以是物理顶部或底部, 取决于 writing-mode。) [CSS-WRITING-MODES-4]
- right
- 内联级内容与行盒的line-right 边对齐。 (在竖排书写模式中, 这可以是物理顶部或底部, 取决于 writing-mode。) [CSS-WRITING-MODES-4]
- center
- 内联级内容在行盒内居中。
- <string>
- 字符串必须是单个字符; 否则声明无效,且必须被 忽略。 当应用于表格单元格时,指定对齐 字符, 单元格内容将围绕该字符对齐。 关于更多细节以及此值如何与关键字组合, 参见下文。
- justify
- 文本根据 text-justify 属性指定的方法 进行两端对齐, 以精确填满行盒。 除非由 text-align-last 另行指定, 强制换行之前的最后一行 会按 start 对齐。
- justify-all
- 将 text-align-all 和 text-align-last 都设置为 justify, 从而强制最后一行也进行两端对齐。
- match-parent
-
此值的行为与 inherit 相同
(计算为其父元素的计算值),
但继承值
start 或 end
会相对于父元素的
direction 值解释,
并产生
left 或 right
的计算值。
当在根元素上指定时,
计算为 start。
当在 text-align 简写上指定时, 会将 text-align-all 和 text-align-last 都设置为 match-parent。
一段文本块 是一叠行盒。 此属性指定每个行盒内的内联级盒 如何相对于该行盒的起始侧和结束侧对齐。 对齐不是相对于 视口 或包含块。
在 justify 的情况下, UA 可以通过调整其文本 来拉伸或压缩任何内联盒。 (参见 text-justify。) 如果某个元素的空白 不是可折叠的, 则 UA 不需要为了两端对齐而调整其文本, 并且可以改为将该文本视为 没有两端对齐机会。 如果 UA 选择调整文本, 则它必须确保制表位 继续按照空白处理规则要求的方式对齐。
如果(在两端对齐之后,如有) 行盒的内联内容太长而无法放入其中, 则内容会按起始对齐: 任何放不下的内容 会溢出行盒的结束边。
关于如何确定行盒的起始边和结束边的细节, 参见 § 9.3 双向性和行盒。
7.2. 表格列中的基于字符的对齐
当一列中的多个单元格指定了对齐字符时, 每个此类单元格中的对齐字符 会沿一条与列平行的轴居中, 并相应移动该列中的其余文本。 (注意,每个单元格中的字符串不必相同, 尽管通常是相同的。)
这里是否意在说明 应该对齐的是对齐字符的中心? 目前并不清楚这是否就是其表述, 但需要指定这一点(或一种不同的行为), 以描述当对齐字符的不同出现位置 使用不同字体时会发生什么。 (此外,这是否是预期行为?也许最重要的用例 是粗体与非粗体文本, 它们的宽度只略有不同。) [反馈] [2016-02-02 上午 10:00 面对面会议纪要]
以下样式表:
TD { text-align: "." center }
会使以下 HTML 表格中的美元数值列:
<TABLE>
<COL width="40">
<TR> <TH>Long distance calls
<TR> <TD> $1.30
<TR> <TD> $2.50
<TR> <TD> $10.80
<TR> <TD> $111.01
<TR> <TD> $85.
<TR> <TD> N/A
<TR> <TD> $.05
<TR> <TD> $.06
</TABLE>
沿小数点对齐。该表格可能渲染为如下:
+---------------------+
| Long distance calls |
+---------------------+
|         $1.30       |
|         $2.50       |
|        $10.80       |
|       $111.01       |
|        $85.         |
|        N/A          |
|          $.05       |
|          $.06       |
+---------------------+
关键字值可以与 <string> 值一起指定; 如果没有给出,则默认为 right。 此值用于:
- 当基于字符的对齐应用于 非表格单元格的盒时。
- 当文本在多行中换行时(在非强制断点处)。
- 当字符对齐的单元格跨越多列时。 在这种情况下,关键字对齐值用于 确定与哪一列的轴对齐: 对于 left 是最左列, 对于 right 和 center 是最右列, 对于 start 是最起始列, 对于 end 是最结束列。
- 当列足够宽, 使得仅凭字符对齐 无法确定其字符对齐内容的位置时。 在这种情况下, 该列中第一个具有指定对齐字符的单元格的关键字对齐 会用于滑动字符对齐内容的位置, 尽可能匹配关键字对齐, 同时不改变列宽。 对于 center, UA 可以使用其两端对对齐内容进行居中, 尽可能使对齐轴本身居中, 或以其他方式对对齐内容进行视觉居中 (例如通过对轴两侧单元格内容的范围 取加权平均)。
注:基于字符的对齐默认使用右对齐, 因为数字系统几乎都是从左到右的, 即使在从右到左的书写系统中也是如此, 而基于字符的对齐的主要用例 是数值对齐。
如果对齐字符在文本中出现多次, 则使用第一次出现进行对齐。 如果对齐字符在单元格中完全没有出现, 则字符串会像对齐字符已被插入到其内容末尾一样对齐。
这需要指定 搜索对齐字符的文本是什么。 是否仅搜索其包含块为该单元格的流内文本? 或者是否考虑由该单元格建立的块格式化上下文中 任何流内后代中的文本? 如果是,是否仅在其 text-align 属性 与该单元格一致时才考虑? (是在对齐字符上一致,还是完全一致?)
这种像对齐字符 已被插入到单元格内容末尾那样对齐的行为, 与字符中心对齐结合起来, 会在单独位于一行且使用 <string> 文本对齐的行的结束侧产生间隙, 当该列中没有任何行具有对齐字符时, 或者更重要的是,当某些行 确实具有对齐字符, 但该列不是按其 max-content 宽度布局时。 这可能是不理想的。
当对齐字符 被插入到内容末尾时, 使用哪种字体? (特别是,如果对齐字符可能位于某个后代块中, 它使用该块的字体还是表格单元格的字体? 或者如果插入位置位于内联中的强制断点处, 它使用该内联的字体,还是块或单元格的字体?)
基于字符的对齐发生在表格单元格宽度计算之前, 因此自动宽度计算可以为对齐留出足够空间。 跨列单元格是在宽度计算之前还是之后参与对齐, 未作定义。 如果单元格内容的宽度约束阻止 整列完全对齐, 则所得对齐未定义。
这里应当有一个正式定义, 说明字符对齐如何影响 min-content 和 max-content 固有宽度 (包括表格列以及所有可以位于表格列内的内容)。 max-content 固有宽度需要拆分为三个数值 (假设对齐的是对齐字符的中心): 一个用于没有对齐字符的宽度, 一个用于对齐字符中心的内联起始侧宽度, 一个用于对齐字符中心的内联结束侧宽度。 这基于强制断点之间的所有文本片段 来作用于 max-content 宽度。 对于 min-content 宽度, 强制断点之间且内部包含可选断点的文本片段 显然应只贡献给无对齐字符宽度。 然而,不太清楚 是否所有 min-content 宽度都应这样工作, 或者强制断点之间不包含可选断点的片段 (也许只有实际包含对齐字符的那些片段) 是否应改为贡献给对齐字符起始侧 和结束侧的 min-content 宽度; 此选择是在表格 min-content 尺寸表示最窄合理尺寸的含义 与在更多情况下尊重对齐字符之间进行权衡。 另一个选项可能是使用是否允许在可选断点处断行 作为选择使用哪种行为的控制。
正式定义 具有 <string> 值的跨列单元格的 text-align 固有宽度贡献, 是对非跨列单元格固有宽度贡献所作决定的 一个复杂(虽然直接)的扩展; 这也应当被正式定义。 贡献最终会被分配给用于对齐的最起始列或最结束列 (取决于使用哪一列), 以及其他跨越列的无对齐字符固有宽度。
7.3. 默认文本对齐:text-align-all 属性
| 名称: | text-align-all |
|---|---|
| 值: | start | end | left | right | center | <string> | justify | match-parent |
| 初始值: | start |
| 适用于: | 块容器 |
| 继承: | 是 |
| 百分比: | 不适用 |
| 计算值: | 按指定的关键字,但 match-parent 按上文定义计算 |
| 规范顺序: | 不适用 |
| 动画类型: | 离散 |
text-align 简写属性的此单项属性 指定块容器中所有内联内容行的内联对齐, 但被 text-align-last 的非 auto 值覆盖的最后一行除外。 关于值的完整描述,参见 text-align。
作者应使用 text-align 简写,而不是此属性。
7.4. 最后一行对齐:text-align-last 属性
| 名称: | text-align-last |
|---|---|
| 值: | auto | start | end | left | right | center | justify | match-parent |
| 初始值: | auto |
| 适用于: | 块容器 |
| 继承: | 是 |
| 百分比: | 不适用 |
| 计算值: | 按指定的关键字,但 match-parent 按上文定义计算 |
| 规范顺序: | 不适用 |
| 动画类型: | 离散 |
此属性描述块的最后一行或 强制 换行正前方的一行 如何对齐。
如果指定了 auto, 受影响行上的内容按 text-align-all 对齐, 除非 text-align-all 被设置为 justify, 在这种情况下它按 start 对齐。 所有其他值都按 text-align 中所述解释。
7.5. 两端对齐方法:text-justify 属性
| 名称: | text-justify |
|---|---|
| 值: | [ auto | none | inter-word | inter-character | ruby ] || no-compress |
| 初始值: | auto |
| 适用于: | 文本 |
| 继承: | 是 |
| 百分比: | 不适用 |
| 计算值: | 指定的关键字(旧值 distribute 除外) |
| 规范顺序: | 不适用 |
| 动画类型: | 离散 |
此属性选择当行的对齐设置为 justify 时使用的两端对齐方法 (参见 text-align)。 此属性适用于文本, 但会从块容器继承到包含其内联级内容的根内联盒。 它接受以下值:
- auto
-
UA 根据性能与充分呈现质量之间的平衡,
确定要遵循的两端对齐算法。
由于两端对齐规则会因书写系统
和语言而异,
UA 应在可能时
使用适合该文本的两端对齐算法。
例如, UA 可以默认使用一种 对所有书写系统的简单通用折中两端对齐方法——例如主要扩展词分隔符 以及 CJK 排版字母单位之间的间距, 并次要地扩展 东南亚排版字母单位之间的间距。 然后,在段落的内容语言已知的情况下, 它可以选择更针对语言定制的两端对齐行为, 例如对日语遵循 日文文本 布局需求 [JLREQ], 对阿拉伯语使用草写延伸, 对德语使用 inter-word, 等等。
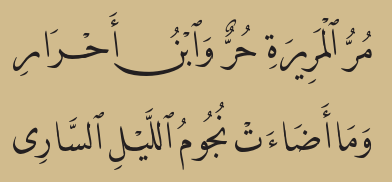
一个由 Tasmeem 渲染的 草写两端对齐阿拉伯文示例。 与英语类似, 阿拉伯文可以通过调整词间距进行两端对齐, 但在大多数样式中, 它也可以通过书法式地延长 或压缩字母形本身来进行两端对齐。 在此示例中, 上方文本通过使用延长(kashida)形式和花饰形式 被扩展以填满该行, 而下方行则通过对 ت 和 م 之间的字符 使用堆叠组合而稍微压缩。 通过采用传统书法技术, 排版者可以在保持流动感和色彩的同时对行进行两端对齐, 提供非常高质量的两端对齐效果。 然而,这本质上是一种非常特定于文字的效果。 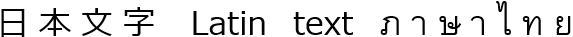
使用 text-justify: auto 的混合文字文本: 此解释使用通用折中两端对齐方法, 在空格处以及 CJK 和东南亚字母之间进行扩展。 对于具有词分隔符和/或 CJK 字符的行, 这实际上使用 inter-word + inter-ideograph 间距, 而对于没有这些内容的行, 或空格拉伸过远的行, 则回退到 inter-cluster 行为。 - none
-
禁用两端对齐:
文本中不存在两端对齐机会。
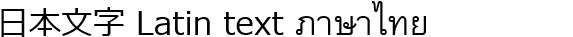
使用 text-justify: none 的混合文字文本 注:此值旨在用于用户 样式表, 以提高可读性或满足无障碍目的。
- inter-word
-
两端对齐仅调整词分隔符处的间距
(实际上是改变该行上使用的 word-spacing)。
这种行为通常用于使用空格分隔词的语言,
例如英语或韩语。

使用 text-justify: inter-word 的混合文字文本 - inter-character
-
两端对齐会调整
每一对相邻排版字符单位
之间的间距
(实际上是改变该行上使用的 letter-spacing)。
此值有时用于日语等东亚系统。
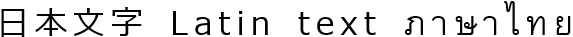
使用 text-justify: inter-character 的混合文字文本 出于历史兼容原因, UA 还必须支持替代关键字 distribute, 它必须计算为 inter-character, 因而具有完全相同的含义和行为。 UA 可以将其视为旧式值别名。
- ruby
-
两端对齐按 auto 调整间距,但:
注:此值旨在用于ruby 注音, 提供合理的默认对齐。 参见 [CSS-RUBY-1]。
- no-compress
-
两端对齐不得压缩由
text-spacing-trim 或 text-autospace
控制的间距。
(如果未指定此值,
两端对齐过程可以减少此类间距,
除非该间距位于行的开头或结尾。)
注:日语压缩规则的一个示例 见 [JLREQ] 中的 3.8 Line Adjustment。
此关键字以前 是 text-spacing 的一部分; 现在它在这里,可能需要重命名得更具体, 因为它暗示例如 U+0020 不能被压缩。[Issue #7079]
由于最佳两端对齐对语言敏感, 作者应正确为其内容标注语言,以获得最佳结果。
注:本级 CSS 中的指南 并未描述完整的两端对齐算法。 它们只是完整算法应满足的 最低要求集合。 限制要求集合让 UA 在选择 满足其需求以及质量、速度和复杂度之间期望平衡的 两端对齐算法时具有一定余地。
7.5.1. 扩展和压缩文本
在对文本进行两端对齐时, 用户代理会取得一行内容末端与其行盒边缘之间的 剩余空间, 并将该空间分配到其内容中, 使内容精确填满行盒。 用户代理也可以分配负空间, 使一行容纳比正常间距条件下 原本能容纳的更多内容。
两端对齐机会是 两端对齐算法可以改变文本内间距的位置。 两端对齐机会可以由单个排版字符 单位 提供 (例如词分隔符), 也可以由两个排版字符 单位的并置提供。 与对软换行机会的控制一样, 一个排版字符单位是否提供两端对齐机会 由其父元素的 text-justify 值控制; 类似地, 两个连续排版字符单位之间 是否存在两端对齐机会 由它们最近共同祖先的 text-justify 值决定。
由两端对齐分配的空间是 letter-spacing 或 word-spacing 属性所定义间距的额外部分。 当此类额外空间被分配给词分隔符两端对齐机会时, 它按与 word-spacing 相同的规则应用。 类似地,当空间被分配给两个排版字符单位之间的 两端对齐机会时, 应按与 letter-spacing 相同的规则应用。
两端对齐算法可以将两端对齐机会 划分为不同优先级。 给定级别内的所有两端对齐机会 都以相同优先级被扩展或压缩, 无论该机会由哪些排版字符单位创建。 例如, 如果两个汉字之间的两端对齐机会 和两个拉丁字母之间的两端对齐机会 被定义为同一级别 (如在 inter-character 两端对齐样式中), 它们不会因为来源于不同的排版字符 单位而被区别对待。 在本级中未定义 其他因素 (例如字体大小、letter-spacing、字形形状、行内位置等) 是否或如何影响空间在行内两端对齐 机会上的分配。
UA 可以启用或断开可选连字, 或使用其他字体特性 例如替代字形或字形压缩, 以帮助在任何方法下对文本进行两端对齐。 此行为不受本级 CSS 控制。 然而, UA 不得断开必需连字, 或以其他方式禁用正确塑形复杂文字所必需的特性。
如果一行内存在两端对齐机会, 并且文本对齐为该行指定完全两端对齐 (justify), 则该行必须进行两端对齐。
7.5.2. 处理符号和标点
在确定两端对齐机会时, 来自 Unicode 符号(S*)和标点符号(P*)类别的 排版字符单元 通常与同一书写系统的排版字母单元同等处理 (或者,如果该字符的扩展 书写系统属性为 Common, 则将其视为主导书写系统的排版字母单元)。
然而,按排版传统, 可能存在控制符号和标点两端对齐的额外规则。 因此,UA 可以重新分配特定字符, 或引入额外的优先级层级, 以处理涉及符号和标点的两端对齐机会。
7.5.3. 不可扩展文本
如果一行的内联内容无法被拉伸到行盒的完整宽度, 则它们必须按照 text-align-last 属性指定的方式对齐。 (如果 text-align-last 是 justify, 则它们必须按 center 对齐。)
7.5.4. 草写文字
两端对齐不得在阿拉伯文等草写文字 的已连接排版字母单位之间 引入间隙。 如果能够做到, UA 可以将在这种排版字母单位序列内 分配给两端对齐机会的空间 转换为该序列的某种草写延伸形式。 否则,它必须假定在草写文字中 任何一对排版字母单位之间 都不存在两端对齐机会 (无论它们是否连接)。
有些字体设计允许使用 tatweel 字符进行两端对齐。 执行基于 tatweel 的两端对齐的 UA 必须正确处理其使用规则。 注意,正确插入 tatweel 字符取决于上下文, 包括涉及的字母组合、 词内位置, 以及词在行内的位置。
7.5.5. auto 两端对齐的最低要求
对于 auto 两端对齐, 本规范不定义 所有两端对齐机会是什么, 它们如何排序优先级, 或多个层级的两端对齐 机会何时以及如何交互。 然而,它确实要求:
- 除非与内容 语言 的排版传统 或相邻符号/标点相抵触, 以下每一项都提供一个两端对齐机会:
- 属于所有块状文字的所有字母 都被同等对待, 属于所有成簇文字的所有字母 都被同等对待。 例如,不会区分 一个汉字后跟另一个汉字之间的两端对齐机会, 与一个汉字后跟一个谚文字母之间的两端对齐机会。
关于文本两端对齐的更多信息,可见于(或提交到) “完全两端对齐的方法”, 该索引按书写系统和语言编排, 并由 W3C 国际化工作组维护。 [JUSTIFY]
7.6. 在容器内对齐一段文本块:text-group-align 属性
| 名称: | text-group-align |
|---|---|
| 值: | none | start | end | left | right | center |
| 初始值: | none |
| 适用于: | 块容器 |
| 继承: | 否 |
| 百分比: | 不适用 |
| 计算值: | 指定的关键字 |
| 规范顺序: | 按语法 |
| 动画类型: | 离散 |
此属性在保持文本对齐的同时, 将行盒的内容作为一组进行对齐。
组对齐 通过找到剩余空间最短的行盒, 并将该数量的空间作为 padding 添加到行盒的一侧或两侧来执行, 从而减少可用于其内容的空间; 然后对剩余空间内的内容应用文本对齐。 在同一块格式化上下文内, 所有后代流内行盒 在搜索最短剩余空间 以及添加 padding 时都会被考虑; 会跳过建立独立格式化上下文的后代内容。
此属性的一个变体 是可继承的, 并分别应用于每个块容器, 只影响作为该块直接子级的行盒。 这用处较小,但可能更容易实现。
如果还能以相同量 移动源自同一块容器的浮动, 会以某种方式让内容对齐得更漂亮, 这在 CJK 布局中尤其有价值。 具体如何工作,以及它如何与来自祖先元素的侵入浮动交互, 留给读者自行思考。
这些值具有以下含义:
- none
- 文本对齐正常发生:不执行组对齐。
- start
- 通过在每个行盒的内联结束侧添加 padding, 将内联级内容组对齐到内联 起始侧。
- end
- 通过在每个行盒的内联起始侧添加 padding, 将内联级内容组对齐到内联结束 侧。
- left
- 通过在每个行盒的line-right 侧添加 padding, 将内联级内容组对齐到line-left 侧。
- right
- 通过在每个行盒的line-left 侧添加 padding, 将内联级内容组对齐到line-right 侧。
- center
- 通过在每个行盒的两侧添加 padding, 每侧添加一半间距, 将内联级内容组对齐到中心。
8. 间距
CSS 通过 word-spacing、letter-spacing 和 line-padding 属性 提供对常规文本间距的控制, 它们分别指定 词分隔符周围、 排版字符单位之间、 或行的开头/结尾处的额外空间。 它还通过 text-spacing-trim 属性 提供对间距的上下文控制, 该属性允许对 CJK 标点进行上下文相关的全角与半角设置; 以及通过 text-autospace 属性, 该属性允许在文字切换处或标点周围自动插入额外空间。
8.1. 词间距:word-spacing 属性
| 名称: | word-spacing |
|---|---|
| 值: | normal | <length-percentage> |
| 初始值: | normal |
| 适用于: | 文本 |
| 继承: | 是 |
| 百分比: | 相对于使用的 font-size |
| 计算值: | 绝对长度和/或百分比 |
| 规范顺序: | 不适用 |
| 动画类型: | 按计算值类型 |
此属性指定“词”之间的额外间距。 值按下文定义解释:
- normal
- 不应用额外间距。 计算为零。
- <length-percentage>
-
指定额外间距,
位于字体定义的固有词间距之外。
注:百分比会原样继承, 并相对于当前元素使用的 font-size 解析 (因此表示相对于其所应用文本大小的尺寸), 不同于 em 单位,后者相对于其继承来源元素的 计算 font-size 解析为绝对长度。
额外间距应用于 空白处理规则应用后 文本中留下的每个词分隔符, 并且除非排版传统另有规定, 应在该字符两侧各应用一半。 值可以为负,但可能存在依赖实现的限制。
词分隔符字符 是其主要目的和一般用途是分隔词的 排版字符单位。 在 Unicode 中,这包括 (但并非穷尽定义为) 空格(U+0020)、 不换行空格(U+00A0)、 埃塞俄比亚词间空格(U+1361)、 爱琴海词分隔符(U+10100,U+10101)、 乌加里特词分隔符(U+1039F), 以及腓尼基词分隔符(U+1091F)。 [UNICODE]
注:一般标点, 以及固定宽度空格(例如 U+3000 和 U+2000 到 U+200A), 都不被视为词分隔符 字符, 因为即使它们经常碰巧分隔词, 其主要目的也不是分隔词。
如果不存在词分隔符 字符, 或者某个分词字符具有零前进宽度 (例如 U+200B ZERO WIDTH SPACE), 则用户代理不得在词之间创建额外间距。
8.2. 字距调整:letter-spacing 属性
| 名称: | letter-spacing |
|---|---|
| 值: | normal | <length-percentage> |
| 初始值: | normal |
| 适用于: | 内联盒和文本 |
| 继承: | 是 |
| 百分比: | 相对于使用的 font-size |
| 计算值: | 绝对长度和/或百分比 |
| 规范顺序: | 不适用 |
| 动画类型: | 按计算值类型 |
此属性指定相邻排版字符单位之间的额外间距 (通常称为 tracking)。 Letter-spacing 在 双向重排之后应用, 并且是 字距微调 和 word-spacing 之外的额外间距。 [CSS-WRITING-MODES-4] [CSS-FONTS-3] 取决于生效的两端对齐规则, 用户代理还可以进一步增加或减少 排版字符单位之间的空间, 以便对文本进行两端对齐。
这些值具有以下含义:
- normal
- 不应用额外间距。计算为零。
- <length-percentage>
-
指定排版字符单位之间的额外间距。
值可以为负,
但可能存在依赖实现的限制。
注:百分比会原样继承, 并相对于当前元素使用的 font-size 解析 (因此表示相对于其所应用文本大小的尺寸), 不同于 em 单位,后者相对于其继承来源元素的 计算 font-size 解析为绝对长度。
出于历史兼容原因,
计算后的 letter-spacing 为零时,
其解析值
(getComputedStyle()
返回值)
为 normal。
字母间距通过在每个排版字符单元 两侧各插入一半的附加间距来应用; 但不会应用于行的开头或结尾。
p{ letter-spacing : 1 em ; }
< p > abc</ p >
a b c
a b c
将字母间距应用于行的右侧或尾侧边缘 是不正确的:
a b c
p{ letter-spacing : 1 em ; }
< p > aa< span > bb</ span > cc</ p >
aabbcc
当相邻内联之间的值不同时, 属于不同内联的相邻字母之间的有效间距 等于两者的平均值。
p{ letter-spacing : 1 em ; } span{ letter-spacing : 2 em ; }
< p > aa< span > bb</ span > cc</ p >
aabbcc
字母间距在 RTL 重排序之后插入。 这会影响哪个字母由于位于行的边缘 而使其一侧的间距被抑制。
p{ letter-spacing : 1 em ; } span{ letter-spacing : 2 em ; }
<!-- abc 后跟希伯来字母 alef (א)、bet (ב) 和 gimel (ג) --> <!-- 重排序会以相反顺序显示这些字母。 --> < p > ab< span > cא</ span > בג</ p >
abcאבג
就 letter-spacing 而言, 每个连续的原子内联序列 (例如图像和内联块) 都被视为单个排版字符单元。
字母间距会忽略不可见的零宽格式化字符 (例如 Unicode Cf 类别中的字符)。 添加间距时必须视这些字符在文档中不存在。
当两个字符之间的有效间距不为零时 (无论是由于两端对齐 还是由于 letter-spacing 的非零值), 用户代理不应应用可选连字, 即那些并非为了从根本上正确进行字形塑形 而被定义为必需的连字。 但是,通过低级 font-feature-settings 属性 指定的连字和其他字体特性 优先于此规则。 参见 CSS Fonts Module Level 3 § feature-precedence。
注: 在 OpenType 中,必需连字预期
与 rlig 特性相关联。
因此,所有其他连字都被视为可选连字。
但在某些情况下,UA 或平台启发式规则
会应用额外的连字以处理有缺陷的字体;
本规范不定义也不覆盖此类例外处理。
8.2.1. 草写文字
如果能够做到, UA 可以通过将要分配给此类字母序列的总额外空间 转换为该序列的某种草写延伸形式 (或对于负 tracking 值为压缩形式), 从而将 letter spacing 应用于草写文字, 使该序列产生等效的总扩展(或压缩)。 否则, 如果 UA 无法在不破坏其草写连接的情况下扩展 草写文字文本, 则它不得在该文字的任何一对排版字母单位之间 应用任何间距 (实际上将每个词视为一个单独的排版字母 单位 以用于 letter-spacing)。 两种情况都会导致此类字母之间的有效间距为零; 但前者会保留文本被拉伸展开的感觉。

| — | 原始文本 |
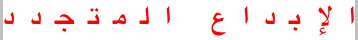
| 不佳 | 在每个字母之间均匀分配间距。 请注意,这会破坏草书连接! |
|---|---|---|

| 良好 | 通过排版上适当的草书延伸来分配 ∑letter-spacing。 所得文本的长度与前一个均匀间隔的示例相同。 |

| 良好 | 抑制阿拉伯字母之间的 letter-spacing。 请注意,letter-spacing 仍会应用于 非阿拉伯字符(例如空格)。 |
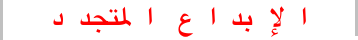
| 不佳 | 仅在未连接的字母之间应用 letter-spacing。 这会扭曲排版灰度,并使单词边界变得模糊。 |
注: 文本中恰当的草书延伸或压缩 可能会因 书写系统、 字体、 语言、 单词中的位置、 行中的位置、 实现复杂度、 字体能力 和书法偏好 而异, 并且在某些情况下可能根本无法实现。 这可能涉及使用缩短连字、 花体变体、 上下文形式、 U+0640 ـ ARABIC TATWEEL 等延伸字形, 或其他微排版技术。 为这些效果定义规则超出了 CSS 的范围。 除非作者准备接受不可互操作的结果,否则应避免将 letter-spacing 应用于草书 书写系统。
8.3. 行首/行尾内边距:line-padding 属性
| 名称: | line-padding |
|---|---|
| 值: | <length> |
| 初始值: | 0 |
| 适用于: | 内联盒 |
| 继承: | 是 |
| 百分比: | 不适用 |
| 计算值: | 绝对长度 |
| 规范顺序: | 按语法 |
| 动画类型: | 按计算值类型 |
与 letter-spacing 调整 排版字符单元之间的间距 且不应用于行的开头或结尾不同, 此属性仅调整行开头/结尾处的间距。 额外间距仅由行框开头/结尾处 最内层的内联框 应用, 并插入在该内联框的内容边缘 与相邻的内联级内容之间 (文本或原子 内联)。 此额外间距不是两端对齐机会。
p    { line-padding: 0.5em; line-height: 1; text-align: center }
span { background: black; color: white; }
em   { background: green; color: white; }

<p><span>Here is <em>some text</em></span>
Line-padding 将被插入, 使每行两侧各有额外的 0.5em 内联背景可见。 如果它渲染时在 “some” 和 “text” 之间发生断行, 则额外 padding 将是: 第一行左侧为黑色、右侧为绿色, 第二行两侧均为绿色。
Here is some
text
8.4. 自动上下文间距:text-autospace 属性
| 名称: | text-autospace |
|---|---|
| 值: | normal | <autospace> | auto |
| 初始值: | normal |
| 适用于: | 文本 |
| 继承: | 是 |
| 百分比: | 不适用 |
| 计算值: | 指定的关键字 |
| 规范顺序: | 按语法 |
| 动画类型: | 离散 |
使用一组基于字符类别的规则, 控制同一内联格式化上下文中 同一行上相邻字符之间的间距, 从而允许自动控制不同书写系统之间的间距 以及标点符号周围的间距。 此属性不会影响底层内容, 并且不得影响纯文本复制 & 粘贴操作的内容。
值定义如下:
<autospace> = no-autospace |
              [ ideograph-alpha || ideograph-numeric || punctuation ]
              || [ insert | replace ]
- normal
- 与 ideograph-alpha ideograph-numeric 的行为相同。
- no-autospace
- 不插入自动间距。
- ideograph-alpha
- 在 表意文字与非表意文字字母的连续段之间创建额外间距, 参见 § 8.4.1 书写系统间距。
- ideograph-numeric
- 在 表意文字与非表意文字数字的连续段之间创建额外间距, 参见 § 8.4.1 书写系统间距。
- punctuation
-
按照特定语言的排版惯例要求,在标点符号周围创建额外的不可断间距。
在本级别中,如果元素的内容语言为法语, 则会在法语 排版指南要求的位置插入窄不换行空格(U+202F)和不换行空格(U+00A0)。 否则此值不起作用。 不过,未来的规范可能会为其他语言添加自动间距行为。
- insert
-
如果该位置尚不存在任何类型的空格字符(Unicode 通用类别
Z), 则会自动插入指定的间距。 - replace
-
即使该位置已经存在空格
(U+0020),也会自动插入指定的间距;
此外,还会移除该空格(U+0020)。
其他类型的空格字符(Unicode 通用类别
Z) 会像 insert 一样 抑制自动间距。注: 此值用于纠正使用 易于输入的 U+0020 而不是正确间距的文本。
- auto
-
用户代理选择一组排版质量较高的间距值。
运行于不同平台的不同用户代理可能会选择不同的值。
注: 这些间距值可能与 操作系统平台惯例一致,也可能不一致。
此属性与 word-spacing 和 letter-spacing 属性的效果是相加的。 也就是说,由 letter-spacing 设置贡献的间距量(如果有) 会添加到由 text-autospace 创建的间距上。 word-spacing 同样如此。
在元素边界处,字符之间引入的额外间距量 由包含该边界的最内层元素决定,并在其中渲染。
8.4.1. 跨文字体系间距
ideograph-alpha 和 ideograph-numeric 值 会在特定字符类别之间的边界处引入间距, 前提是它们在同一行上直接相邻, 即它们之间没有任何非零的 外边距、边框或内边距 或介于其间的字符(例如引号或空格)。 这些关键字引入的间距量为 CJK 前进量的 1/8, 即如果 font-size 的使用值与其计算 值相同,则为 0.125ic。
注: 间距惯例各不相同,但其值通常 从 1/4ic 到低至 1/8ic, 由于金属活字的限制,在历史情境中 1/4ic 更为常见, 而在比例排版中 1/6ic 或更小的值更为常见。 由于默认会插入这些间距 (通过初始值 normal), CSS 使用 1/8ic,以便在干预时采取较为保守的方式。 本模块未来的级别可能会引入 对间距量的控制。
在 text-autospace 属性的上下文中,适用以下定义:
字符类别和 Unicode 码 位正在审查中, 并且至少需要进行一些更改,以适应 Unicode 中较新的新增内容。[议题 #9503]
- 表意文字
- 包括所有排版字符单元 [CSS-TEXT-3],其基字符 列于下方:
- 非表意文字 字母
-
包括所有属于
Unicode 字母 [L*] 和标记 [M*] 通用类别的排版字符单元,
但满足以下任一条件时除外:
- 被定义为表意文字。
- 被 [UAX11] 分类为东亚宽(W)或全角(F)。
- 使用 text-orientation 属性 或 text-combine-upright 属性时, 在垂直文本流中直立显示。
- 非表意文字 数字
-
包括所有属于
Unicode 十进制数字 [Nd] 通用类别的排版字符单元,
但满足以下任一条件时除外:
- 被 [UAX11] 分类为东亚全角(F)。
- 使用 text-orientation 属性 或 text-combine-upright 属性时, 在垂直文本流中直立显示。
8.4.2. 与双向文本的交互
由 text-autospace 引入的间距会在双向文本重排序之后插入。
<p>一些中国字SOME RTL TEXT中国字
<p>一些中国字SOME
     RTL TEXT中国字
<p>一些中国字SOME RTL♥中国字.
<p>一些中国字<bdi dir=rtl>SOME RTL♥</bdi>中国字
使用 ideographic-alpha 时,预期呈现效果类似于
一些中国字 TXET LTR EMOS 中国字
一些中国字 EMOS
TXET LTR 中国字
一些中国字 LTR EMOS♥中国字.
一些中国字♥LTR EMOS 中国字
8.5. CJK 标点间距:text-spacing-trim 属性
| 名称: | text-spacing-trim |
|---|---|
| 值: | <spacing-trim> | auto |
| 初始值: | normal |
| 适用于: | 文本 |
| 继承: | 是 |
| 百分比: | 不适用 |
| 计算值: | 指定的关键字 |
| 规范顺序: | 按语法 |
| 动画类型: | 离散 |
使用一组基于字符类别的规则, 控制同一内联格式化上下文中同一行上 CJK 标点字符周围的间距, 允许根据它们在行内的位置和相邻字符 将其设为半角或全角。
值定义如下:
<spacing-trim> = space-all | normal | space-first | trim-start | trim-both | trim-all
- space-all
- 所有全角标点字符都设置为全宽字形(留空)。
- normal
- 在每行开头,将全角开标点设置为全宽字形 (留空); 在每行末尾,如果全角闭标点在两端对齐之前 原本放不下, 则将其设置为半宽字形(贴齐), 否则将该标点设置为全宽字形; 并按下文所述 折叠标点字形之间的间距。
- trim-both
- 在每行开头,将全角开标点设置为半宽字形 (贴齐); 在每行末尾,将全角闭标点设置为半宽字形 (贴齐); 并按下文所述 折叠标点字形之间的间距。
- space-first
-
在块
容器第一行
以及每个强制换行之后的行上,
将全角开标点设置为全宽字形
(留空)。
否则与 normal 相同。
此值是为兼容性要求而存在的。
此值用于管理某些现有中文和日文内容的格式化, 对这些内容而言,trim-both 在排版上本应是合适的, 只是它们已经被编写为 期望第一行按 space-all 设置。
具体而言, 由于各 UA 对 hanging-punctuation 缺乏可靠支持, 现有内容(尤其是 ePub 内容) 使用 U+3000 表意空格代替 text-indent, 但当段落以希望悬挂在缩进中的标点开头时 会省略它, 以创建悬挂标点效果。 在第一行上使用 trim-both 因而会修剪掉此类内容中的有效缩进, 从而模糊该行作为新段落首行的区别。
注意,这种使用表意空格进行缩进 (有时使用、有时不使用) 的排版做法 与 HTML 和 CSS 所提供的内容与样式分离原则相悖。 使用 hanging-punctuation 和 text-indent 来控制段落格式, 而不是微调文档的文本内容, 能保留文档源中该文本的真实语义, 并允许样式表设计者 在各种间距/缩进样式之间自由切换, 而无需改变内容。 示例参见 § 8.5.3 CSS 中的日文段首惯例。
此外,行尾行为与 normal 和 trim-start 值保持一致, 而不是与 trim-both 保持一致: 它只在字形于两端对齐之前 原本放不下时才修剪字形。 虽然这在较少情况下改进排版, 但它更接近 space-all 的旧有行为, 从而减少兼容性顾虑。
- trim-start
- 在每行开头,将全角开标点设置为半宽字形 (贴齐)。 否则与 normal 相同。
- trim-all
- 将全角开标点、 全角闭标点 和全角中点标点 设置为半宽字形, 不考虑其在行内的位置, 也不考虑相邻字符。
- auto
-
用户代理选择一组排版质量较高的间距值。
在不同平台上运行的不同用户代理可能会选择不同的值。
注:这些间距值可能匹配也可能不匹配 操作系统平台惯例。
| 值 | 行首修剪 | 行尾修剪 | 相邻成对修剪 | 处处修剪 |
|---|---|---|---|---|
| space-all | 否 | |||
| normal | 否 | 仅当原本放不下时 | 是 | 否 |
| space-first | 是,但第一行除外 | |||
| trim-start | 是 | |||
| trim-both | 是 | |||
| trim-all | 是 | |||
| auto | 用户代理特定 / 依赖平台 | |||
8.5.1. 全角标点折叠
通常,全角字符的字形具有与标准汉字 (例如 水 U+6C34) 相同的前进宽度。 然而,许多全角标点字形只占用全宽设计空间的一部分。 因此,此类标点并不总是按全宽设置。 text-spacing-trim 的若干值允许作者控制 何时将此类字符设为半宽(通常为表意字符宽度的一半), 以及何时将其设为全宽。
为了按指定方式设置文本,UA 将需要:
- 如果字形给定为全宽但必须设为半宽, 则修剪(kern)该字形的空白半边;或者
- 如果字形给定为半宽但必须设为全宽, 则向该字形添加空间。
如果字体实现了 OpenType halt 和 vhal 特性,
UA 可以使用这些特性
对特定字形执行所需修剪。
UA 不得使用 hwid 特性
或以其他方式替换为半角形式,
因为切换到半角字形可能改变字形形状,
这在此处不可接受。
有些字体对全角标点字符使用比例字形。 如果字体不支持区分 全角与半角字形形状 (例如通过字体特性), 则对于此类比例字形, 给定前进宽度会被认为 同时是全宽和半宽: UA 不得向这些字形添加或移除空间。
注:标准汉字的前进宽度
可以根据字体度量来确定,
例如相反书写模式的 OpenType ideo 和 idtp 基线,
或者通过取诸如 水 U+6C34 这样的汉字的前进宽度来确定。
(必须使用相反书写模式,因为有些字体被压缩,
使字符并非正方形。)
关于 OpenType 度量的更多信息可见于
OpenType
规范。
注意,如果 水 U+6C34、卜 U+535C 和 一 U+4E00 并非都有相同的前进宽度,
则该字体具有比例表意字形,
且无法通过测量字形可靠确定全角前进宽度。
有些字体具有全角标点字符, 其空白部分太小而无法修剪(kern)。 当 UA 判断修剪(字距微调)可能通过字形边界框、 字形度量或字体特性 导致字形截断、碰撞或过度字距微调时, UA 可以选择不进行修剪(kern)。
如果 text-spacing-trim 为 trim-all, 则 UA 必须折叠通常与此类全宽字形相关联的空间, 而不考虑它们出现的上下文。 否则,除非 text-spacing-trim 被设置为 space-all (或字体具有比例全角标点字形), UA 必须在此类全宽字形在一行上相邻放置时 按如下方式折叠通常与它们相关联的空间:
| 组合 | 示例对 | 看起来像 |
|---|---|---|
| 开标点—开标点 | 〔+( | 〔( |
| 中点—开标点 | ・+( | ・( |
| 闭标点—开标点 | 〕+( | 〕( |
| 表意空格—开标点 | +( | ( |
| 闭标点—闭标点 | )+〕 | )〕 |
| 闭标点—中点 | )+・ | )・ |
| 闭标点—表意空格 | )+ | ) |
8.5.2. 文本间距修整字符类
在 text-spacing-trim 属性的上下文中,适用以下定义:
字符类别和 Unicode 码 位正在审查中, 并且至少需要进行一些更改,以适应 Unicode 中较新的新增内容。[议题 #9503]
- 全角 开标点
-
包括属于 CJK 符号和标点块(U+3000–U+303F)
或被 [UAX11]
分类为东亚全角(F)的任何开标点字符(Unicode 类别
Ps)。 还包括 LEFT SINGLE QUOTATION MARK(U+2018)和 LEFT DOUBLE QUOTATION MARK(U+201C)。 修整时,会对左半边(对于横排文本)或上半边(对于竖排文本)进行字距调整。 - 全角 闭标点
-
包括属于 CJK 符号和标点块(U+3000–U+303F)
或被 [UAX11]
分类为东亚全角(F)的任何闭标点字符(Unicode 类别
Pe)。 还包括 RIGHT SINGLE QUOTATION MARK(U+2019)和 RIGHT DOUBLE QUOTATION MARK(U+201D)。 还可以包括全角冒号类标点和/或全角句点类标点 (见下文)。 修整时,会对右半边(对于横排文本)或下半边(对于竖排文本)进行字距调整。 - 全角中点类标点
- 包括 MIDDLE DOT(U+00B7)、HYPHENATION POINT(U+2027)和 KATAKANA MIDDLE DOT(U+30FB)。 还可以包括全角冒号类标点和/或全角句点类标点 (见下文)。
- 全角 冒号类标点
- 包括 FULLWIDTH COLON(U+FF1A)和 FULLWIDTH SEMICOLON(U+FF1B)。
- 全角句点 类标点
- 包括 IDEOGRAPHIC COMMA(U+3001)、 IDEOGRAPHIC FULL STOP(U+3002)、 FULLWIDTH COMMA(U+FF0C)、 FULLWIDTH FULL STOP(U+FF0E)。
全角冒号标点和全角点号标点 应被视为全角闭标点还是全角中 点标点, 取决于标点在字形盒中的绘制位置。 如果标点居中, 则应被视为中点标点。 如果标点被绘制到一侧(横排文本中为左侧,竖排文本中为顶部) 而另一半因此为空白, 则该标点应被视为闭标点并相应修剪。
UA 必须按适当情况 将全角冒号标点和全角点号标点 归入全角闭标点类别 或全角中点标点类别。 UA 可以依赖语言惯例和书写模式(横排与竖排), 和/或字体信息来确定此分类。 UA 也可以按适当情况向任何类别添加额外字符。
| 冒号标点 | 点号标点 | |
|---|---|---|
| 简体中文(横排) | 闭标点 | 闭标点 |
| 简体中文(竖排) | 闭标点 | 闭标点 |
| 繁体中文 | 中点 | 中点 |
| 韩语 | 中点 | 闭标点 |
| 日语 | 中点 | 闭标点 |
注意,至少对于中文字体而言, 作者观察到通常并不遵循标准惯例。
8.5.3. CSS 中的日文段首惯例
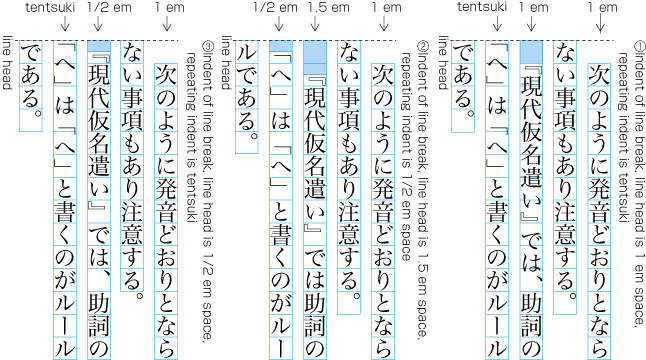
行首开括号的定位 [JLREQ]
假设 UA 样式表为 p { margin: 1em 0; },
CSS 可以通过以下规则实现日文排版样式:
-
括号与缩进贴齐,也与其他行贴齐(第一种方案):
p { /* Flush alignment */ margin: 0; text-indent: 1em; text-spacing-trim: trim-both; } -
括号在所有行上保留全角间距(第二种方案):
p { /* Fullwidth alignment */ margin: 0; text-indent: 1em; text-spacing-trim: space-all; } -
括号悬挂在缩进中,并与其他行贴齐(第三种方案):
p { /* Hanging alignment */
  margin: 0;
  text-indent: 1em;
  text-spacing-trim: trim-both;
  hanging-punctuation: first;
}
8.6. 字符类别间距简写:text-spacing 属性
| 名称: | text-spacing |
|---|---|
| 值: | none | auto | <spacing-trim> || <autospace> |
| 初始值: | 见各单项属性 |
| 适用于: | 文本 |
| 继承: | 是 |
| 百分比: | 不适用 |
| 计算值: | 指定的关键字 |
| 动画类型: | 离散 |
| 规范顺序: | 按语法 |
此属性是一个简写属性, 用于在单个声明中设置 text-spacing-trim 和 text-autospace。 各值定义如下:
- none
- 关闭所有文本间距特性: 将 text-spacing-trim 设置为 space-all, 并将 text-autospace 设置为 no-autospace。
- auto
- 将 text-spacing-trim 和 text-autospace 都设置为 auto。
- <spacing-trim>
- 将 text-spacing-trim 设置为指定值。 如果未给出 <autospace> 值, 则将 text-autospace 设置为其初始 值。
- <autospace>
- 将 text-autospace 设置为指定值。 如果未给出 <spacing-trim> 值, 则将 text-spacing-trim 设置为其初始 值。
注: 由于 normal 是 text-spacing-trim 和 text-autospace 两者的初始值, text-spacing: normal 会将两者重置为各自的初始值。
8.7. 跨元素边界的字形塑形
当分隔两个排版字符单元的任何框 满足以下任一条件时, 文本塑形必须在内联框边界处断开:
- 在内联轴上分隔两个排版字符单元的 margin/border/padding 中的任何一个 非零。
- vertical-align 不是其初始 值; 即其至少一个长写属性不是其初始 值。
- 该边界是一个双向文本隔离边界。
当不存在有效格式变化, 或者唯一的格式变化不会影响字形 (如应用文本装饰)时, 文本塑形不得跨内联盒边界断开。
在其他情况下, 如果考虑到字体技术限制,此情况合理且可行, 文本塑形不应跨内联盒边界断开。
跨边界塑形可能但不合理的一个示例 是处理某个字体,该字体需要依赖字符串两侧各 20 个字符的上下文 来选择其字形: 即使穿过多个带有格式变化的内联边界, 也传递相关字符串之前和之后的所有文本, 这很复杂。 UA 可以处理此类情况, 但不是必需的, 因为它们并非任何现代书写系统的典型需求或基本需求。
跨边界塑形不可能的一个示例 是在单词 “and” 中途改变字体粗细, 而该字体中一个连字会将该单词的 全部三个字母 “and” 替换为一个和号字形(“&”)。
9. 边缘效果
边缘效果控制 行相对于块中其他行的缩进(text-indent) 以及如何在一行的起始和结束边缘度量内容(hanging-punctuation)。
9.1. 首行缩进:text-indent 属性
| 名称: | text-indent |
|---|---|
| 值: | [ <length-percentage> ] && hanging? && each-line? |
| 初始值: | 0 |
| 适用于: | 块容器 |
| 继承: | 是 |
| 百分比: | 指块容器自身内联轴上的内部尺寸 |
| 计算值: | 计算后的 <length-percentage> 值,加上任何指定关键字 |
| 规范顺序: | 按语法 |
| 动画类型: | 按计算值类型 |
此属性指定应用于块中 内联内容行的缩进。 缩进被视为应用于行盒起始边的外边距。
除非由 each-line 和/或 hanging 关键字 另行指定, 只有作为元素 首个格式化行 的行会受到影响。 [CSS-PSEUDO-4] 例如,匿名块盒的第一行只有在它是其父元素的第一个子级时 才会受到影响。
这些值具有以下含义:
- <length>
- 以绝对长度给出缩进量。
- <percentage>
-
以块容器自身逻辑
宽度的百分比
给出缩进量。
在计算固有尺寸贡献时, 百分比必须被视为 0, 但在执行布局时始终正常解析。
注:这可能导致元素溢出。 不建议同时使用百分比缩进和固有尺寸。
- each-line
- 缩进会影响每个块容器的第一行 以及每个强制换行之后的行 (但不影响软 换行断点之后的行)。
- hanging
- 反转哪些行受到影响。
如果在没有浮动存在的从左到右文本中, text-align 为 start, 且 text-indent 为 5em, 则第一行文本会从块内 5em 处开始:
     Since CSS1 it has been possible to
indent the first line of a block element
5em by setting the 'text-indent' property
to '5em'.
如果我们添加 hanging 关键字, 则第一行会贴齐开始, 但其他行会缩进 5em:
In CSS3 we can instead indent all other
     lines of the block element by 5em
     by setting the 'text-indent' property
     to 'hanging 5em'.
   For example, in the middle of
this paragraph is an equation,
which is centered:
             x + y = z
The first line after the equation
is flush (else it would look like
we started a new paragraph).
然而,有时(如诗歌或代码中), 对每个碰巧长到需要换行的行进行缩进 是合适的。 在以下示例中,text-indent 被赋予 3em hanging each-line 值, 使诗歌第三行在块的右边界处软换行时 具有悬挂缩进:
In a short line of text
There need be no wrapping,
But when we go on and on and on
   and on,
Sometimes a soft break
Can help us stay on the page.
注:由于 text-indent 属性会继承, 当在块元素上指定时,它会影响后代 inline-block 元素。 因此,通常明智的做法是,在被指定为 display: inline-block 的元素上 指定 text-indent: 0。
9.2. 悬挂字形
当行起始边缘或结束边缘处的字形悬挂时, 在测量行内容以确定适合度、对齐或两端对齐时, 不会将其考虑在内。 根据行的对齐/两端对齐方式,这可能 导致该标记被放置到行框之外。 在计算内在尺寸(最小内容尺寸 和最大内容尺寸) 以及由此派生的任何尺寸时,也不会考虑悬挂字形。 (此测量与字距调整之间的交互目前由 UA 定义; CSSWG 欢迎就此提出建议。)
悬挂字形 仍包含在其父内联框中, 并且仍参与文本两端对齐: 只是在确定 一行中能容纳多少内容、 行内容需要扩展或压缩多少以实现两端对齐, 或如何在行框中定位内容以实现文本对齐时, 不测量其字符前进量。 实际上,悬挂字形的字符前进量 会被重新解释为其父内联框 受影响边缘上的额外负外边距; 除此之外,行仍按通常方式布局。
溢出的悬挂字形通常应被 视为墨迹溢出, 以避免创建不必要的滚动条, 但当内容可编辑 或在其他将其视为可滚动 溢出 对用户有用的情况下, UA 可以将其视为可滚动溢出。 [CSS-OVERFLOW-3]
在某些情况下,行末的字形 可以有条件地 悬挂: 仅当其在两端对齐之前无法正常容纳于行中时,它才会悬挂。 在测量行内容以确定适合度时,不会将其考虑在内; 但是,其中任何无法容纳的部分 都被视为悬挂。 在计算最小内容尺寸 及由此派生的任何尺寸时,不会考虑有条件悬挂的字形, 但在计算最大内容尺寸 及由此派生的任何尺寸时会考虑它们。
当行末可有条件悬挂的字形 紧接在(无条件)可悬挂字形之后时, 当且仅当所有后续可有条件悬挂的字形确实都悬挂时, 无条件可悬挂的字形才会悬挂; 否则,(无条件)可悬挂字形实际上并不位于行末, 因而不会悬挂。
可悬挂字形与行边缘之间 非零的内联轴边框或内边距 会阻止该字形悬挂。 例如,具有结束侧内边距的内联框末尾的句点 不会在行的结束边缘悬挂。
多个相邻字形可以一起悬挂, 但可以规定允许悬挂数量的具体限制 (例如,行的每个边缘最多只能有一个标点字符悬挂)。
9.2.1. 悬挂标点:hanging-punctuation 属性
| 名称: | hanging-punctuation |
|---|---|
| 值: | none | [ first || [ force-end | allow-end ] || last ] |
| 初始值: | none |
| 适用于: | 文本 |
| 继承: | 是 |
| 百分比: | 不适用 |
| 计算值: | 指定的关键字 |
| 规范顺序: | 按语法 |
| 动画类型: | 离散 |
此属性决定标点符号(如果存在) 是否会悬挂,并可被放置在文本行的开头或结尾处 的行框之外(或缩进区域中)。
注: 如果块容器上没有足够的内边距, hanging-punctuation 可能会触发溢出。
各值具有以下含义:
- none
- 不使任何标点字符悬挂。
- first
- 元素的首个格式化行开头的 开括号、引号或表意空格会悬挂。 这适用于 Unicode 类别 Ps、Pf、Pi 中的所有字符, 以及 ASCII 引号 U+0027 ' APOSTROPHE 和 U+0022 " QUOTATION MARK 以及 IDEOGRAPHIC SPACE U+3000。
- last
- 元素最后一个格式化行末尾的 闭括号或引号会悬挂。 这适用于 Unicode 类别 Pe、Pf、Pi 中的所有字符, 以及 ASCII 引号 U+0027 ' APOSTROPHE 和 U+0022 " QUOTATION MARK。
- force-end
- 行末的句点或逗号 会悬挂。
- allow-end
- 行末的句点或逗号 会有条件地悬挂。
行的每个边缘最多可以有一个标点字符悬挂。
允许悬挂的句点 和逗号包括:
| U+002C | , | 逗号 |
| U+002E | . | 句点 |
| U+060C | ، | 阿拉伯逗号 |
| U+06D4 | ۔ | 阿拉伯句点 |
| U+3001 | 、 | 表意逗号 |
| U+3002 | 。 | 表意句点 |
| U+FF0C | , | 全角逗号 |
| U+FF0E | . | 全角句点 |
| U+FE50 | ﹐ | 小逗号 |
| U+FE51 | ﹑ | 小表意逗号 |
| U+FE52 | ﹒ | 小句点 |
| U+FF61 | 。 | 半角表意句点 |
| U+FF64 | 、 | 半角表意逗号 |
UA 可以按适当情况包括其他字符。
注:CSS 工作组希望 包含其他字符的 UA 能够告知工作组 这些新增内容。
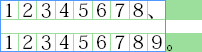
p{ text-align : justify; hanging-punctuation : allow-end; }
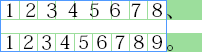
p{ text-align : justify; hanging-punctuation : force-end; }
对于 allow-end, 第一行末尾的标点不会悬挂, 因为它无需悬挂也能放下。 然而,如果使用 force-end, 则会强制它悬挂。 两端对齐会在不计入悬挂标点的情况下度量该行。 因此,当该行被扩展时,标点会被推出行外。
9.3. 双向性和行盒
行盒的起始 和结束 侧 由该行盒的内联基方向确定。 尽管它们通常相匹配, 行盒的内联基方向 不同于包含块或双向 段落的内联基方向。 行盒的内联基 方向会影响 text-align-all、text-align-last、text-indent 和 hanging-punctuation——即其内容相对于边缘的位置和对齐。 它不影响内联内容的格式化或排序 (后者由Unicode 双向 算法 控制,并由 CSS 书写模式 应用 [UAX9] [CSS-WRITING-MODES-4])。
在大多数情况下,行盒的内联基方向 由其包含块计算后的 direction 给出。 然而, 如果其包含块具有 unicode-bidi: plaintext [CSS-WRITING-MODES-4]:
- 如果双向段落(行盒所属的段落, 即该行盒承载其内容的双向段落) 具有强方向性, 则行盒的内联基方向就是该方向。
- 如果行盒为空 (即不包含原子内联或 换行字符以外的字符,如有) 或者没有强方向性 (只包含弱字符或中性字符), 则其内联基方向取自 前一个行盒(如有), 或者,如果这是包含块中的第一个行盒, 则取自包含块的 direction 属性。 (这可能产生内容具有 LTR 基方向的 RTL 行盒。)
<block>
是一个按起始对齐的预格式化块
(display: block; white-space: pre; text-align: start),
则每隔一行会右对齐:
< block style = "unicode-bidi: plaintext" > français فارسی français فارسی français فارسی</ block >
< para style = "display: block; direction: rtl; unicode-bidi:plaintext" > “< quote style = "unicode-bidi:plaintext" > שלום!</ quote > ”, they said.</ para >
< textarea style = "direction: rtl; unicode-bidi:plaintext" > Hello!</ textarea >
由于 unicode-bidi: plaintext, “Hello!” 会按 LTR 排版 (即感叹号在右侧) 并左对齐, 忽略包含块的 RTL direction。 这也使其后的空行成为 LTR, 这意味着该行上的插入符应出现在其左边缘。 然而,第一个空行是右对齐的: 因为没有前一行, 它假定其包含块的 RTL 方向。
附录 A: 文本处理操作顺序
本附录是规范性的。
以下列表定义文本操作的顺序。 (只要所得布局相同,实现并不受此顺序约束。)
- § 4.2 空白修剪:white-space-trim 属性
- 空白处理第 I 部分(换行前)
- § 2.2 在词之间扩展:word-space-transform 属性和 文本变换
- 文本组合 [CSS-WRITING-MODES-4]
- 文本朝向 [CSS-WRITING-MODES-4]
-
在逐行应用以下操作时进行文本换行:
-
空白处理第 II 部分
注:这些操作可能影响一行能容纳多少文本, 因而会回环到换行。
- 两端对齐 (这可能影响字形选择和/或文本换行,并回环到该步骤)
- 文本对齐
- 文本组对齐
附录 B: 转换为纯文本
出于纯文本复制粘贴操作的目的,本附录是规范性的。
当 CSS 渲染的文档被转换为纯文本格式时, 预期:
- text-transform 属性没有影响。
- 会应用 white-space-trim 和 § 4.3.1 阶段 I:折叠和变换, 并移除位于块开头 或紧跟强制换行之后的 任何可折叠空白序列。
附录 C: 默认 UA 样式表
本附录是信息性的, 旨在帮助 UA 开发者为 HTML 实现默认样式表, 但 UA 开发者可以按适当情况自由忽略或修改。
/* make option elements align together */ option{ text-align : match-parent; } /* do not allow white space to collapse in textarea */ textarea{ white-space-collapse : preserve !important; } /* preserve character grid in preformatted text */ pre, code, kbd, samp, tt, listing, xmp, plaintext{ text-spacing : none; } /* Avoid hanging punctuation inheriting into preformatted blocks */ pre{ hanging-punctuation : none; }
附录 D: 文字和间距
本附录是规范性的。
排版行为会因语言而有所差异, 但会因书写系统而有巨大差异。 本附录按照两端对齐和间距行为, 对 Unicode 6.0 中一些常见文字进行分类。 类别描述是描述性的,而非规定性的; 决定因素是两端对齐机会的优先级排序。
- 块状文字
-
CJK,以及扩展而言的所有 Wide 字符
(见东亚宽度 [UAX11])。
包括以下Unicode
文字:
Bopomofo、Han、Hangul、Hiragana、Katakana 和 Yi。
还包括East
Asian Width 属性
为
Wide和Fullwidth的字符, 但Ambiguous字符只有在书写系统是 Chinese、 Korean 或 Japanese时才包括。 - 成簇 文字
- 成簇文字具有离散单位, 并且只在词边界处断开, 但不使用可见的词分隔符。 它们优先拉伸空格, 但也能舒适地接受字符间距用于两端对齐。 成簇文字包括但不限于 以下Unicode 文字: Khmer、 Lao、 Myanmar、 New Tai Lue、 Tai Le、 Tai Tham、 Tai Viet、 Thai
- 草写文字
-
草书书写系统在两端对齐或 letter-spacing 时,
都不允许在字母之间产生间隙。
包括以下Unicode
书写系统:
阿拉伯文、
哈尼菲罗兴亚文、
曼达文、
蒙古文、
西非书面文字、
八思巴文、
叙利亚文
注: 具有基线连接符的印度文字 (例如天城文和古吉拉特文) 不被视为草书书写系统, 并且确实允许在排版字符单元之间 存在此类间隙。 参见 印度文字布局要求。 [ILREQ]
用户代理应随着其 Unicode 支持的更新而更新此列表, 以处理 Unicode 未来版本中尚未编码的草写文字, 并鼓励其请求 CSSWG 相应更新本规范。
附录 E: 字符和属性
本附录是规范性的。
Unicode 定义了四种码点级属性, 它们在 CSS 排版中被引用:
- 东亚 宽度属性
-
定义于 Unicode 标准附录 #11 [UAX11],并在
Unicode 字符数据库
[UAX44] 中以
East_Asian_Width属性给出。 - 通用类别
-
定义于 Unicode 标准附录
#44 [UAX44],并在
Unicode 字符数据库
[UAX44] 中以
General_Category属性给出。 - 扩展书写系统属性
-
定义于 Unicode 标准附录 #24 [UAX24],并在
Unicode 字符数据库
[UAX44] 中以
Script属性给出。 UA 还必须在此映射中包括 ScriptExtensions.txt 中的任何赋值。 - 垂直方向
- 定义于 Unicode 标准附录 #50 [UAX50],作为 Unicode 字符数据库 [UAX44] 中的 Vertical_Orientation 属性。
Unicode 为各个码位定义属性, 但有时需要确定 排版字符单元的属性。 就 CSS Text 而言, 排版字符单元的属性由 其首个字素簇的基字符给出——但有两种例外情况:
-
由 Common 书写系统的
包围标记
(
Me) 形成的字素簇 被视为 Common 书写系统中的其他符号 (So)。 假定它们具有与替换字符(U+FFFD) 相同的 Unicode 属性。 -
由空格分隔符
(
Zs) 作为基字符形成的字素簇 被视为修饰符号 (Sk)。 假定它们具有与基字符相同的东亚宽度属性, 但其其他属性 取自序列中的第一个组合字符。
附录 F: 识别内容书写系统
本附录是规范性的。
虽然大多数语言都有首选书写系统,
但有些语言有多个,
而且大多数语言也可以转写成一种或多种外来书写系统。
一个常见例子是,大多数语言至少有一种拉丁转写,
因而可以用拉丁书写系统书写。
转写文本通常采用该书写系统的排版惯例:
例如日语 “romaji” 和中文拼音使用拉丁字母和词间空格,
并相应遵循拉丁断行和两端对齐实践。
再例如,历史性的表意韩文
(ko-Hani)
不使用词间空格,
因此应以类似中文而不是现代韩文的方式排版。
在 HTML 或任何其他使用 BCP47 标签来识别语言以声明文档语言中的内容语言时,
作者可以使用文字子标签来消歧或指示使用非典型书写系统。
[BCP47]
例如,为了指示对并非原生使用拉丁书写系统的语言
使用拉丁书写系统,
可以添加 -Latn 文字子标签,
例如日语罗马字为 ja-Latn。
其他书写系统也有其他子标签,
参见 ISO 的 Code for the Representation of Names of Scripts 和
ISO15924 文字标签注册表。
[ISO15924]
zh-Latn- 中文,以拉丁转写书写。
ko-Hani- 韩语,以汉字(中文表意字符)书写。
tr-Arab- 土耳其语,以阿拉伯文字书写。
mn-Cyrl- 蒙古语,以西里尔文字书写。
mn-Mong- 蒙古语,以传统蒙古文字书写。
然而,BCP47 文字子标签通常不用于
(实际上也不鼓励用于)
与单一书写系统强相关的语言:
相反,在未指定其他书写系统时,
该书写系统预期会被隐含。
[BCP47]
为此,IANA 在其语言子标签
注册表中
通过 Suppress-Script 字段
维护各种语言最常见书写系统的数据库。
注:关于语言标记的更多建议可见于 国际化工作组的 “HTML 和 XML 中的语言标签” 和 “选择语言 标签”。
当未显式指示书写系统时, UA 应假定所声明内容 语言 的最常见书写系统, 用于断行或两端对齐等对语言敏感的排版行为。 然而,如果作者显式声明了不同的书写系统, UA 不得假定该书写系统。 如果 UA 对特定语言和书写系统组合 没有特定于语言的知识, 则它必须使用所声明书写系统的排版惯例 (必要时假定另一种语言的惯例), 而不是使用假定书写系统中所声明语言的惯例, 因为那会不适合所声明的书写系统。
语言与其最常见书写系统之间的完整对应关系 超出本文档范围。 然而,用户代理必须至少假定以下内容:
- 如果内容 语言是中文且书写系统未指定, 或对于任何内容语言, 如果书写系统被指定为 Hant、 Hans、 Hani、 Hanb 或 Bopo ISO 文字代码之一, 则该书写系统是 Chinese。
- 如果内容 语言是日语且书写系统未指定, 或对于任何内容语言, 如果书写系统被指定为 Jpan、 Hrkt、 Hira 或 Kana ISO 文字代码之一, 则该书写系统是 Japanese。
- 如果内容 语言是韩语且书写系统未指定, 或对于任何内容语言, 如果书写系统被指定为 Kore、 Hang 或 Jamo ISO 文字代码之一, 则该书写系统是 Korean。
- 只有在内容 语言本身未知, 或者它显式指示未知书写系统时, 书写 系统才被认为是unknown。
附录 G: 小假名映射
本附录是规范性的。
| 小 | 全尺寸 |
|---|---|
| ぁ U+3041 | あ U+3042 |
| ぃ U+3043 | い U+3044 |
| ぅ U+3045 | う U+3046 |
| ぇ U+3047 | え U+3048 |
| ぉ U+3049 | お U+304A |
| ゕ U+3095 | か U+304B |
| ゖ U+3096 | け U+3051 |
| 𛄲 U+1B132 | こ U+3053 |
| っ U+3063 | つ U+3064 |
| ゃ U+3083 | や U+3084 |
| ゅ U+3085 | ゆ U+3086 |
| ょ U+3087 | よ U+3088 |
| ゎ U+308E | わ U+308F |
| 𛅐 U+1B150 | ゐ U+3090 |
| 𛅑 U+1B151 | ゑ U+3091 |
| 𛅒 U+1B152 | を U+3092 |
| ァ U+30A1 | ア U+30A2 |
| ィ U+30A3 | イ U+30A4 |
| ゥ U+30A5 | ウ U+30A6 |
| ェ U+30A7 | エ U+30A8 |
| ォ U+30A9 | オ U+30AA |
| ヵ U+30F5 | カ U+30AB |
| ㇰ U+31F0 | ク U+30AF |
| ヶ U+30F6 | ケ U+30B1 |
| 𛅕 U+1B155 | コ U+30B3 |
| ㇱ U+31F1 | シ U+30B7 |
| ㇲ U+31F2 | ス U+30B9 |
| ッ U+30C3 | ツ U+30C4 |
| ㇳ U+31F3 | ト U+30C8 |
| ㇴ U+31F4 | ヌ U+30CC |
| ㇵ U+31F5 | ハ U+30CF |
| ㇶ U+31F6 | ヒ U+30D2 |
| ㇷ U+31F7 | フ U+30D5 |
| ㇸ U+31F8 | ヘ U+30D8 |
| ㇹ U+31F9 | ホ U+30DB |
| ㇺ U+31FA | ム U+30E0 |
| ャ U+30E3 | ヤ U+30E4 |
| ュ U+30E5 | ユ U+30E6 |
| ョ U+30E7 | ヨ U+30E8 |
| ㇻ U+31FB | ラ U+30E9 |
| ㇼ U+31FC | リ U+30EA |
| ㇽ U+31FD | ル U+30EB |
| ㇾ U+31FE | レ U+30EC |
| ㇿ U+31FF | ロ U+30ED |
| ヮ U+30EE | ワ U+30EF |
| 𛅤 U+1B164 | ヰ U+30F0 |
| 𛅥 U+1B165 | ヱ U+30F1 |
| 𛅦 U+1B166 | ヲ U+30F2 |
| 𛅧 U+1B167 | ン U+30F3 |
| ァ U+FF67 | ア U+FF71 |
| ィ U+FF68 | イ U+FF72 |
| ゥ U+FF69 | ウ U+FF73 |
| ェ U+FF6A | エ U+FF74 |
| ォ U+FF6B | オ U+FF75 |
| ッ U+FF6F | ツ U+FF82 |
| ャ U+FF6C | ヤ U+FF94 |
| ュ U+FF6D | ユ U+FF95 |
| ョ U+FF6E | ヨ U+FF96 |
附录 H: 词和短语检测
本附录是规范性的。
本规范中的少数操作 依赖自动化的 词边界检测 或 短语边界检测。
这两种操作类似: 用户代理对文本执行语言分析, 以识别特定于语言的有意义字符序列。 它们只是在目标文本单位上不同: 要么是词,要么是短语。
虽然在广义上容易理解, 但词和短语这两个概念都难以精确定义, 尤其难以用一种适用于多种语言的方式定义。 尽管如此,在此上下文中:
-
词是一个可识别的语义单位,可以由一个或多个字符或音节组成。
注:关于此概念的一些讨论,参见 什么是词? 。
-
短语是一个或若干词组成的短小组合,
它们作为概念或语法单位一起出现,
构成从句或句子的一个组成部分。
注: 这不应与法语词 phrase 混淆, 后者表示句子,而不是此处所用英语意义上的 phrase。 在日语中, 这对应于文節的概念。
每个检测到的词或短语的起始和结束位置 称为词 边界或短语 边界。 词边界和短语边界本身不可观察, 但 word-space-transform 或 word-break 等属性可以在这些位置产生可见效果。
检测词或短语 并放置其边界的具体算法取决于 UA, 并且可以考虑多种因素或方法, 例如 基于词典的词法分析、 标点或其他定界字符识别、 形态分析、 机器学习方法……
不过必须遵守以下约束:
- 用户代理不得在组成单个排版字符单位的字符之间 放置词边界或短语边界。
- 用户代理不得将词边界或短语边界 放置在任何断行类别为 GL、WJ 或 ZWJ 的字符旁边; 当两个本来会成为词或短语的序列由此类字符分隔时, 它们必须被视为一个整体。 [UAX14]
- 如果词或短语后面紧跟一个或多个以下字符, 用户代理必须认为它们是前一个词或短语的一部分:
-
标点本身不是短语: 它应附着到相邻语言性词或短语的相关一侧。 例如, 括号和引号等包围标点 是其包围短语的一部分; 逗号和分号后缀到前一个短语; U+00BF INVERTED QUESTION MARK 附着到后续词; 等等。
然而,标点的非常规使用, 例如笑脸、颜文字或 Perl 片段, 可能导致用户代理需要偏离此原则。
-
在确定词边界或短语边界时,
必须忽略内联盒边界
和脱离流元素。
然而,
如果在一个或多个内联盒边界所在的相同位置
找到了词或短语边界,
则该词或短语
边界必须插入到
参与该内联盒边界的最外层元素中。
在以下示例中, 红色“
|”表示 用户代理在检测词边界时放置它们的合理位置:
如果该句子包含一些内联标记, 以下示例展示了放置词边界的正确位置:กรุงเทพ|คือ|สวยงาม
以下示例展示了不正确的位置:กรุงเทพ|คือ|< em > สวยงาม</ em >
以下展示了一个更人为情形中的正确位置:กรุงเทพ|คือ< em > |สวยงาม</ em > กรุงเทพ|< b >< u > คือ</ u > |< em > สวยงาม</ em ></ b >
隐私考虑
本规范会泄露用户安装的连字符断字和断行词典。
安全考虑
本规范未引入新的安全考虑。
致谢
如果没有以下人员的帮助,本规范将不可能完成: Addison Phillips, Aharon Lanin, Alan Stearns, Ambrose Li, Arnold Schrijver, Arye Gittelman, Ayman Aldahleh, Ben Errez, Bert Bos, Chris Lilley, Chris Pratley, Chris Thrasher, Chris Wilson, Dave Hyatt, David Baron, Emilio Cobos Álvarez, Eric LeVine, Etan Wexler, Frank Tang, Håkon Wium Lie, IM Mincheol, Ian Hickson, James Clark, Javier Fernandez, John Daggett, Jonathan Kew, Ken Lunde, Laurie Anna Edlund, Marcin Sawicki, Martin Dürst, Martin Heijdra, Masafumi Yabe, Masayasu Ishikawa, Michael Jochimsen, Michel Suignard, Mike Bemford, Myles Maxfield, Nat McCully, Paul Nelson, Pierre-Anthony Lemieux, Rahul Sonnad, Randy Edmunds, Richard Ishida, Shinyu Murakami, Stephen Deach, Steve Zilles, Takao Suzuki, Tantek Çelik, Xidorn Quan, Yaniv Feinberg。
变更
本草案与 [CSS-TEXT-3]
保持同步,参见 CSS Text 3 §
变更。
第 4 级特有的变更列于下方。
自 2026 年 6 月 8 日 工作草案以来的重大变更包括:
-
将 avoid-orphans 重命名为 avoid-short-last-line。 (议题 11283)
-
明确了 text-autospace 对纯文本复制 & 粘贴没有影响。 (议题 8511)
-
明确了 hyphenate-limit-lines 和 hyphenate-limit-chars 仅接受非负 整数。 (议题 12517)
自 2024 年 5 月 29 日工作 草案以来的重大变更包括:
-
为 text-wrap-style 添加了 avoid-orphans。 (议题 10837)
-
将
listing、xmp和plaintext添加到默认 UA 样式表中被指定为 text-spacing: none 的元素列表中。 (议题 13369)
自 2024 年 2 月 19 日 工作草案以来的重大变更包括:
-
将 text-spacing-trim 的值 trim-auto 重命名为 trim-both。 (议题 10161)
-
对于行数较多的情况,放宽了 text-wrap-style: balance 不得改变行数的要求。 (议题 10186)
-
定义 text-wrap-style: balance 与 line-clamp 之间的交互 (议题 9310)
-
为 text-transform 添加 math-auto 值。 (议题 5386)
自 2023 年 10 月 20 日 工作草案以来的重大变更包括:
-
在 text-spacing-trim: space-first 的定义中, 恢复了被意外删除的“以及每个强制换行之后的行”。 (议题 9532)
-
将 normal 设为 text-spacing-trim 的初始值。 (议题 9511)
-
更改 space-first 的行末行为。 (议题 9736)
-
space-first 在换行之后应用。 (议题 9532)
-
明确全角标点折叠的细节。 (议题 9225)
-
通过用户代理样式规则,默认阻止 pre 继承 hanging-punctuation。 (议题 9689)
自 2023 年 3 月 29 日 工作草案以来的重大变更包括:
-
将 text-wrap 属性重构为两个新属性 text-wrap-mode 和 text-wrap-style 的简写属性, 并使 text-wrap-mode 而非 text-wrap 成为 white-space 属性的长写属性。
-
将 附录 G: 小假名映射更新至 Unicode 15.0。 (议题 8442)
-
重新设计 word-break: auto-phrase word-break: manual 特性 (此前曾尝试将其设计为独立的
word-boundary-detection属性), 并为 word-space-transform 添加 auto-phrase 值 (因为它不再能依赖word-boundary-detection)。 并更新相关的支持机制。 -
将
word-boundary-expansion重命名为 word-space-transform -
为 text-spacing-trim 添加 trim-all。 (议题 8482)
-
除 NBSP 之外不可定制的 Unicode 换行控制 优先于我们关于原子内联的规则。 (议题 8972)
自 2023 年 3 月 1 日 工作草案以来的重大变更包括:
-
通过以下方式完成将 white-space 拆分为多个 长写属性的转换:
-
向 white-space-collapse 添加 break-spaces,使所有 简写值都能由长写属性表示 (议题 8256)
-
将所有长写属性关键字整合到 white-space 简写属性中
-
相应更新说明文字
-
-
将 text-space-collapse 和 text-space-trim 重命名为 white-space-collapse 和 white-space-trim。 (议题 8273)
自 2022 年 12 月 31 日 工作草案以来的重大变更包括:
-
通过以下方式重新设计 text-spacing:
-
将 space-first 设为初始值 (议题 2462)
-
允许 hanging-punctuation 悬挂行首的 表意空格, 以补偿源自纯文本的源文本惯例。 (议题 2462)
-
将 no-compress 移至 text-justify,因为它控制的是两端对齐而非 间距。 (议题 7079)
-
扩展 text-spacing 中进行求值的上下文字符,使其包含
Pe和Ps类别中的字符。 (议题 6091) -
将 text-space-collapse 重新重命名为 white-space-collapse。 (议题 8273)
自 2022 年 5 月 5 日工作 草案以来的重大变更包括:
- 为 text-justify 添加 ruby 值。 (议题 771 议题 779)
- 将 text-spacing: normal 改为使用 trim-end 而不是 allow-end。 (议题 7055)
- 将 text-spacing: normal 改为同时应用 ideograph-alpha 和 ideograph-numeric, 更新 UA 默认样式表以在等宽上下文中排除这些值, 规定非零 margin/border/padding 会阻止插入间距, 并将插入的间距量定义为 0.125ic。 (议题 6950)
- 为了简化实现,规定 text-align: match-parent 在根元素上计算为 start。 (议题 6542)
- 允许 distribute 关键字作为旧值别名 或直接计算为 inter-character; 这允许 UA 采用更容易实现的方式,因为这种区别对 向后兼容性没有影响。 (议题 7322)
- 为与其他值保持一致,将 white-space-trim 的 trim-inner 值重命名为 discard-inner。 (议题 448)
自 2019 年工作 草案以来的重大变更包括:
- 整合 [CSS-TEXT-3] 的完整文本。
- 为 word-spacing 和 letter-spacing 添加百分比,以表示相对于当前 font-size 的尺寸。 (议题 2165)
- 建议添加一条 UA 规则,以防止
textarea中的空格被折叠。 (议题 6309)
Level 3 以来的新增内容
Level 4 中的新特性:
-
word-break: auto-phrase,用于自动确定 在换行时应保持在一起的短语
-
word-space-transform,用于转换单词 分隔符
-
将 white-space 属性拆分为多个长写属性:
-
white-space-trim,用于修整元素边界处多余的空白
-
text-wrap-mode,用于控制是否 进行换行
-
text-wrap-style 及其 balance、stable 和 pretty 值
-
wrap-before、wrap-after 和 wrap-inside,用于避免或强制换行(类似于用于分页的 break-* 属性)
-
hyphenate-character,用于显式控制 断字符
-
hyphenate-limit-zone、hyphenate-limit-chars、hyphenate-limit-lines、hyphenate-limit-last,用于更好地控制 自动断字
-
<string> 值用于 text-align,以便按例如小数点进行对齐
-
text-group-align,用于对一组其内容通过 text-align 对齐的行 框进行组对齐
-
line-padding,用于在行的开头/结尾处 在内联框内插入间距
-
text-spacing,用于在标点符号周围以及 书写系统发生变化的位置自动添加间距